Para transcribir un MP3 a texto gratis, lo más preciso en nuestra prueba fue Whisper, el reconocedor de voz libre de OpenAI, instalado en tu propio ordenador: abre el MP3 directamente, funciona sin conexión y el archivo no sale de tu equipo. Su modelo por defecto, turbo, falló menos de 2 de cada 100 palabras en audiolibros en inglés y en alemán. El español todavía no lo hemos medido. Word «Transcribir» también acepta MP3, pero solo con Microsoft 365, y Notas de Voz del iPhone transcribe lo que grabas con ella; importar un archivo no aparece en su ayuda.
¿Qué opción te sirve para tu MP3?
Lo primero es saber quién acepta un archivo. Esto es lo que dicen las páginas de ayuda de cada herramienta:
| Herramienta | ¿Abre un MP3? | Condiciones | Dónde se procesa |
|---|---|---|---|
| Whisper | Sí | Gratis; hay que instalarlo | En tu ordenador |
| Word «Transcribir» | Sí, y también WAV, MP4 y M4A | Microsoft 365; hasta 300 minutos al mes | En Microsoft |
| Notas de Voz y Notas (iPhone) | No consta | Solo lo que grabas en la app; iPhone 12 o posterior | La ayuda no lo indica |
| ChatGPT | Sí | Solo planes de pago; hasta 512 MB | En OpenAI |
| Fireflies | Sí, y también M4A y WAV | Con cuenta; hasta 150 minutos por archivo | En Estados Unidos por defecto |
| Dictado de Google Docs, Windows y Mac | No | Solo micrófono en directo | Depende del servicio |
En resumen: si el MP3 no debe salir de tu ordenador, usa Whisper, mejor con un programa con ventanas como noScribe o aTrain; si ya pagas Microsoft 365, Word; si todavía vas a grabar con el iPhone, Notas de Voz; para un audio corto sin datos personales, una web gratuita. Si el audio es un vídeo de YouTube, quizá ya exista la transcripción: mira cómo transcribir un vídeo de YouTube. Y si solo necesitas los acuerdos, redacta mejor un acta de reunión.
Nuestra prueba: qué medimos y qué falta
Tomamos seis audiolibros de dominio público de LibriVox, tres en inglés y tres en alemán, leídos cada uno por una persona distinta. Los transcribimos con ocho motores gratuitos en un portátil corriente y comparamos el resultado, palabra por palabra, con el texto impreso del libro, sacado del Project Gutenberg.
- Las grabaciones: el comienzo de tres cuentos de O. Henry (1906) y tres relatos completos de Franz Kafka del libro «Ein Landarzt» (1919-1920): 17 minutos y 39 segundos y algo más de 2600 palabras en total.
- Los motores: Whisper en seis tamaños (tiny, base, small, medium, turbo y large-v3), con los ajustes del comando
whispery el idioma indicado, y Vosk, otro reconocedor libre sin conexión, con su modelo pequeño y su modelo grande para cada idioma. - La medida: la tasa de error por palabra, es decir, cuántas de cada 100 palabras del libro salen mal, faltan o sobran. No cuentan las mayúsculas, la puntuación ni la forma de escribir los números.
- El equipo: un portátil con procesador AMD Ryzen 7 de 8 núcleos, 32 GB de memoria y Windows 11, y para comparar, su tarjeta gráfica Nvidia RTX 4050 de 6 GB.
- El control: como los modelos podrían haber «oído» esas grabaciones antiguas durante su entrenamiento, repetimos la prueba con cinco lecturas publicadas por LibriVox en otoño de 2025.
Además, un audiolibro es el caso más fácil: una voz, buen micrófono y ninguna interrupción. Una entrevista o una reunión darán más errores.
Resultados en inglés y en alemán
- turbo, el modelo que usa el comando
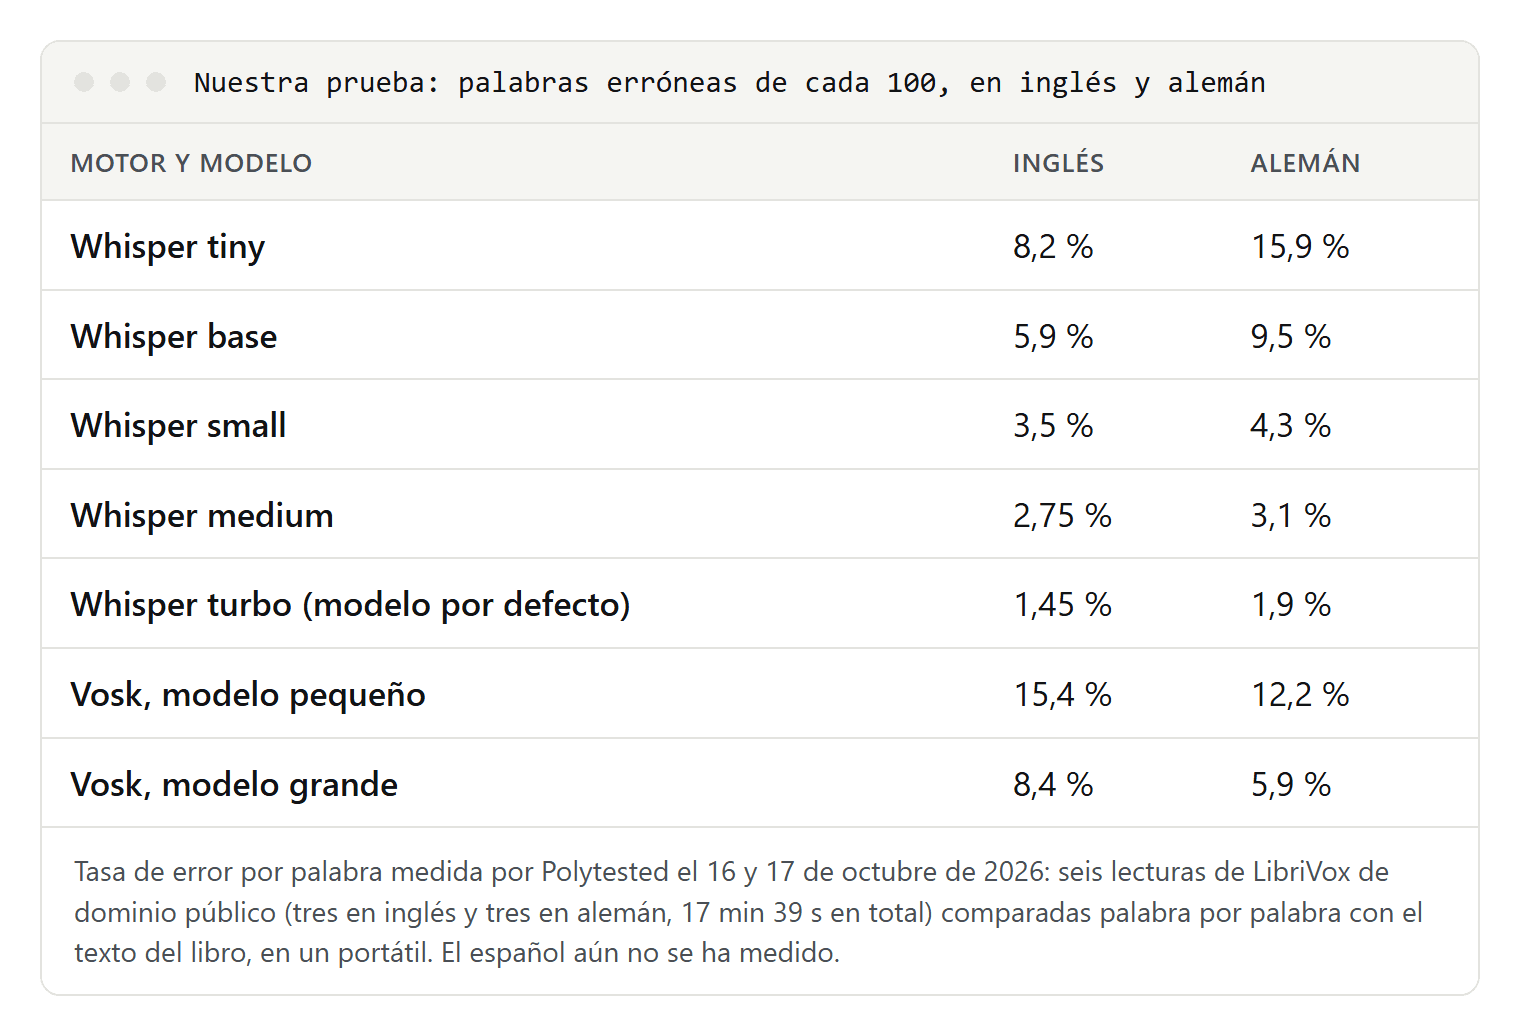
whispersi no eliges otro, falló el 1,45 por ciento de las palabras en inglés (18 de 1238) y el 1,9 por ciento en alemán. - medium quedó en 2,75 y 3,1 por ciento; small, en 3,5 y 4,3; base, en 5,9 y 9,5, y tiny, en 8,2 y 15,9 por ciento.
- Vosk logró 8,4 y 5,9 por ciento con sus modelos grandes y 15,4 y 12,2 con los pequeños. Escribe todo en minúsculas y sin puntuación.
- large-v3, el modelo más grande, solo lo probamos con dos fragmentos porque en un portátil es muy lento. No mejoró a turbo.
En las lecturas de 2025, turbo se quedó en el 1,0 por ciento en inglés y el 1,3 por ciento en alemán, con el mismo orden entre modelos. Los resultados no se deben, por tanto, a grabaciones antiguas que los modelos ya conocieran.
Para quien transcribe en español, lo más útil es la diferencia entre idiomas. Los modelos pequeños pierden mucho más en alemán que en inglés: tiny comete casi el doble de errores. A partir de small, la diferencia baja de un punto. Un estudio del centro CISPA que comparó once servicios de transcripción con entrevistas en alemán y en inglés apunta en la misma dirección: la mayoría funcionó mejor en inglés y Whisper fue el mejor servicio de IA, con datos de diciembre de 2022. La propia documentación de Whisper advierte de que su rendimiento varía mucho según el idioma. Cuánto acierta en español, de momento no lo sabemos.
Vosk sí publica cifras propias para el español: entre un 6 y un 10 por ciento de error para su modelo grande (1,4 GB), según el juego de pruebas. Son mediciones del fabricante y no se comparan con las nuestras: para su modelo grande de alemán indica entre un 10 y un 33 por ciento, y ese modelo se quedó en el 5,9 por ciento con nuestros audiolibros.
Para saber cómo le va a una herramienta con tu español, haz esta prueba:
- Escribe a mano, palabra por palabra, dos minutos representativos de tu MP3.
- Pasa ese mismo fragmento por la herramienta.
- Cuenta las palabras mal escritas, las que faltan y las que sobran, sin fijarte en mayúsculas ni puntuación.
- Divide ese número entre las palabras de tu texto y multiplica por 100.
¿Cuánto tarda en un portátil normal?
En el procesador, sin tarjeta gráfica, nuestro portátil necesitó por cada hora de audio unos 40 minutos de cálculo con turbo (39 en inglés, 42 en alemán) y 33 o 34 con small, que comete más del doble de errores. base tardó entre 13 y 15 minutos y tiny, 6 o 7; medium, unas dos horas, y large-v3, más de tres. Vosk fue el más rápido: entre 2 y 3 minutos con el modelo pequeño.
Con la tarjeta gráfica, turbo bajó a 8 o 9 minutos por hora de audio; large-v3 no cabía en sus 6 GB. La primera vez se descarga el modelo: 75 MB tiny y 1,62 GB turbo. Son tiempos de una sola pasada, con un margen de una décima parte, y según la documentación de Whisper la velocidad real depende también del idioma.
Lo que falló en nuestras pruebas
- Todo en minúsculas y sin puntuación. Así devolvió turbo 9 de nuestros 11 fragmentos, y large-v3 hizo lo mismo en sus dos fragmentos; de tiny a medium salían frases normales. Una frase neutra y bien puntuada pasada con la opción
--initial_promptlo arregló, pero turbo se inventó entonces palabras al final de 4 de los 6 fragmentos en inglés. - Palabras inventadas en el silencio. large-v3 añadió «you you» y «die die die die» tras la última frase de dos fragmentos. La ficha del modelo Whisper avisa de que puede escribir texto que nadie ha dicho.
- Un bucle. Con un cuento entero de catorce minutos y medio, el modelo base, llamado con los ajustes básicos de su biblioteca de Python, devolvió 47 veces la línea «CHAPTER II.» y nada más. Con los ajustes por defecto del comando
whisper, lo transcribió entero. - Los nombres propios. Ningún sistema escribió bien todas las veces «Odradek», el nombre que inventó Kafka. Vosk lo convirtió en «deck» o algo parecido: solo conoce las palabras de su vocabulario.
Conclusión: deja los ajustes por defecto, indica el idioma (sin él, tiny tomó una lectura en inglés por afrikáans), recorta los silencios largos, lee el final y comprueba que la longitud del texto encaja con la duración.
Whisper en tu ordenador: programas gratis y línea de comandos
El código y los modelos de Whisper se publican con licencia MIT, y el español está entre sus idiomas. Varios programas gratuitos le ponen ventanas. No los hemos instalado; los datos vienen de sus páginas de proyecto:
- noScribe, de Kai Dröge, es gratuito y libre (GPL-3.0), funciona por completo en local en Windows, macOS y Linux, distingue hablantes, entiende unos 60 idiomas e incluye un editor para corregir. Su web oficial, noscribe.de, está también en español. Su autor avisa de que un servicio de pago con un dominio .ai no tiene nada que ver con el proyecto.
- aTrain, de la Universidad de Graz, transcribe sin conexión, no envía ni grabaciones ni transcripciones a internet, admite 99 idiomas, entre ellos el español, y genera archivos para MAXQDA, ATLAS.ti y NVivo. En Windows se instala desde Microsoft Store.
- Buzz y Vibe también trabajan sin conexión y exportan, entre otros, TXT, SRT y VTT.
En cualquiera de ellos, elige turbo si tu ordenador puede con él, o small si no, y el idioma español en lugar de la detección automática. Cómo usar noScribe y aTrain con entrevistas lo explicamos en la guía para transcribir entrevistas.
Si prefieres la línea de comandos, instala Python y ffmpeg (la documentación de Whisper menciona Chocolatey o Scoop en Windows y Homebrew en Mac). El MP3 no hace falta convertirlo:
pip install -U openai-whisper
whisper grabacion.mp3 --model turbo --language Spanish --output_format txt
Si no pones --output_format, Whisper genera cinco archivos: TXT, SRT, VTT, TSV y JSON. Para quitar las marcas de tiempo de un SRT, mira cómo convertir un SRT a TXT. Los modelos que terminan en .en son solo para inglés. Según la ayuda del comando, --condition_on_previous_text False hace menos probables los bucles.
No lo confundas: el 26 de agosto de 2026, OpenAI anunció que sus modelos de transcripción de pago, entre ellos whisper-1, dejarán su API el 26 de febrero de 2027. El modelo libre que usas en tu ordenador no se ve afectado.
Word «Transcribir»: MP3 con Microsoft 365
No hemos probado Word; esto sale de la ayuda de Microsoft. Ve a Inicio, Dictar, Transcripción y, en el panel, elige «Cargar audio».
- Suscripción: con Microsoft 365 puedes transcribir hasta 300 minutos de audio cargado al mes.
- Dónde funciona: en Word para la Web con el nuevo Microsoft Edge o con Chrome y, en escritorio, por ahora solo en Word para Microsoft 365 en Windows en inquilinos comerciales, siempre con internet.
- Resultado: hablantes como «Orador 1» y «Orador 2», marcas de tiempo en las que puedes hacer clic y el botón «Agregar todo al documento». Cada documento guarda una sola transcripción.
- Idiomas: más de 80 configuraciones regionales, entre ellas 21 variantes del español, de España, México, Argentina, Colombia o Estados Unidos, entre otras.
- Almacenamiento: la grabación se guarda en la carpeta «Archivos transcritos» de tu OneDrive hasta que la borres.
Sobre los datos, Microsoft escribe: «Sus archivos de audio se envían a Microsoft y se utilizan únicamente para proporcionarle este servicio». Una vez hecha la transcripción, su servicio no guarda ni el audio ni el resultado. Las marcas de tiempo de Word y de otras herramientas se explican en nuestra guía de la transcripción con marcas de tiempo.
iPhone: Notas de Voz y Notas
Tampoco lo hemos probado; los datos son de la ayuda de Apple. En un iPhone 12 o posterior, Notas de Voz (en la carpeta Utilidades) transcribe lo que grabas, en directo o después. Apple incluye el español entre diez idiomas y advierte de que la función no está disponible en todos los países o regiones.
- Notas de Voz: toca la grabación y elige «Ver transcripción» para copiar una parte o «Copiar transcripción» para el texto entero.
- Notas: dentro de una nota, toca «Grabar audio»; la transcripción aparece si el idioma del dispositivo es uno de los compatibles. Después puedes elegir «Añadir transcripción a la nota» o «Copiar transcripción». Las llamadas grabadas con Teléfono o FaceTime también se transcriben en Notas, desde iOS 18.1.
Ninguna de las dos páginas explica cómo importar un MP3 que ya tienes. Para eso, usa Whisper en un ordenador.
Webs gratuitas, ChatGPT, Descript y Fireflies
Las webs gratuitas reciben el MP3 en el navegador. En las páginas que leímos para nuestras versiones en inglés y alemán, «gratis» significaba un máximo de minutos por archivo o al mes, pocos archivos al día y a veces solo una vista previa sin cuenta. Prometían entre un 90 y un 99,9 por ciento de precisión sin explicar nunca cómo lo medían. Antes de subir nada, busca dónde se procesa el archivo, si se usa para entrenar modelos y cuándo se borra.
Tres servicios con cuenta, que no hemos probado, según sus páginas de ayuda:
- ChatGPT solo admite archivos de audio en los planes de pago, hasta 512 MB, en MP3, M4A, WAV y otros formatos. OpenAI avisa de que las transcripciones pueden tener errores, de que la atribución de hablantes puede fallar y de que el rendimiento varía según el idioma.
- Descript transcribe 26 idiomas con alfabeto latino; en su lista, el español figura como «Spanish (US)». Solo admite un idioma por archivo, y la detección de muletillas solo funciona en inglés. Procesa y guarda los datos en Estados Unidos y puede usarlos para entrenar sus modelos de IA.
- Fireflies acepta MP3, M4A, WAV, MP4 y WEBM, hasta 150 minutos por archivo, y el idioma lo eliges al subirlo. Por defecto guarda y procesa los datos en Estados Unidos; con el almacenamiento privado del plan Enterprise los guarda en la UE, pero los sigue procesando en Estados Unidos.
Dictado: Google Docs, Windows y Mac no abren un MP3
Estas funciones gratuitas escriben lo que dices al micrófono, en directo, pero no abren archivos:
- Google Docs: Herramientas, luego «Escribir por voz», en Chrome, Edge o Safari. Admite el español de España, de México, de Latinoamérica y de otros países, y el navegador controla el servicio de transcripción de voz. Los comandos para editar solo funcionan en inglés.
- Windows + H: la escritura por voz usa el reconocimiento de voz en línea de los servicios de voz de Azure y necesita internet. En español admite solo «Español (España)» y «Español (México)».
- Dictado en el Mac: se detiene solo tras 30 segundos sin voz. En los ajustes del teclado puedes ver si tus dictados se procesan en el dispositivo, sin pasar por los servidores de Siri, y compartir las grabaciones con Apple es opcional.
Sirven cuando hablas tú, por ejemplo para dictar tus apuntes justo después de una reunión.
Privacidad: ¿adónde va tu MP3?
Con Whisper, Vosk, noScribe o aTrain, el archivo se queda en tu ordenador. Word lo envía a Microsoft; Descript y Fireflies, a Estados Unidos (Fireflies, por defecto); en ChatGPT, el uso de los datos depende del plan y de los ajustes. Las páginas de ayuda de Notas de Voz y Notas no dicen dónde se hace la transcripción.
Una grabación de voz es un dato personal según el RGPD. Si una web transcribe por ti, actúa como encargada del tratamiento, y la Agencia Española de Protección de Datos (AEPD) recuerda que esa relación debe formalizarse en un contrato. En un artículo del 20 de abril de 2026, la AEPD añade que una transcripción puede atribuir a alguien algo que no dijo y que por eso hace falta supervisión humana. La ficha del modelo Whisper desaconseja transcribir grabaciones de personas hechas sin su consentimiento; el permiso para grabar lo tratamos en la guía para transcribir entrevistas. Esto se refiere a España; en Latinoamérica rigen las leyes de cada país. No es asesoramiento jurídico.
Lista de comprobación antes de dar el texto por bueno
- Fija el idioma: «Spanish» en Whisper o Español en tu programa, nada de detección automática.
- Prueba antes con dos minutos y calcula la tasa de error, como te explicamos arriba.
- Compara la longitud del texto con la duración del MP3 y busca líneas repetidas.
- Lee las últimas líneas: en el silencio final aparecen palabras que nadie dijo.
- Revisa nombres, cifras y términos técnicos, donde se concentraron los errores en nuestra prueba.
- Mira mayúsculas y puntuación: si todo sale en minúsculas, prueba medium o small.
- Unifica los números: según el modelo, las cantidades salían en cifras o en letra.
- Escucha el audio mientras lees, sobre todo si hablan varias personas o hay ruido.
