Audio transkribierst du kostenlos und ohne Upload am besten mit Whisper, der quelloffenen Spracherkennung von OpenAI, auf deinem eigenen Rechner, zum Beispiel in einem Programm wie noScribe oder aTrain. In unserem Test mit drei deutschen Hörbuchaufnahmen schrieb das Modell turbo knapp 2 von 100 Wörtern falsch (1,9 Prozent), das kleinste Modell tiny 16. „Transkribieren“ in Word gibt es nur mit Microsoft 365, die Sprachmemos auf dem iPhone transkribieren nur Aufnahmen, die du dort machst, und Online-Dienste haben Limits. Wir zeigen, wie genau und wie schnell acht kostenlose Programme auf Deutsch waren, welche Fehler typisch sind und wohin deine Aufnahme bei welchem Weg geht.
Welcher Weg passt zu deiner Aufnahme?
Kläre vorher zwei Fragen: Hast du schon eine Datei, oder willst du live sprechen? Und darf die Aufnahme deinen Rechner verlassen?
- Eine Datei, und Datenschutz ist dir wichtig: Nimm Whisper lokal, am einfachsten in einem Programm mit Oberfläche wie noScribe, aTrain oder Buzz. Nach dem einmaligen Download des Modells läuft alles offline.
- Du hast schon Microsoft 365: „Transkribieren“ in Word nimmt WAV, MP4, M4A und MP3 an, bis zu 300 Minuten im Monat. Die Datei geht dafür an Microsoft.
- Du nimmst gerade erst auf, mit dem iPhone: Die Apps Sprachmemos und Notizen transkribieren Aufnahmen, die du in ihnen machst, auch auf Deutsch.
- Du willst sprechen statt tippen: Das ist Diktieren, nicht Transkribieren. Google Docs, Windows und macOS können das, aber keine dieser Funktionen nimmt eine fertige Datei an.
- Dein Rechner ist alt oder schwach: Nimm ein kleineres Whisper-Modell wie small, oder Vosk, das mit einem nur 45 MB großen deutschen Modell sehr schnell rechnet, allerdings ohne Satzzeichen.
- Das Audio ist ein YouTube-Video: Dann gibt es oft schon ein Transkript. Wie du es findest und sauber kopierst, steht in unserem Ratgeber YouTube-Transkript.
- Du brauchst nur die Ergebnisse, nicht jedes Wort: Dann schreib besser ein Besprechungsprotokoll.
Unser Test: drei Kafka-Erzählungen, acht kostenlose Programme
Keine der 17 deutschsprachigen Anleitungen, die wir zu diesem Thema gelesen haben, hat eine deutsche Aufnahme mit einem bekannten Text verglichen. Deshalb haben wir selbst gemessen: Wir haben sechs gemeinfreie Hörbuchaufnahmen von LibriVox, drei auf Deutsch und drei auf Englisch, jeweils von einer anderen Person gelesen, mit acht kostenlosen Spracherkennungen auf einem normalen Laptop transkribieren lassen und die Fehler Wort für Wort mit dem Buchtext von Project Gutenberg verglichen.
- Die Aufnahmen: drei Erzählungen aus Franz Kafkas Band „Ein Landarzt“ (1919/20), nämlich „Vor dem Gesetz“, „Die Sorge des Hausvaters“ und „Eine kaiserliche Botschaft“, zusammen 9 Minuten 46 Sekunden und 1.374 Wörter. Zum Vergleich drei englische Erzählungen von O. Henry, zusammen knapp acht Minuten. LibriVox nimmt nur Texte auf, die in den USA gemeinfrei sind, und gibt auch die Aufnahmen gemeinfrei heraus.
- Die Programme: Whisper in sechs Größen (tiny, base, small, medium, turbo, large-v3) mit denselben Einstellungen wie der Befehl
whisperund vorgegebener Sprache, dazu Vosk mit seinem kleinen und seinem großen deutschen Modell. Alle laufen offline und kosten nichts. - Der Rechner: ein Laptop mit AMD Ryzen 7, acht Kernen und 32 GB Arbeitsspeicher unter Windows 11. Gerechnet haben wir auf dem Prozessor und zum Vergleich auf der eingebauten Grafikkarte, einer Nvidia RTX 4050 mit 6 GB.
- Die Wortfehlerrate: wie viele von 100 Wörtern des Buchs falsch sind, fehlen oder zu viel sind. Groß- und Kleinschreibung, Satzzeichen und die Schreibweise von Zahlen zählen nicht. Alte Schreibweisen wie „daß“ oder „sehn“ haben wir auf heutige Rechtschreibung gesetzt, und Zusammen- oder Getrenntschreibung („beiseite tritt“, „beiseitetritt“) gilt nicht als Fehler.
- Die Kontrolle: Vielleicht haben die Modelle die alten LibriVox-Dateien beim Training schon „gehört“. Deshalb haben wir den Test mit fünf Lesungen wiederholt, die erst im Herbst 2025 bei LibriVox erschienen sind und deshalb mit geringerer Wahrscheinlichkeit in den Trainingsdaten stecken. Auf Deutsch waren das zwei Erzählungen von Hermann Löns aus dem LibriVox-Adventskalender 2025.
Ergebnis: So genau transkribieren die Modelle Deutsch
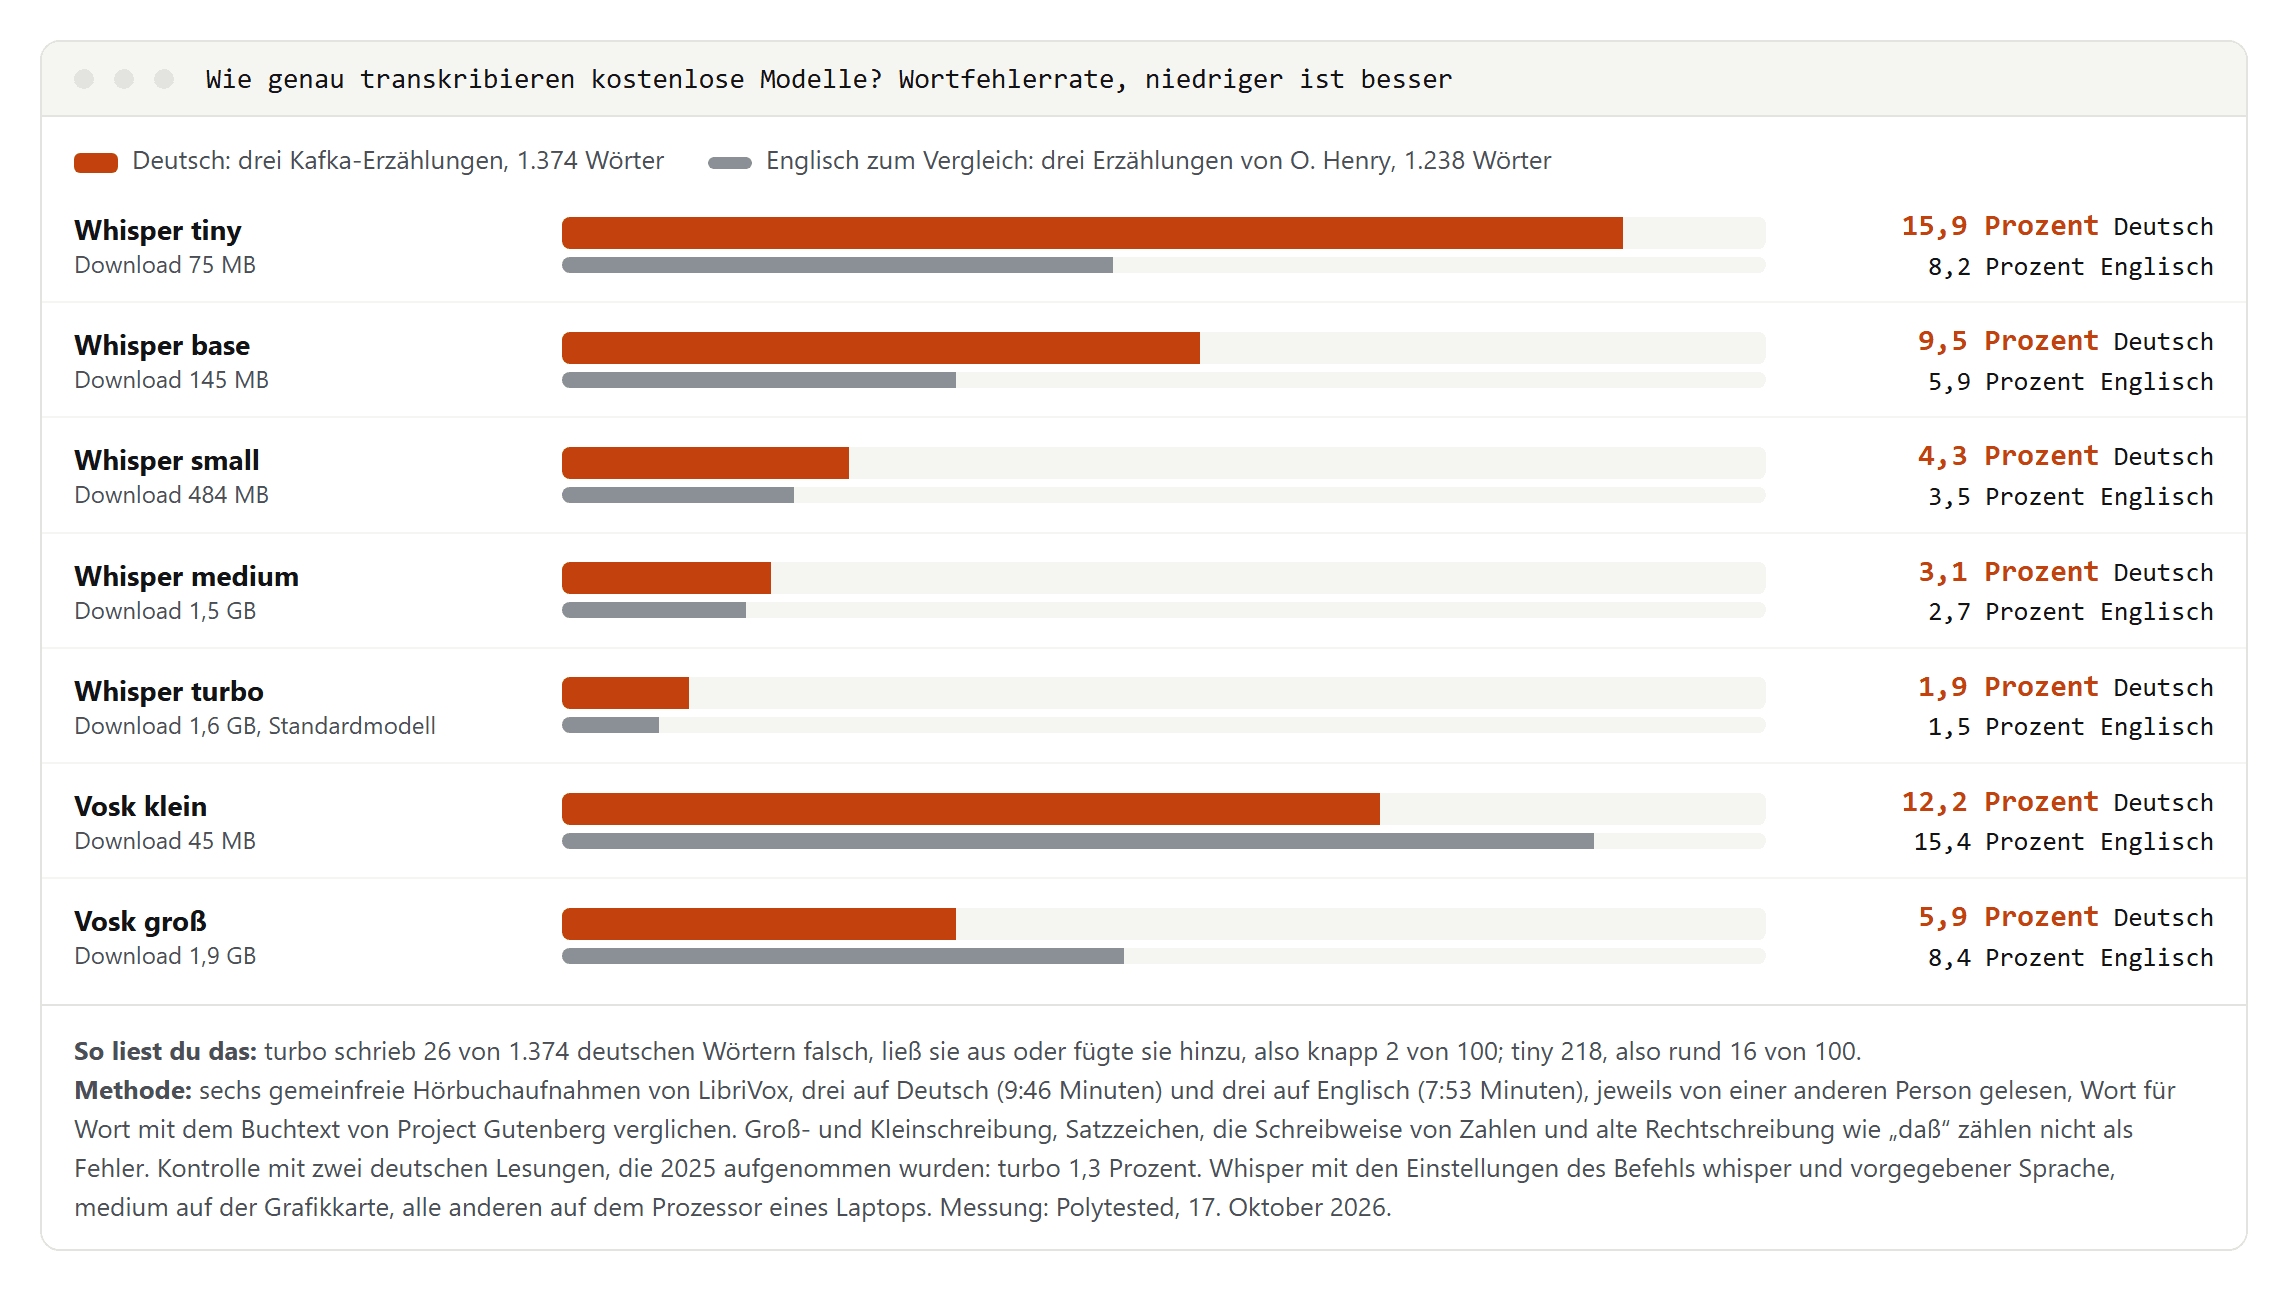
Je größer das Modell, desto weniger Fehler:
- turbo, das Standardmodell des Befehls
whisper: 26 Fehler bei 1.374 Wörtern, also 1,9 Prozent. - medium kam auf 3,1 Prozent, small auf 4,3, base auf 9,5 und tiny auf 15,9 Prozent. Bei tiny ist etwa jedes sechste Wort falsch.
- Vosk schaffte mit dem großen deutschen Modell 5,9 Prozent und war damit besser als Whisper base; das kleine Vosk-Modell kam auf 12,2 Prozent.
- large-v3, das größte Modell, haben wir wegen der langen Rechenzeit nur an „Eine kaiserliche Botschaft“ getestet: 2,8 Prozent, turbo auf derselben Aufnahme 1,9. Größer war hier nicht genauer.
Deutsch kostet die kleinen Modelle viel mehr als die großen. tiny machte auf Deutsch fast doppelt so viele Fehler wie auf Englisch (15,9 gegen 8,2 Prozent), base 9,5 gegen 5,9. Ab small lag der Unterschied unter einem Prozentpunkt; turbo kam auf Englisch auf 1,5 Prozent. Das passt zu einer Studie des CISPA Helmholtz-Zentrums für Informationssicherheit, die elf Transkriptionsdienste mit rund zehnminütigen deutschen und englischen Interviews verglichen hat: Die meisten kamen mit Englisch besser zurecht, und Whisper war das beste KI-System. Die Daten stammen allerdings vom Dezember 2022, wie die Forschenden selbst betonen.
Die Kontrollaufnahmen von 2025 bestätigten das Bild: turbo kam dort auf Deutsch auf 1,3 und auf Englisch auf 1,0 Prozent, und die Rangfolge der Modelle blieb gleich. Die Ergebnisse sind also kein Effekt alter, bekannter Hörbücher. Nicht ausschließen können wir, dass die Modelle die Buchtexte kennen, denn die stehen im Netz.
Ein Teil der Fehler geht gar nicht auf die Software zurück. An zwölf Stellen schrieben turbo, medium und das große Vosk-Modell übereinstimmend etwas anderes als das Buch, etwa „Manchmal frage ich mich“ statt „Vergeblich frage ich mich“ oder „Türsteher“ statt „Türhüter“. Wahrscheinlich wurde dort so gelesen; nachgehört haben wir das nicht. Zählt man diese Stellen als richtig, kommt turbo auf etwa 1 Prozent.
Odradek, Komposita, Großschreibung: typische Fehler auf Deutsch
Die Fehlerquote sagt nicht, wo die Fehler sitzen. In unseren Transkripten häuften sie sich an wenigen Stellen:
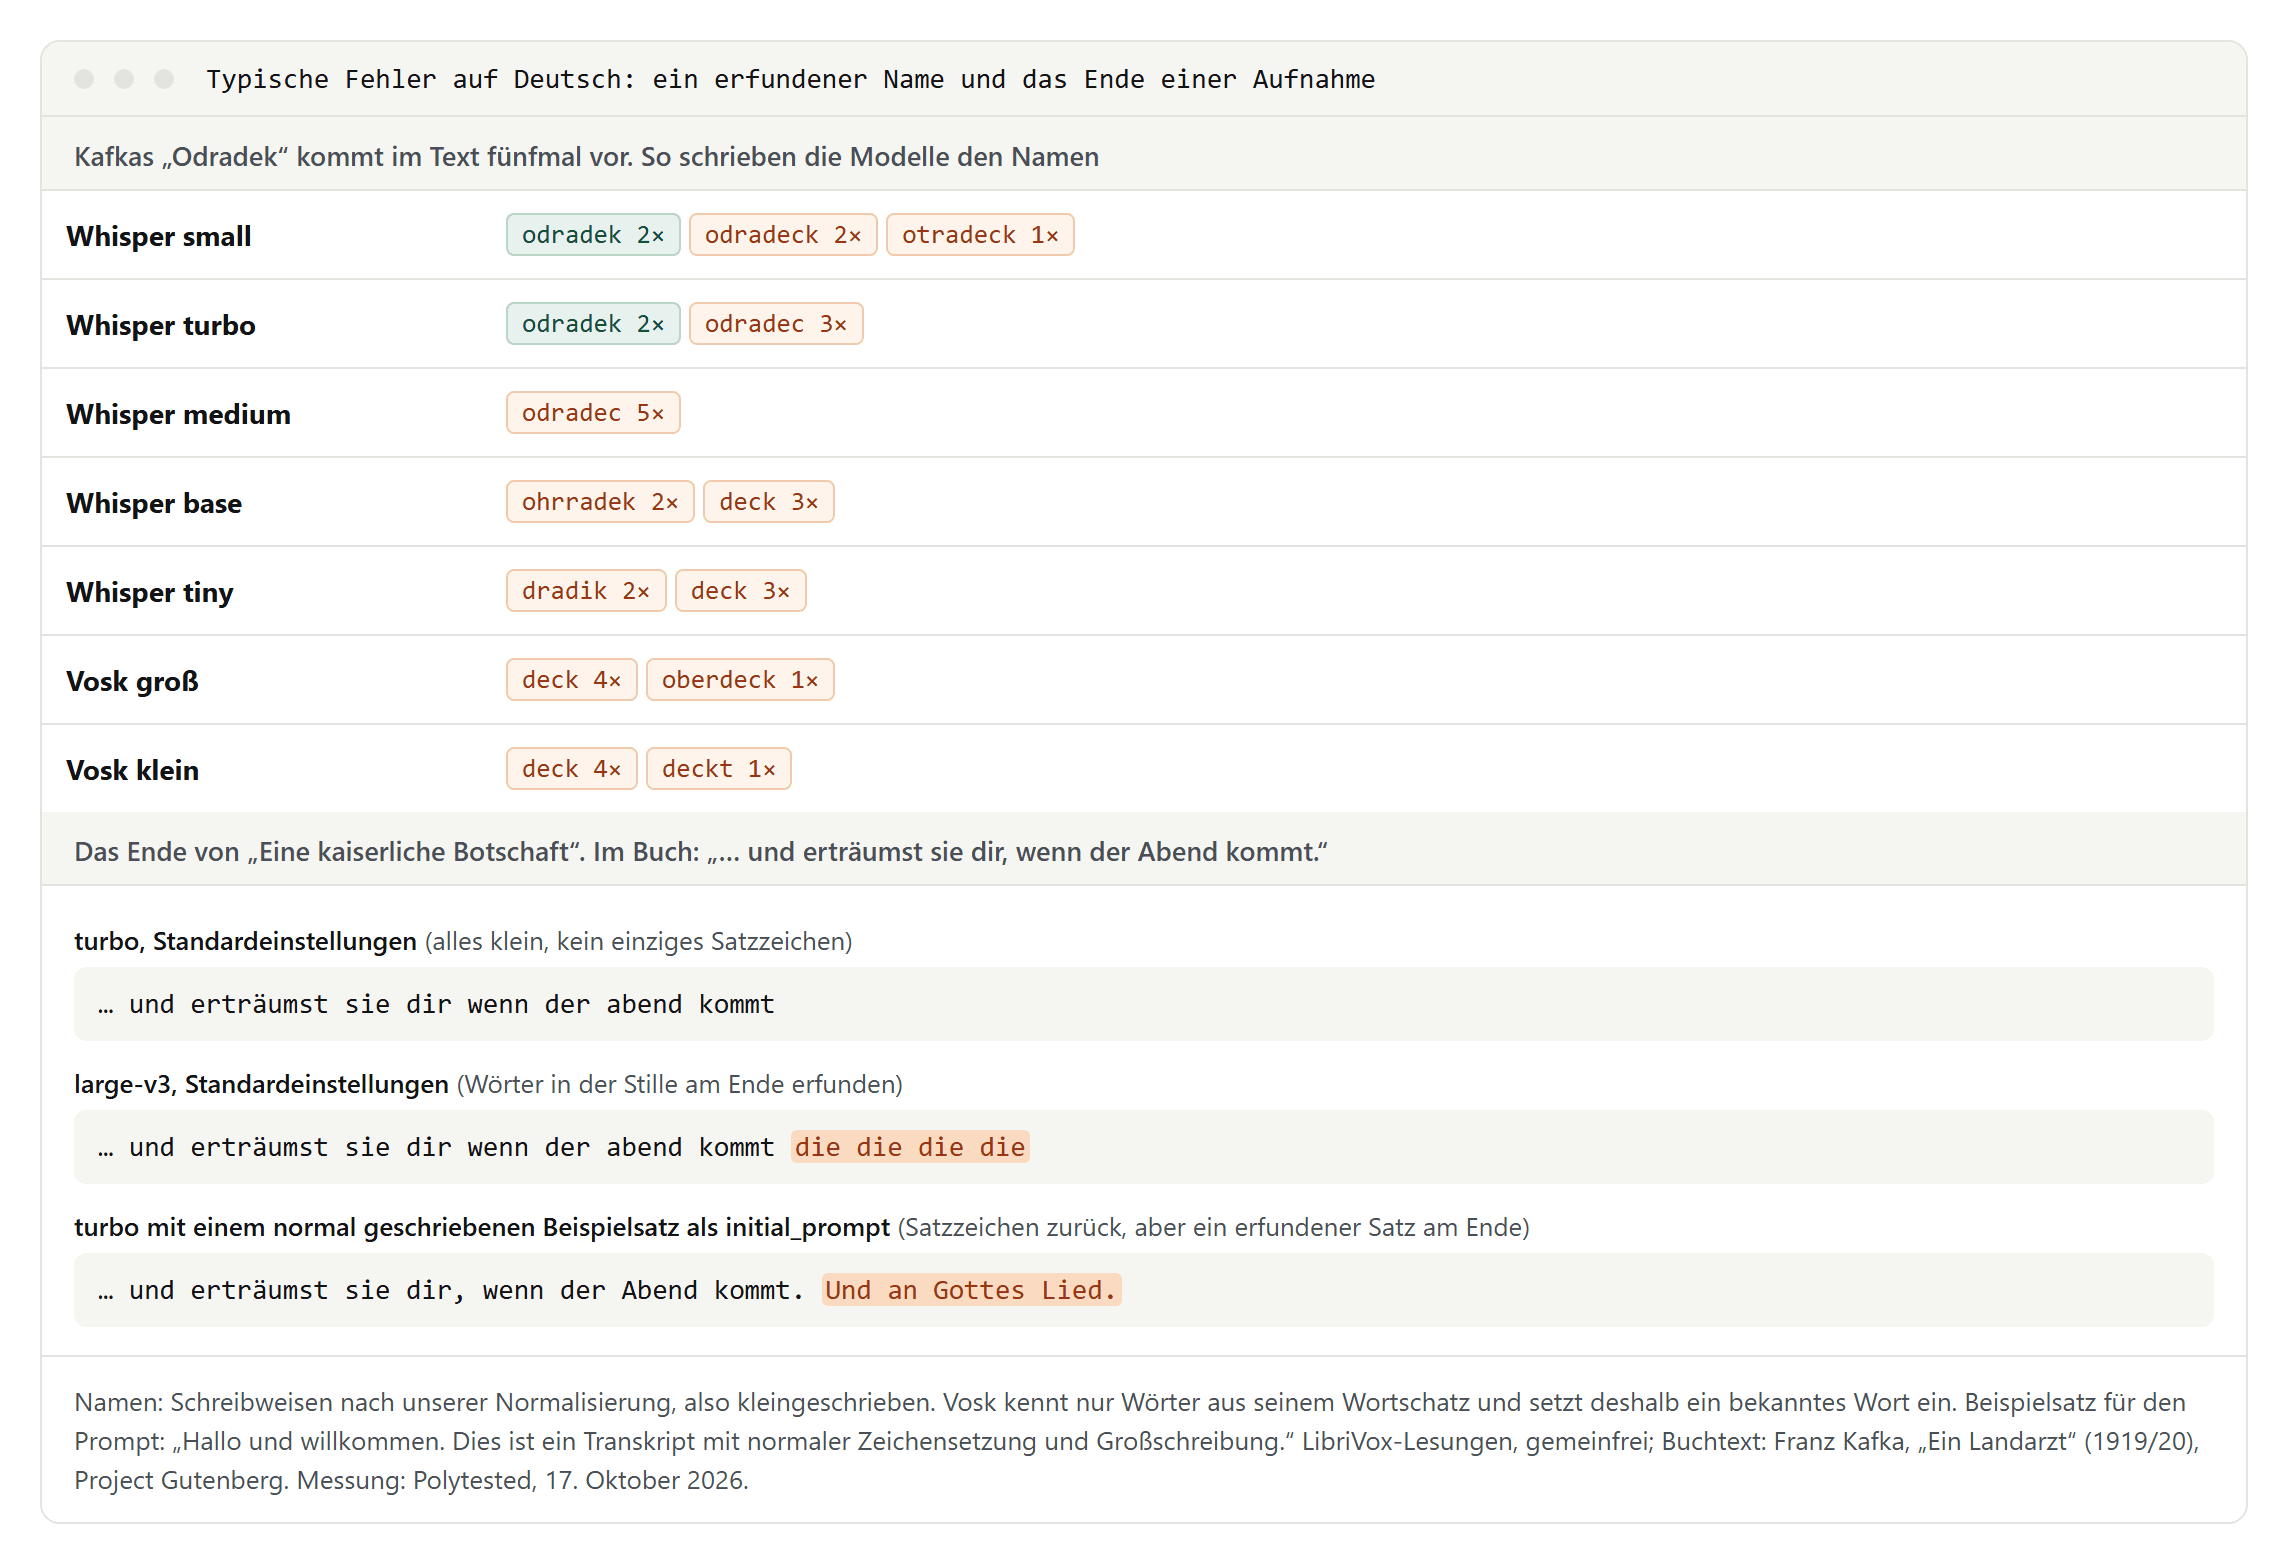
- Namen und erfundene Wörter: In „Die Sorge des Hausvaters“ kommt fünfmal der Name „Odradek“ vor, den Kafka erfunden hat. Kein Programm schrieb ihn jedes Mal richtig: small und turbo trafen ihn zweimal, medium schrieb fünfmal „Odradec“, base und tiny machten „Ohrradek“, „Dradik“ oder „Deck“ daraus. Vosk schrieb jedes Mal „deck“ oder ein ähnliches Wort, denn es kennt nur die Wörter seines festen Wortschatzes.
- Seltene und gleich klingende Wörter: Aus Kafkas „verfitzte“ wurde in unseren Durchläufen auch „verfilzte“, aus „tatarischen“ „tartarischen“. Das „wiedersagen“ des Buchs schrieben turbo, medium und das große Vosk-Modell als „widersagen“, das gleich klingt, aber etwas anderes bedeutet. Solche Stellen findest du nur beim Gegenlesen.
- Zusammen oder getrennt: small schrieb an sieben Stellen anders zusammen oder getrennt als das Buch, turbo an zwei, etwa bei „offensteht“ und „offen steht“. Wir haben das nicht als Fehler gezählt, prüfen musst du es trotzdem.
- Großschreibung: small und medium schrieben fast 98 von 100 richtig erkannten Wörtern genauso groß oder klein wie das Buch. Die Abweichungen betrafen fast nur Satzanfänge in wörtlicher Rede, kaum Nomen. Vosk schreibt alles klein, und auch turbo lieferte bei uns kleingeschriebenen Text (nächster Abschnitt).
- „daß“ statt „dass“: turbo schrieb an allen sieben Stellen, an denen das Buch „daß“ hat, ebenfalls „daß“, also in alter Rechtschreibung. tiny, base und small schrieben „dass“.
Kleinschreibung, Schleifen, erfundene Wörter: was in unseren Läufen schiefging
Drei Probleme bildet keine Fehlerquote gut ab. Wir beschreiben sie so, wie wir sie gesehen haben; ob sie bei dir auftreten, hängt von Aufnahme, Modell und Einstellungen ab.
- Alles klein, kein einziges Satzzeichen: turbo lieferte bei allen sechs Hörbuchaufnahmen und bei drei der fünf Kontrollaufnahmen nur kleingeschriebene Wörter ohne Punkt und Komma, auf Deutsch wie auf Englisch. large-v3 tat dasselbe bei beiden Aufnahmen, die wir damit gerechnet haben. tiny bis medium schrieben normale Sätze. Für einen lesbaren deutschen Text ist das ein Problem, denn jedes Nomen ist dann klein.
- Die Abhilfe und ihr Haken: Mit der Option
--initial_promptgibst du Whisper einen Text vor, an dem es sich am Anfang orientiert. Wir haben einen neutralen Satz eingesetzt: „Hallo und willkommen. Dies ist ein Transkript mit normaler Zeichensetzung und Großschreibung.“ Damit kamen Großschreibung und Satzzeichen in allen elf Aufnahmen zurück, und turbo schrieb „dass“ statt „daß“. Die Fehlerquote auf Deutsch blieb fast gleich: 1,7 statt 1,9 Prozent bei Kafka, 1,7 statt 1,3 Prozent bei den Kontrollaufnahmen. Aber an „Eine kaiserliche Botschaft“ hängte turbo einen erfundenen Satz an: „Und an Gottes Lied.“ Auf Englisch erfand turbo mit Prompt am Ende von vier der sechs Aufnahmen Wörter, bei den drei Hauptaufnahmen stieg die Fehlerquote von 1,4 auf 4,0 Prozent. Mit Prompt musst du das Ende also besonders genau lesen. - Erfundene Wörter in der Stille: Auch ohne Prompt hängte large-v3 an eine englische Aufnahme „you you“ an und an „Eine kaiserliche Botschaft“ nach dem letzten Satz „die die die die“, mit Zeitangaben nach dem Ende der Aufnahme. Die Modellkarte von Whisper warnt selbst, dass das Modell Text ausgeben kann, der nie gesprochen wurde, und zu Wiederholungen neigt.
- Die Wiederholungsschleife: Bei der ganzen englischen Hörbuchdatei von „The Gift of the Magi“, 14,5 Minuten lang, lieferte Whisper base mit den Grundeinstellungen der Python-Bibliothek (ohne Beam Search, mit Zeitangaben pro Wort) 47-mal die Zeile „CHAPTER II.“ und sonst nichts: 94 Wörter statt rund 2.100. Mit den Standardeinstellungen des Befehls
whisperkam dasselbe Modell auf 2.098 Wörter, small und turbo gerieten in keiner Einstellung in eine Schleife. Laut Hilfe des Befehls macht--condition_on_previous_text Falsesolche Schleifen unwahrscheinlicher.
Daraus folgen drei Regeln: Bleib bei den Standardeinstellungen des Befehls oder deines Programms, gib die Sprache vor, und prüfe, ob das Transkript ungefähr so lang ist wie erwartet. Lange Stille am Ende schneidest du am besten vorher ab.
Wie lange es dauert: Rechenzeit auf einem normalen Laptop
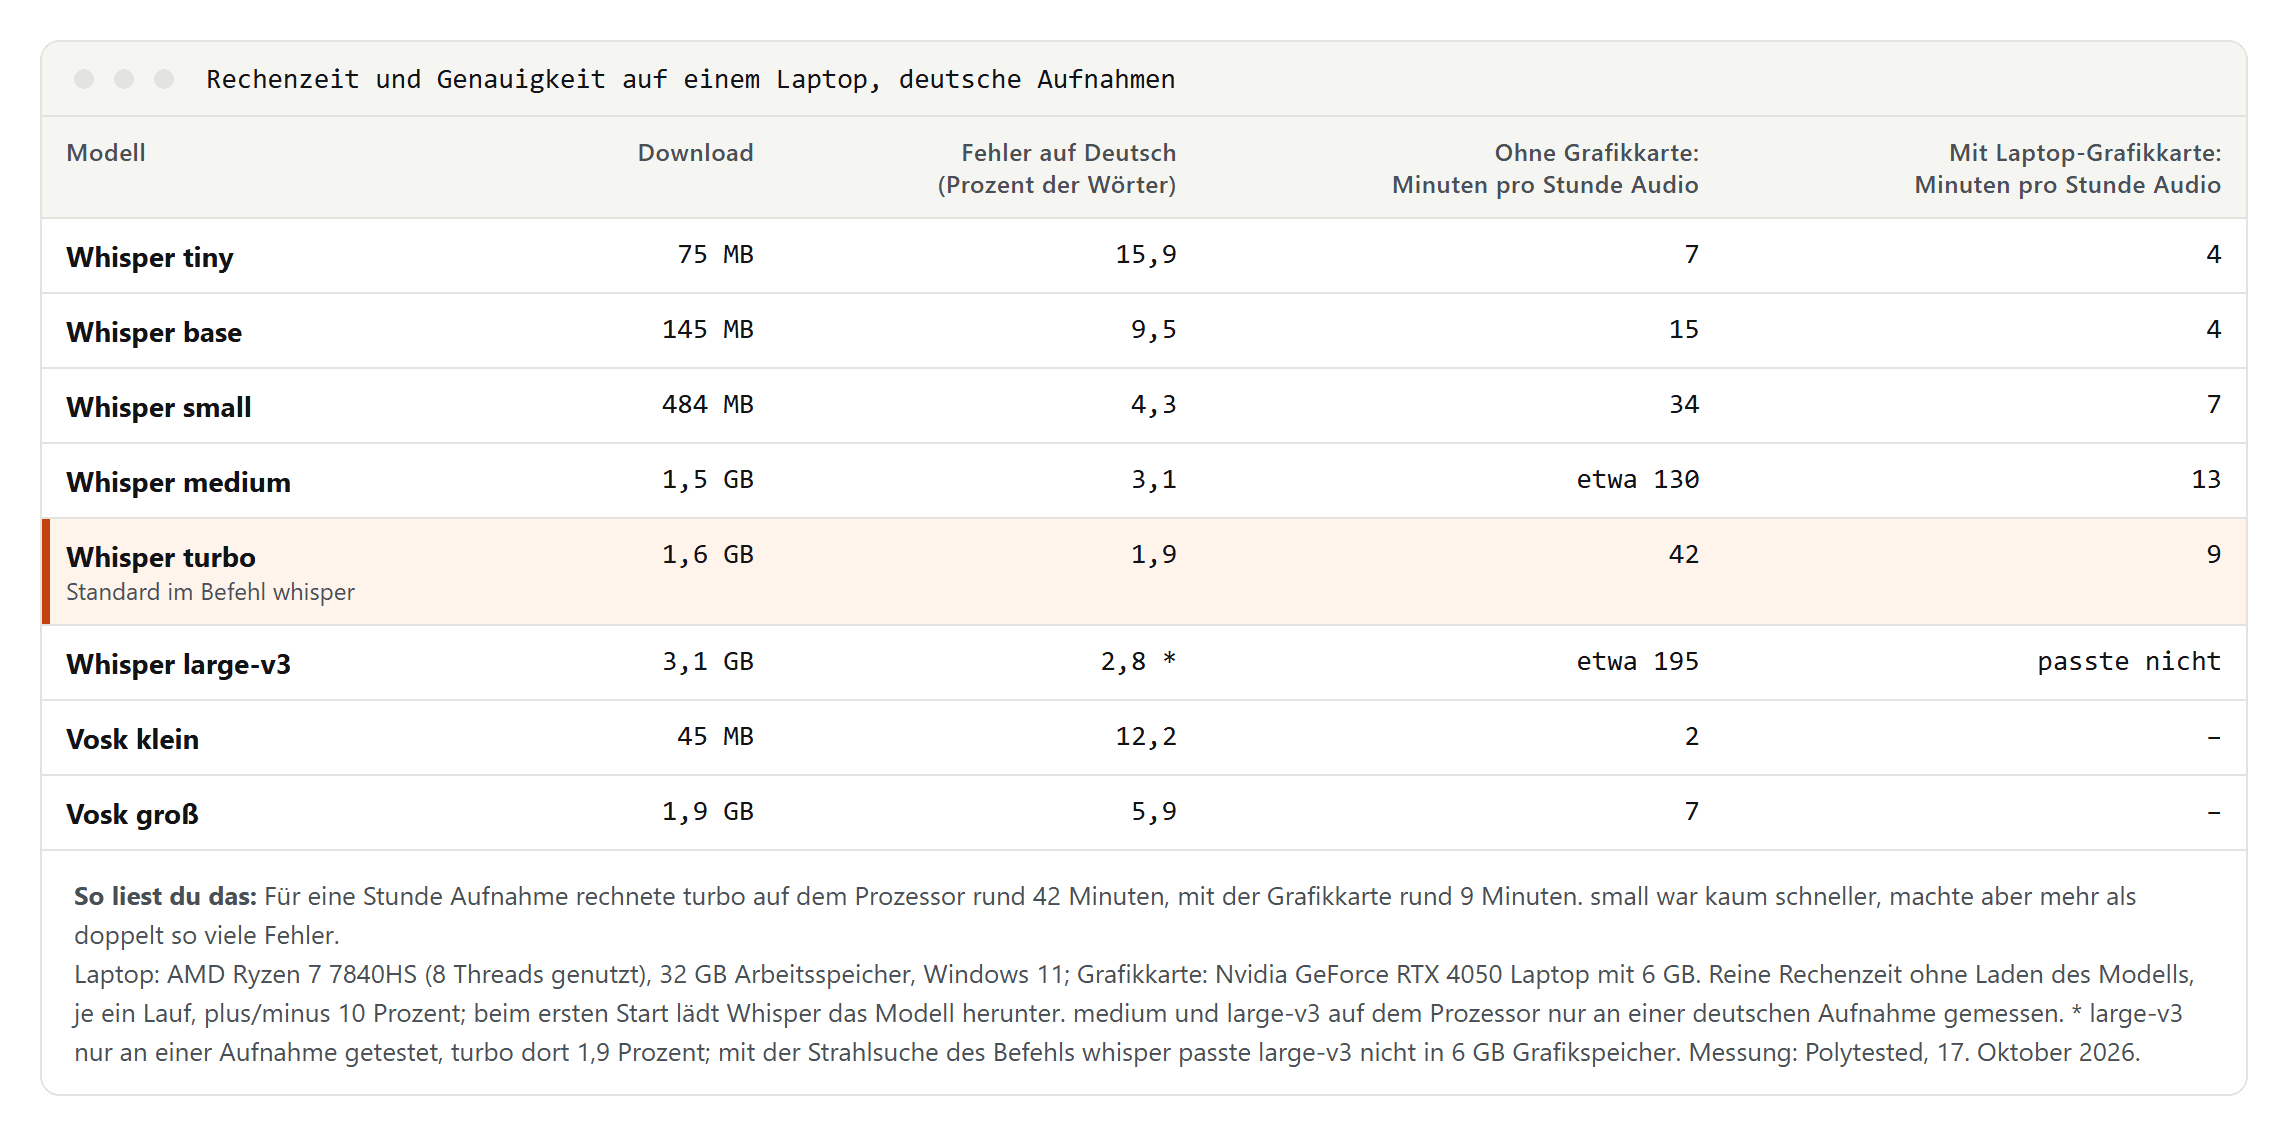
Auf dem Prozessor, ohne Grafikkarte, brauchte turbo für eine Stunde deutsche Aufnahme rund 42 Minuten, small 34, base 15 und tiny 7. medium brauchte gut zwei Stunden pro Stunde Audio, large-v3 mehr als drei. Mit der Laptop-Grafikkarte schaffte turbo eine Stunde in rund 9 Minuten.
turbo ist auf dem Prozessor also nur wenig langsamer als small, macht aber weniger als halb so viele Fehler. Es ist nicht ohne Grund das Standardmodell. small oder base lohnen sich bei wenig Speicher: Laut Whisper-Dokumentation braucht turbo auf der Grafikkarte etwa 6 GB, small etwa 2 GB, base und tiny etwa 1 GB. large-v3 passte mit den Standardeinstellungen nicht in die 6 GB unserer Grafikkarte.
Rechne beim ersten Start den Download dazu: turbo ist 1,6 GB groß, tiny nur 75 MB. Unsere Zeiten sind Einzelläufe und können um etwa ein Zehntel schwanken. aTrain nennt auf seiner Projektseite für einfache Gaming-Laptops mit Nvidia-Grafikkarte etwa 20 Prozent der Aufnahmedauer; turbo brauchte bei uns mit Grafikkarte 13 bis 15 Prozent.
Hintergrundgeräusche und Telefonqualität
Um zu sehen, was eine schlechtere Aufnahme ausmacht, haben wir dieselben Kafka-Lesungen zweimal verändert: mit künstlich beigemischtem Rauschen, deutlich hörbar, aber leiser als die Stimme, und beschnitten auf das schmale Frequenzband einer Telefonleitung.
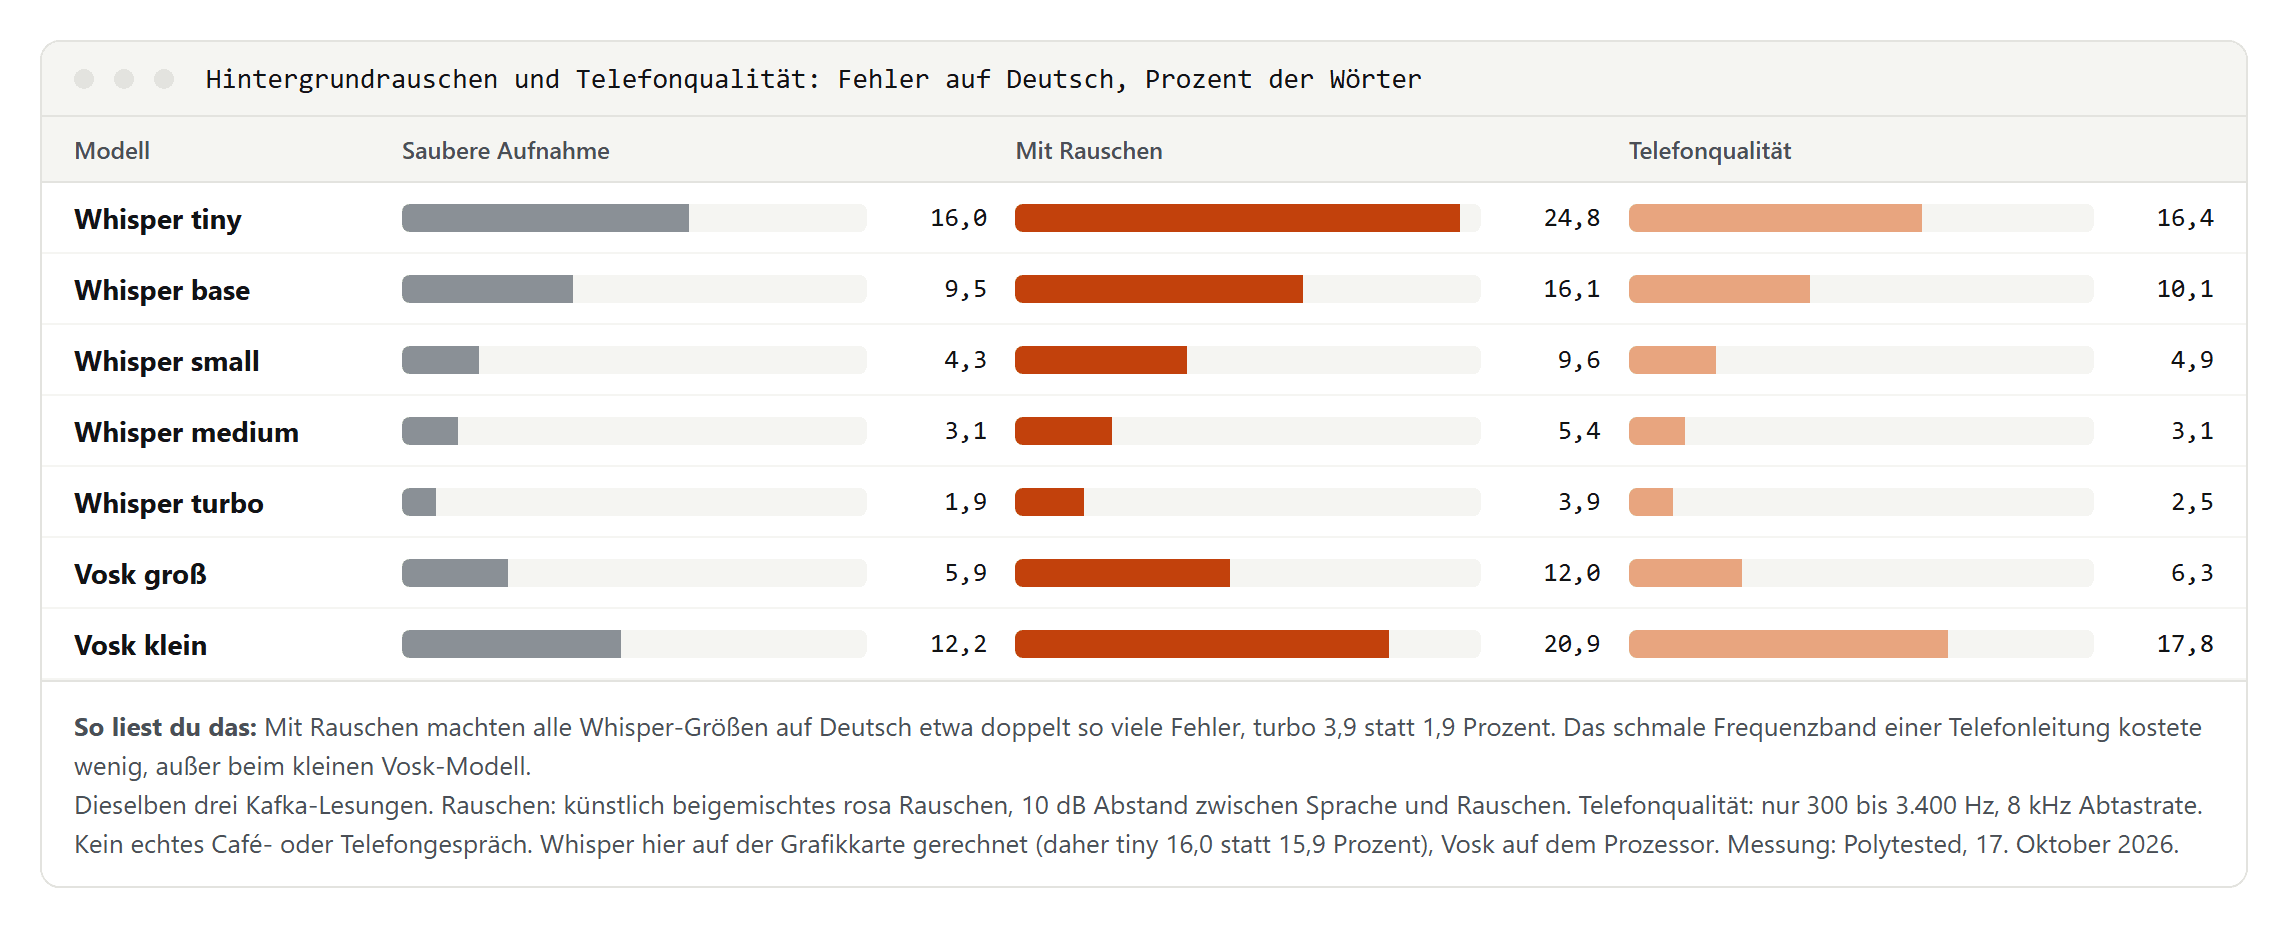
- Rauschen traf alle Modelle. Bei turbo stieg die Fehlerquote auf Deutsch von 1,9 auf 3,9 Prozent, bei small von 4,3 auf 9,6, beim großen Vosk-Modell von 5,9 auf 12,0 Prozent, jeweils etwa auf das Doppelte.
- Auf Englisch fiel der Anstieg bei Whisper kleiner aus: turbo von 1,4 auf 2,3 Prozent, small von 3,6 auf 5,2 (auf der Grafikkarte gerechnet, daher leicht andere Ausgangswerte). Deutsch litt unter dem Rauschen stärker.
- Telefonqualität kostete wenig: turbo kam auf 2,5 Prozent, small auf 4,9. Nur das kleine Vosk-Modell fiel deutlich ab, von 12,2 auf 17,8 Prozent.
Halte also das Mikrofon nah an den Mund und vermeide Nebengeräusche. Ist die Aufnahme schon verrauscht, nimm das größte Modell, das dein Rechner schafft. Unser Rauschen ist künstlich; ein echtes Café mit Stimmen im Hintergrund kann sich anders auswirken.
Schweiz, Österreich und Dialekte
Wir haben nur gelesenes Hochdeutsch getestet. Für Schweizerdeutsch, österreichische Mundarten und andere Dialekte fanden wir keine gemeinfreien Aufnahmen mit passendem Referenztext. Die Modellkarte von Whisper warnt, dass die Genauigkeit je nach Sprache, Akzent und Dialekt schwankt. Teste bei Mundart zuerst ein kurzes Stück.
Zwei Dinge betreffen auch Hochdeutsch:
- ß und ss: Whisper schrieb in unseren Transkripten rund 20-mal „ß“ auf knapp 1.400 Wörter, turbo wegen „daß“ sogar über 30-mal. In der Schweiz schreibt man ss; ersetze ß dort mit Suchen und Ersetzen.
- Sprachauswahl: „Transkribieren“ in Word bietet Deutsch laut Microsoft nur als „Deutsch (Deutschland)“ an, eine österreichische oder Schweizer Variante gibt es dort nicht.
Whisper ohne Kommandozeile: noScribe, aTrain, Buzz und Vibe
Whisper selbst ist ein Werkzeug für die Kommandozeile. Mehrere kostenlose Programme legen eine Oberfläche darum. Wir haben sie nicht installiert; die Angaben stammen von ihren Projektseiten.
- noScribe von Kai Dröge ist kostenlos und quelloffen (GPL-3.0), läuft unter Windows, macOS und Linux komplett lokal, trennt Sprecher, kennt rund 60 Sprachen und hat einen Editor zum Korrigieren. Laut Projektseite gehört eine ähnlich lautende Adresse mit der Endung .ai zu einem fremden Bezahldienst; lade noScribe nur von noscribe.de oder GitHub.
- aTrain von der Universität Graz transkribiert offline mit faster-whisper, erkennt Sprecher und liefert Dateien für MAXQDA, ATLAS.ti und NVivo. Für Windows gibt es aTrain im Microsoft Store, für Macs mit Apple-Chip und für Debian als Beta.
- Buzz transkribiert offline Dateien, YouTube-Links und das Mikrofon, erkennt Sprecher und speichert TXT, SRT und VTT. Die Windows-Version ist nicht signiert, deshalb zeigt Windows eine Warnung. Neue Mac-Versionen gibt es nur für Apple-Chips.
- Vibe arbeitet offline, verarbeitet mehrere Dateien am Stück und speichert unter anderem SRT, VTT, TXT, PDF und DOCX.
Stell in jedem Programm das Modell ein, also turbo, wenn dein Rechner es schafft, und die Sprache Deutsch statt automatischer Erkennung. Bei unseren Kafka-Lesungen erkannten alle Whisper-Modelle die Sprache zwar richtig, in den Kontrollaufnahmen hielt tiny eine englische Lesung aber für Afrikaans.
Ältere Anleitungen empfehlen ein Whisper-Plugin für Audacity. Die Downloadseite von Audacity warnt derzeit, dass diese OpenVINO-Plugins mit der neuesten Audacity-Version noch nicht kompatibel sind. Wie du noScribe und aTrain für Interviews einsetzt, steht in unserem Ratgeber Interview transkribieren.
Whisper in der Eingabeaufforderung
Wenn dich eine Kommandozeile nicht abschreckt, ist das offizielle Whisper-Paket der direkteste Weg. Code und Modelle stehen unter der MIT-Lizenz.
- Voraussetzungen: Python und ffmpeg, ein Programm, das Audiodateien einliest. Die Whisper-Dokumentation nennt dafür unter Windows die Paketmanager Chocolatey und Scoop, auf dem Mac Homebrew.
- Installieren:
pip install -U openai-whisper - Transkribieren:
whisper aufnahme.mp3 --model turbo --language German --output_format txt
Ohne --model nimmt Whisper ohnehin turbo. Ohne --output_format schreibt es fünf Dateien: TXT, SRT, VTT, TSV und JSON. Die TXT-Datei enthält nur den Text, SRT und VTT haben Zeitangaben. Wie du aus SRT wieder reinen Text machst, zeigt unser Ratgeber SRT in Text umwandeln.
--initial_prompt "Odradek, Türhüter"gibt dem Modell Namen und Fachbegriffe vor. Die Option ist dokumentiert, mit Namen haben wir sie aber nicht getestet. Lies wegen des Nebeneffekts oben das Ende genau.--condition_on_previous_text Falsemacht laut Hilfe Wiederholungsschleifen unwahrscheinlicher.- Modelle mit der Endung
.ensind nur für Englisch; für Deutsch nimmst du die Modelle ohne Endung.
Nicht verwechseln: OpenAI hat am 26. August 2026 angekündigt, die kostenpflichtigen Transkriptionsmodelle seiner Programmierschnittstelle, darunter whisper-1, am 26. Februar 2027 abzuschalten. Das freie Whisper-Modell auf deinem Rechner und die Programme, die darauf aufbauen, betrifft das nicht.
Vosk: wenn der Rechner schwach ist
Vosk ist eine andere freie Spracherkennung; die Modelle stehen unter der Apache-2.0-Lizenz. Das kleine deutsche Modell ist nur 45 MB groß und rechnete eine Stunde Audio auf unserem Laptop in rund 2 Minuten, das große mit 1,9 GB in rund 7 Minuten. Das große kam auf 5,9 Prozent Fehler, besser als Whisper base und nicht weit hinter small. Trotzdem ist Vosk ein Werkzeug für Sonderfälle:
- Kein lesbarer Text: Vosk schreibt alles klein und setzt kein einziges Satzzeichen.
- Fester Wortschatz: Was nicht darin steht, kann Vosk nicht schreiben. Aus „Odradek“ wurde jedes Mal „deck“ oder ein ähnliches Wort.
- Lange Komposita: In den Kontrollaufnahmen mit Löns' Wörtern wie „muttermauseseelenallein“ und „Machangelbüschen“ stieg die Fehlerquote des großen Modells von 5,9 auf 9,9 Prozent, die des kleinen von 12,2 auf 18,1. turbo kam dort auf 1,3 Prozent.
Vosk selbst nennt für sein großes deutsches Modell 9,83 Prozent Fehler auf dem Testdatensatz Tuda-de und 24,00 Prozent bei Podcasts. Bei Gesprächen musst du also mit deutlich mehr Fehlern rechnen als bei unseren Hörbüchern. Sinnvoll ist Vosk auf alten Rechnern oder wenn du viele Aufnahmen schnell nach Stichworten durchsuchen willst.
Word „Transkribieren“ und iPhone-Sprachmemos
Beide Wege haben wir nicht getestet, denn sie brauchen ein Abo oder ein bestimmtes Gerät. Die Angaben stammen aus den Hilfeseiten von Microsoft und Apple.
Word transkribiert nur mit einem Microsoft-365-Abonnement, bis zu 300 Minuten hochgeladener Audiodateien pro Monat, über „Start“, „Diktieren“, „Transkribieren“ und „Audio hochladen“. Am Desktop geht das derzeit nur in Word für Microsoft 365 unter Windows in kommerziellen Mandanten, im Browser nur in Edge und Chrome. Die Aufnahme landet in OneDrive im Ordner „Transkribierte Dateien“. Microsoft schreibt: „Ihre Audiodateien werden an Microsoft gesendet und nur verwendet, um Ihnen diesen Dienst bereitzustellen.“ Nach der Transkription speichert der Dienst laut Microsoft weder Audio noch Ergebnis; die Kopie in deinem OneDrive bleibt, bis du sie löschst. Sprecher und Zeitstempel in Word erklärt unser Ratgeber Transkript mit Zeitmarken.
Die Sprachmemos transkribieren Aufnahmen ab dem iPhone 12, auf Deutsch, Englisch und einigen weiteren Sprachen, aber nicht in allen Ländern und Regionen. Das Transkript siehst du live oder später; mit „Transkript kopieren“ holst du den Text heraus. Aufnahmen aus iOS 17 oder früher transkribiert die App beim Öffnen, und die Suche durchsucht auch die Transkripte. In der App Notizen kannst du ebenfalls aufnehmen und live transkribieren lassen, dort landen auch Transkripte von Telefonaten; frag die anderen vorher. Eine Datei aus einer anderen Quelle zu importieren, beschreibt keine der beiden Hilfeseiten.
Diktieren ist nicht Transkribieren
Manche Anleitungen nennen die Spracheingabe von Google Docs oder Windows als Weg, Audio zu transkribieren. Laut den Herstellern hören diese Funktionen aber nur auf dein Mikrofon; eine Datei hochladen kannst du nicht.
- Google Docs: „Tools“, dann „Spracheingabe“, in aktuellen Versionen von Chrome, Edge und Safari. Der Browser steuert den Spracherkennungsdienst und schickt den Text an Docs. Satzzeichen sprichst du auf Deutsch mit „Punkt“, „Komma“ oder „Neuer Absatz“; Sprachbefehle zum Bearbeiten gibt es nur auf Englisch.
- Windows-Taste + H: Die Spracheingabe nutzt die Online-Spracherkennung der Azure-Sprachdienste und braucht Internet, ein Mikrofon und einen Cursor in einem Textfeld; „Deutsch (Deutschland)“ wird unterstützt.
- Diktieren am Mac: Erkennt der Mac 30 Sekunden lang keine Sprache, stoppt das Diktat. In den Tastatureinstellungen siehst du, ob Audio und Transkript auf dem Gerät verarbeitet werden. Sonst gehen sie laut Apple an Apple-Server, werden aber nicht gespeichert, solange du nicht in „Siri & Diktierfunktion verbessern“ eingewilligt hast.
Nützlich sind diese Funktionen, wenn du selbst sprichst, etwa um nach einem Gespräch deine Notizen festzuhalten.
Online-Dienste, ChatGPT, Descript und Fireflies
Kostenlose Online-Dienste nehmen deine Datei im Browser an. „Kostenlos“ heißt meist: eine Höchstdauer pro Datei, wenige Dateien pro Tag oder Minuten pro Monat, und ohne Konto manchmal nur eine Vorschau. Viele werben mit 90 bis 99,9 Prozent Genauigkeit, ohne zu sagen, wie sie das gemessen haben; eine Vergleichsseite schreibt selbst, dass sie kein nachvollziehbares Testprotokoll hat. Such vor dem Hochladen drei Antworten: Wo wird die Datei verarbeitet? Wird sie zum Training genutzt? Wann wird sie gelöscht? Findest du keine, lade dort keine fremden Stimmen hoch.
Drei Dienste mit Konto haben wir nicht getestet; das steht in ihren Hilfeseiten:
- ChatGPT nimmt Audiodateien nur in Bezahlplänen an, bis 512 MB, etwa MP3, M4A, WAV und FLAC. Laut OpenAI können Transkripte Fehler enthalten, die Sprecherzuordnung unzuverlässig sein und die Leistung je nach Sprache schwanken. Der Aufnahmemodus „Record“ läuft nur in Bezahlplänen und in der Mac-App, bis vier Stunden, und am besten auf Englisch; bei Plus und Pro können Transkripte zum Training genutzt werden, wenn die Einstellung zur Modellverbesserung an ist. Datenspeicherung in Europa gibt es nur für geeignete neue Enterprise- und Edu-Kunden und die Programmierschnittstelle.
- Descript transkribiert 26 Sprachen, darunter Deutsch, aber nur eine Sprache pro Datei. Füllwörter erkennt es nur auf Englisch. Laut Datenschutzerklärung verarbeitet und speichert Descript die Daten in den USA und darf sie auch zum Training seiner KI-Modelle nutzen.
- Fireflies nimmt MP3, M4A, WAV, MP4 und WEBM an, jede Datei bis 150 Minuten; die Sprache wählst du beim Hochladen. Gespeichert und verarbeitet wird standardmäßig in den USA. Mit „Private storage“ im Enterprise-Plan liegen die Daten in der EU, verarbeitet werden sie weiterhin in den USA. Kundendaten nutzt Fireflies laut eigener Angabe nicht zum KI-Training.
Descript und Fireflies haben kostenlose Pläne mit begrenztem Umfang und Bezahlpläne.
Datenschutz: Wohin geht deine Aufnahme?
Keine Rechtsberatung, aber diese Punkte solltest du kennen. Wir beziehen uns auf die DSGVO, die in Deutschland und Österreich unmittelbar gilt.
- Stimmen sind personenbezogene Daten nach Art. 4 Nr. 1 DSGVO, wenn die Person bestimmbar ist. Für ausschließlich persönliche oder familiäre Zwecke gilt die DSGVO nicht (Art. 2 Abs. 2 lit. c); transkribierst du Aufnahmen anderer beruflich, für die Uni oder einen Verein, gilt sie.
- Lokal mit Whisper, Vosk, noScribe oder aTrain verlässt die Aufnahme deinen Rechner nicht. Das ist die datensparsamste Lösung, die DSGVO gilt trotzdem.
- Cloud-Dienste: Transkribiert ein Anbieter für dich, brauchst du in der Regel einen Vertrag zur Auftragsverarbeitung (Art. 28). Für US-Unternehmen, die am EU-US Data Privacy Framework teilnehmen, gibt es seit dem 10. Juli 2023 einen Angemessenheitsbeschluss der EU-Kommission.
- Wo gerechnet wird: Word schickt die Datei an Microsoft. Microsofts EU-Datengrenze gilt für die Unternehmens-Onlinedienste, darunter Microsoft 365 bei Kunden mit Sitz in der EU oder EFTA; private Konten beschreibt die Seite nicht. Fireflies und Descript verarbeiten in den USA.
Eine gute Prüfliste liefert der Landesbeauftragte für den Datenschutz Baden-Württemberg. Sein Leitfaden vom 11. Juni 2026 ist für Gemeinderatssitzungen geschrieben, die technischen Punkte passen aber auch für dich:
- Keine Biometrie: Solange die Stimme nur in Text umgewandelt, niemand an der Stimme erkannt und kein Stimmabgleich mit Referenzdaten gemacht wird, sieht die Behörde keine Verarbeitung biometrischer Daten. Die Unterscheidung der Sprecher soll nur vorübergehend sein, ohne dauerhafte Profile, und Namen dürfen nur mit Rechtsgrundlage zugeordnet werden.
- Mindeststandards: keine Nutzung der Daten zum Training, Verarbeitung vorzugsweise in der EU, wo nötig ein Vertrag zur Auftragsverarbeitung, bevorzugt eigene Server oder eine abgeschottete Instanz, in der Cloud BSI IT-Grundschutz und der Kriterienkatalog C5.
- Kontrolle und Löschen: Zusammenfassungen dauerhaft von Menschen prüfen lassen, Transkripte mindestens stichprobenartig, und festlegen, wann Aufnahme und Transkript gelöscht werden.
Der Europäische Datenschutzausschuss nennt Sprachdaten in seinen Leitlinien zu Sprachassistenten von Natur aus biometrisch; werden sie genutzt, um eine Person eindeutig zu identifizieren, gilt Art. 9 DSGVO.
Und: Nimm niemanden heimlich auf. Auch die Whisper-Modellkarte rät davon ab, Aufnahmen von Personen ohne deren Zustimmung zu transkribieren. Einwilligung und § 201 StGB erklären wir im Ratgeber Interview transkribieren, die Sicht des Bayerischen Landesamts für Datenschutzaufsicht im Ratgeber Transkript mit Zeitmarken.
Checkliste: vom Rohtext zum brauchbaren Transkript
- Sprache vorgeben: Deutsch einstellen, nicht raten lassen.
- Modell wählen: turbo, wenn dein Rechner es schafft, sonst small.
- Länge prüfen: Passt die Textmenge zur Dauer? Wiederholt sich eine Zeile?
- Das Ende lesen: In der Stille am Schluss stehen gern erfundene Wörter.
- Namen und Fachbegriffe suchen: Dort sitzen die meisten Fehler.
- Großschreibung prüfen: Ist alles klein, nimm medium oder small oder einen Beispielsatz als Prompt.
- Rechtschreibung angleichen: „daß“ durch „dass“ ersetzen, für die Schweiz ß durch ss.
- Zahlen vereinheitlichen: In unseren englischen Aufnahmen schrieb tiny Geldbeträge in Ziffern, small und turbo in Worten.
- Gegenhören: Hör die Aufnahme beim Lesen noch einmal, besonders bei mehreren Stimmen oder Geräuschen.
- Weiterverarbeiten: Für Untertitel lies unseren Ratgeber zur SRT-Datei, für Ergebnisse statt Wortlaut schreib ein Protokoll.
