Una transcripción con marcas de tiempo une cada pasaje del texto con un momento de la grabación. Junto a una frase lees, por ejemplo, [00:12:41] y vuelves a escuchar ese punto enseguida. Las marcas se ponen en cada cambio de hablante, a intervalos fijos o junto a una palabra que no se entiende. El código de tiempo, que además cuenta fotogramas, es cosa de la edición de vídeo, y un archivo de subtítulos necesita un inicio y un final para cada línea. Te enseñamos un extracto inventado en todos estos formatos y las herramientas que los generan.
Marca de tiempo, código de tiempo y subtítulo: qué es cada cosa
Una marca de tiempo indica a qué distancia del inicio de la grabación está un pasaje: [00:12:41] significa doce minutos y 41 segundos después del comienzo. No es la hora del reloj. Una entrevista que empezó a las cuatro de la tarde arranca igualmente en 00:00:00 en la transcripción.
Cada herramienta lo llama a su manera. Microsoft habla de «marca de tiempo» en Word y en Teams, oTranscribe de «etiqueta de tiempo» y la ayuda de YouTube simplemente de «tiempos». En una transcripción, todo eso es lo mismo. Lo que sí conviene distinguir son tres cosas:
- La marca de tiempo: horas, minutos y segundos transcurridos desde el inicio, a veces con una fracción de segundo. Sirve para encontrar un pasaje.
- El código de tiempo SMPTE: además numera cada fotograma de un vídeo, con el formato
hh:mm:ss:ff. Sirve para editar. - El subtítulo: cada bloque de un archivo SRT o WebVTT tiene una hora de inicio y otra de final. Está hecho para verse en pantalla, no para leerlo o citarlo.
Un mismo extracto, cuatro formas de marcar el tiempo
Para comparar los formatos escribimos un breve extracto de entrevista inventado con Lucía, tesorera de un club deportivo, con tiempos también inventados. Aquí tienes dos intervenciones, primero con una marca en cada turno y después con código de tiempo:
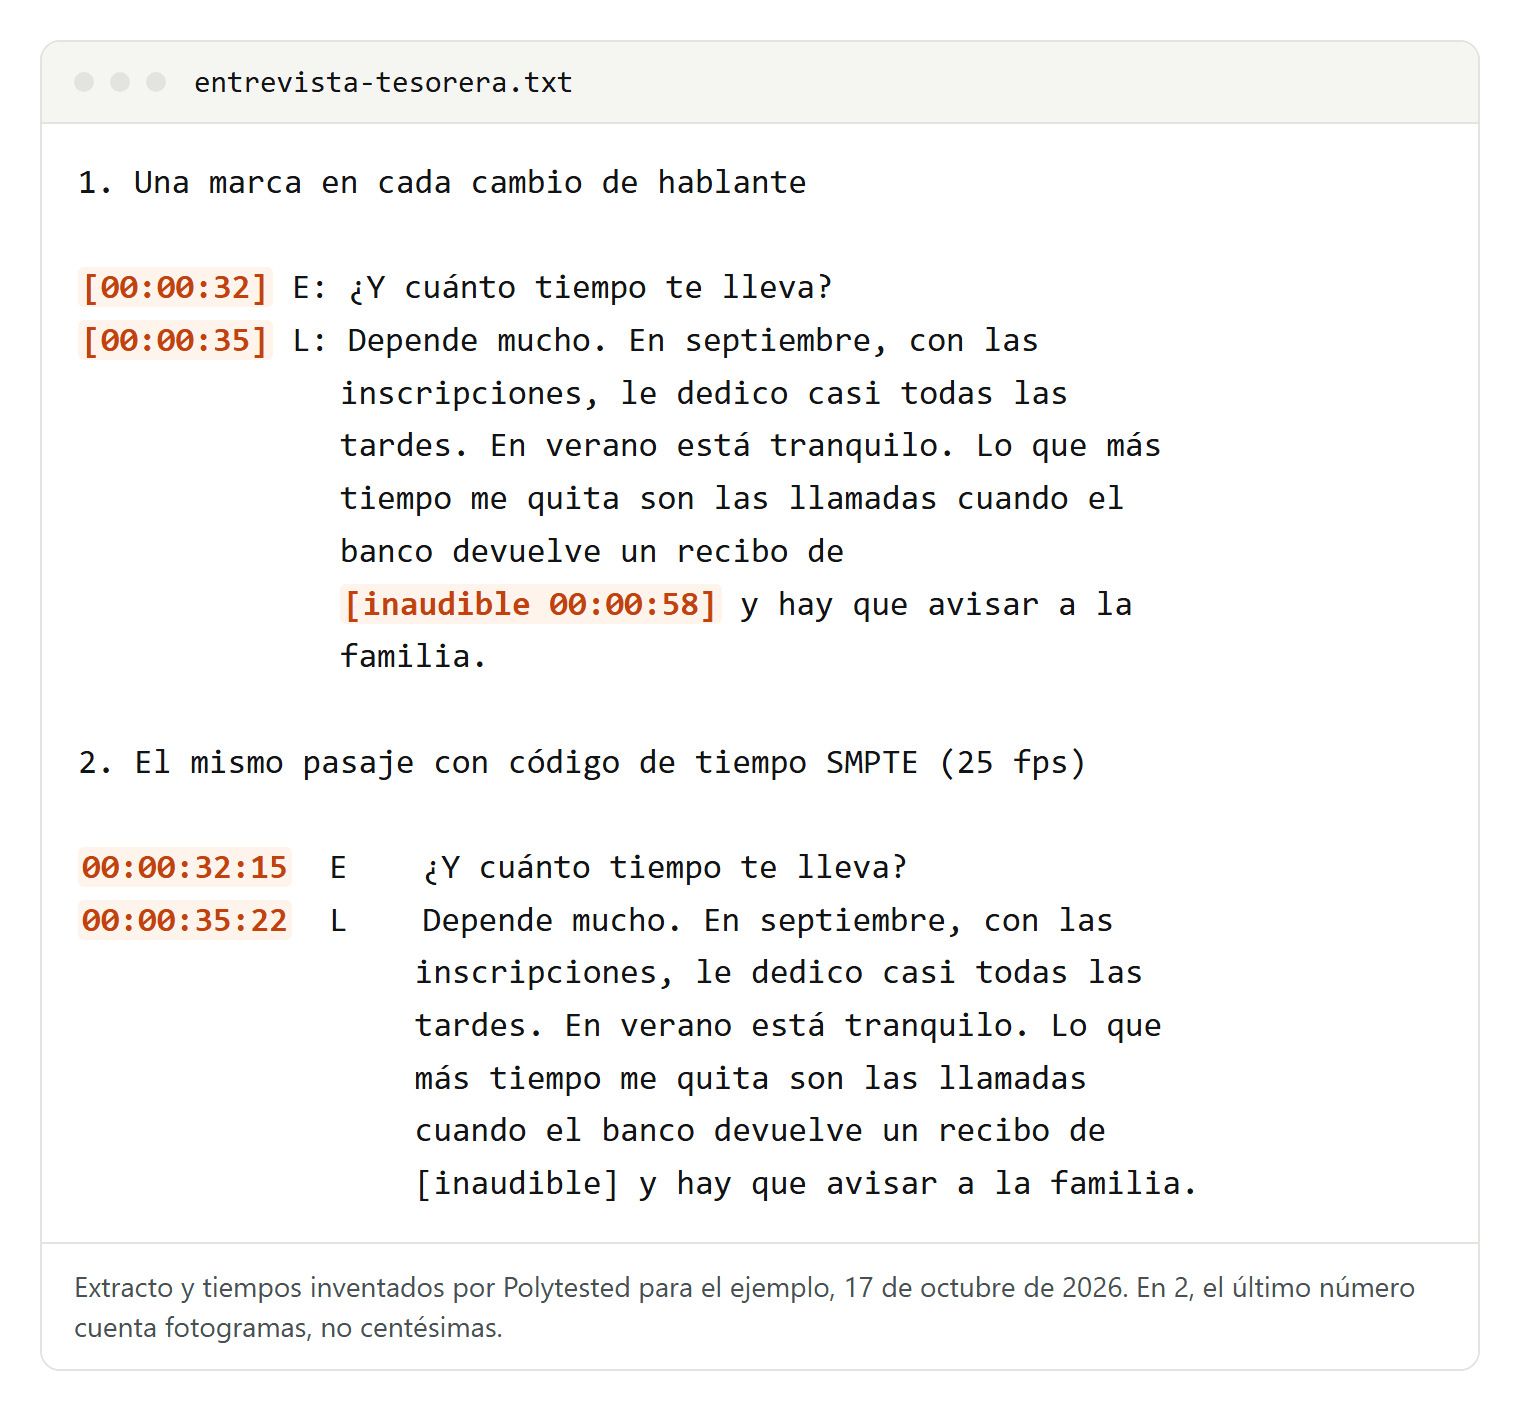
En cada cambio de hablante. La marca va al principio de cada intervención. Es la forma más habitual en entrevistas y reuniones, porque cualquier turno se puede encontrar. La palabra que no se entiende lleva su propia marca, aquí [inaudible 00:00:58], para que otra persona escuche justo ese punto.
A intervalos fijos. Una marca cada treinta segundos o cada dos minutos, hable quien hable. Puede caer en mitad de una frase:
[00:00:00] E: ¿Cómo acabaste siendo tesorera del club?

L: Un poco por casualidad. En la asamblea anual nadie quería llevar las cuentas, y yo trabajo en contabilidad. Así que levanté la mano. [risas] Desde entonces llevo las altas de socios, las cuotas y, una vez al año, el [00:00:30] informe de cuentas.
Este ritmo encaja con conferencias, clases y monólogos largos.
Con código de tiempo. Horas, minutos, segundos y fotogramas. A 25 fotogramas por segundo, 00:00:35:22 son 35 segundos y 22 fotogramas, no 22 centésimas. Así cuentan los programas de edición.
Palabra por palabra. El reconocimiento de voz puede guardar un inicio y un final para cada palabra. Lo usan las herramientas de edición y subtitulado; una persona casi nunca lo lee.
El mismo extracto como archivo SRT
Una transcripción se lee; un archivo de subtítulos se muestra en pantalla. La diferencia salta a la vista cuando conviertes una cosa en la otra. Primer intento: un subtítulo por intervención.
1
00:00:02,400 --> 00:00:06,100
¿Cómo acabaste siendo tesorera del club?

2
00:00:06,900 --> 00:00:31,800
Un poco por casualidad. En la asamblea anual nadie quería llevar las cuentas, y yo trabajo en contabilidad. Así que levanté la mano. [risas] Desde entonces llevo las altas de socios, las cuotas y, una vez al año, el informe de cuentas.
Aparecen dos problemas:
- Faltan las horas de final. Una transcripción con una marca al principio de cada intervención solo te da el inicio de la siguiente. Nosotros usamos el final de la intervención, que solo conocen nuestros tiempos inventados.
- El bloque es demasiado largo: 235 caracteres en pantalla durante casi 25 segundos. En nuestra prueba del 15 de octubre de 2026, Chrome mostró la versión alemana de esta misma respuesta como un bloque de cuatro líneas sobre la cuarta parte inferior de la imagen.
Dividida en subtítulos de dos líneas de 42 caracteres como máximo, la respuesta empieza así:
2
00:00:06,900 --> 00:00:15,341
Un poco por casualidad. En la asamblea
anual nadie quería llevar las cuentas, y

3
00:00:15,341 --> 00:00:23,359
yo trabajo en contabilidad. Así que
levanté la mano. [risas] Desde entonces
Los tiempos intermedios son estimaciones: repartimos la duración de la respuesta según la longitud de las palabras. Y los cortes caen en mitad de la frase («las cuentas, y / yo trabajo»). Es mejor que los subtítulos los cree una herramienta que analiza el audio y corregir después las líneas en un editor. El formato y las tildes los explicamos en nuestra guía del archivo SRT, y el camino inverso, de subtítulos a texto legible, en convertir SRT a texto. En la misma prueba, Chrome rechazó el archivo SRT como pista de subtítulos: solo lee WebVTT.
¿Cada cuánto poner una marca de tiempo?
- Entrevista de investigación: una marca en cada cambio de hablante y otra en cada pasaje inaudible. MAXQDA, programa de análisis cualitativo, recomienda para las transcripciones hechas fuera del programa al menos una marca al final de cada párrafo y otra dentro de los pasajes difíciles de entender. Pregunta a tu director o directora de tesis si hay una norma. Las convenciones de transcripción y el RGPD están en nuestra guía para transcribir entrevistas.
- Conferencia, clase, monólogo largo: una marca cada uno o dos minutos.
- Reunión: Teams y Zoom ponen la hora en cada intervención. Si solo importan las decisiones, te servirá más un acta de reunión.
- Vídeo para editar: código de tiempo, con la misma cadencia de fotogramas que el archivo.
- Subtítulos: un archivo SRT o WebVTT, con inicio y final para cada bloque.
- Grabación muy larga: primero un índice con tramos de tiempo, por ejemplo de
01:10:12a01:13:34para un tema, y después palabra por palabra solo los pasajes útiles.
Un mismo instante, once formas de escribirlo
Cada programa escribe el mismo momento a su manera. Convertimos un instante, una hora, dos minutos y 3,48 segundos después del inicio, a las notaciones que encontramos en páginas de ayuda, manuales y nuestras propias pruebas:
| Herramienta o formato | Notación | Fuente |
|---|---|---|
| Marca clásica (noScribe, Rev, Transcribe) | [01:02:03] | ayuda de MAXQDA, web de noScribe |
| f4transkript, f4x (programas alemanes) | #01:02:03-4# | ayuda de MAXQDA |
| MAXQDA Transcription | [1:02:03.4] | ayuda de MAXQDA |
| HappyScribe, transcripción automática | [01:02:03.480] | ayuda de MAXQDA |
| Panel de transcripción de YouTube | 1:02:03 | nuestra comprobación, octubre de 2026 |
| oTranscribe | 1:02:03, y 00:58 por debajo de una hora | nuestra prueba, 15 de octubre de 2026 |
| Subtítulos SRT | 01:02:03,480 | formato SubRip |
| Subtítulos WebVTT | 01:02:03.480 | especificación del W3C |
| Whisper, archivo TSV | 3723480, en milisegundos | código fuente de Whisper |
| Código de tiempo, 25 fotogramas por segundo | 01:02:03:12 | norma de la UER |
| Código de tiempo drop-frame, 29,97 fotogramas por segundo | 01:02:03;14 | cálculo según SMPTE |
Lo que conviene saber:
- Las horas. YouTube y oTranscribe las omiten por debajo de una hora (
0:58,00:58). Las notaciones genéricas que MAXQDA acepta al importar las incluyen todas. - Coma o punto. SRT separa los milisegundos con coma; WebVTT, con punto. Si los cambias, el archivo falla.
- La cifra tras el guion. Los documentos de f4 y MAXQDA que leímos no dicen qué representa: es una fracción de segundo, probablemente la décima.
Esto importa en cuanto un programa de análisis lee la transcripción. MAXQDA solo reconoce los formatos de su lista; convierte las marcas en marcas internas, las quita del texto y borra cualquier marca que apunte a un momento anterior a la previa. También importa archivos VTT de Zoom, Teams o Webex. NVivo importa igualmente transcripciones con marcas de tiempo y las enlaza con el audio o el vídeo. Añade las horas a las marcas de YouTube u oTranscribe antes de importarlas: la ayuda de MAXQDA no dice si reconoce 00:58.
Cómo leer un código de tiempo SMPTE
Un código de tiempo como 00:01:23:12 parece una marca con centésimas, pero las dos últimas cifras cuentan fotogramas. La norma de la UER, la Unión Europea de Radiodifusión, está pensada para la televisión europea, también la española, a 25 fotogramas por segundo. Los fotogramas van por tanto de 00 a 24, y :12 es el duodécimo fotograma: 0,48 segundos. Para convertir, divide el número de fotograma entre 25: 00:01:23:12 está 83,48 segundos después del inicio.
Tres detalles:
- América Latina no tiene una sola cadencia. La norma NTSC, a 29,97 fotogramas por segundo, se ha usado en América del Norte, incluido México, en Centroamérica y en la mayor parte de Sudamérica. Argentina, Uruguay y Paraguay emitían en PAL-N, a 25. Mira la cadencia en las propiedades del archivo antes de convertir.
- El drop-frame. A 29,97 fotogramas por segundo, un código contado de forma normal se retrasa unos 3,6 segundos por hora respecto al reloj. El drop-frame se salta por eso los números de fotograma 00 y 01 al principio de cada minuto, salvo cada diez minutos. No se pierde ninguna imagen, solo números. Se reconoce por el punto y coma:
01:02:03;14. Para nuestro instante, el código sin drop-frame marca01:01:59:22, con 3,75 segundos de retraso. - El código no siempre empieza en cero. Una cámara puede arrancar en
10:00:00:00. Para alinear una transcripción con un vídeo necesitas el código inicial y la cadencia.
Un error que conviene evitar: leer 00:00:09:21 como 9,21 segundos. A 25 fotogramas por segundo son 9,84 segundos; a 30, 9,7.
Transcribir a mano con oTranscribe
oTranscribe es una aplicación web gratuita y de código abierto (licencia MIT) de la MuckRock Foundation, con interfaz en español, que solo funciona en ordenadores:
- Abre otranscribe.com, pulsa «Comienza tu transcripción aquí» y carga tu archivo de audio o vídeo.
- Esc reproduce o pausa, F1 y F2 retroceden y avanzan, F3 y F4 cambian la velocidad.
- Ctrl+J (Cmd+J en Mac) inserta la etiqueta de tiempo actual. Cada marca se puede pulsar.
- Exporta en Markdown, en texto plano o en el formato .otr.
La probamos en Chrome el 15 de octubre de 2026, con un archivo de audio en silencio de 65 minutos creado por nosotros, escribiendo nuestro extracto y poniendo marcas en momentos concretos:
- Notación: por debajo de una hora,
00:58; a partir de ahí,1:02:03. Las fracciones se cortan: 58,7 segundos se quedan en00:58. - Navegación: al pulsar una marca, la reproducción saltó al momento marcado.
- Exportación: en los archivos de texto y Markdown, las marcas pasan a ser texto normal al principio de la línea, sin enlace al audio.
- Privacidad: de las 40 peticiones de red que registramos, ninguna envió el audio; cargaban la página, las fuentes y los scripts. El texto se guarda cada segundo en el navegador: en un ordenador compartido, bórralo.
Es el método más lento, pero sirve para cualquier idioma.
Word, Teams, Zoom y YouTube: marcas de tiempo automáticas
Word, con una suscripción a Microsoft 365, transcribe grabaciones desde Inicio > Dictar > Transcripción, según la ayuda de Microsoft. En el panel Transcribir, «Iniciar grabación» graba en directo y «Cargar audio» sube un archivo .wav, .mp4, .m4a o .mp3, hasta 300 minutos al mes. Word separa las voces como «Orador 1», «Orador 2», y al seleccionar la marca de tiempo de una sección se reproduce ese fragmento. Con «Agregar todo al documento», la transcripción pasa al documento como texto normal con un hipervínculo al audio: las marcas solo se pueden pulsar en el panel. La lista de idiomas incluye 21 variantes de español, de España y México a Argentina o Estados Unidos, además del catalán; ni el gallego ni el euskera aparecen. En el escritorio, la función solo está en Word para Microsoft 365 en Windows en inquilinos comerciales; en la web, solo en el nuevo Microsoft Edge y en Chrome.
Teams muestra en la transcripción en directo el nombre y la marca de tiempo de cada hablante. Durante la reunión: Más acciones > Transcribir, confirma el idioma y pulsa «Confirmar»; una grabación también inicia la transcripción, y todos los participantes reciben un aviso. Después, el organizador y los coorganizadores la descargan como .docx o .vtt: Chat, chat de la reunión, Resumen, Transcripción y la flecha junto al botón de descarga. Como idioma hablado, Teams ofrece español (España), español (México) y catalán, no las demás variantes.
Zoom solo transcribe reuniones grabadas en la nube, con una cuenta Pro, Business, Education o Enterprise. La transcripción llega como archivo VTT aparte, dividido en secciones con marcas de tiempo. Zoom la genera en inglés por defecto: para una reunión en español, cambia el idioma de la grabación en el portal web y Zoom la vuelve a crear.
YouTube muestra la transcripción de cualquier vídeo con subtítulos: «Mostrar transcripción» en la descripción y un clic en una línea para saltar a ella. Las marcas no llevan ceros de más (0:58, 1:02:03), según comprobamos en octubre de 2026. Para tus propios vídeos, la «Sincronización automática» de YouTube Studio toma un texto pegado o subido y ajusta ella misma los tiempos. El texto debe estar en el idioma del vídeo, YouTube no lo recomienda para vídeos de más de una hora o con mal audio, y la pista se publica automáticamente cuando está lista.
Los archivos VTT de Teams o Zoom se abren con cualquier editor de texto; nuestra guía del archivo VTT explica cómo convertirlos en texto limpio.
En tu ordenador y automático: Whisper, noScribe, aTrain
Si la grabación no debe salir de tu ordenador, hay tres herramientas gratuitas que transcriben en local:
- Whisper, el modelo de reconocimiento de voz de código abierto de OpenAI, escribe archivos SRT, VTT, TSV y JSON con tiempos, por ejemplo con
whisper entrevista.mp3 --language Spanish --output_format srt. Ojo con el formato TXT: solo contiene el texto, sin una sola marca. Whisper no distingue hablantes. - noScribe, pensado para la investigación en ciencias sociales, puede insertar marcas como
[00:01:38]y genera un archivo HTML para abrir en Word, texto plano o WebVTT. - aTrain, desarrollado en la Universidad de Graz, transcribe sin conexión, reconoce a los hablantes y crea archivos que se pueden importar en ATLAS.ti, MAXQDA y NVivo con marcas pulsables.
Medimos la precisión de Whisper con audiolibros en inglés y en alemán, todavía no en español: los resultados están en nuestra guía para transcribir audio a texto. Uses la herramienta que uses, revisa nombres, cifras y términos técnicos escuchando de nuevo antes de citar.
Errores que desplazan las marcas de tiempo
- MP3 con tasa de bits variable: el fabricante del programa f4 aconseja grabar en MP3 con tasa de bits constante, porque una variable puede desplazar las marcas. MAXQDA explica que algunos programas calculan de forma distinta la duración de un MP3 y recomienda entonces el formato AAC.
- Grabación recortada o unida: si quitas el principio o juntas dos archivos, todas las marcas posteriores quedan mal. Apunta el desfase o transcribe la versión definitiva.
- Horas que faltan:
58:12puede ser 58 minutos y 12 segundos, o 58 segundos y 12 fotogramas. Escribe siempre00:58:12. - Marcas convertidas en texto: lo que Word añade al documento y lo que oTranscribe exporta como texto ya no se puede pulsar.
- Una sola versión: guarda la primera exportación intacta y trabaja sobre una copia, para poder comprobar cualquier marca.
Datos personales: ¿adónde va la grabación?
El problema no es la marca de tiempo, sino la grabación. Word, Teams y Zoom procesan el audio en la nube. En el caso de Word, Microsoft indica que los archivos de audio se le envían solo para prestar el servicio y que, una vez hecha la transcripción, su servicio no guarda ni el audio ni el resultado; la grabación sigue, eso sí, en la carpeta Archivos transcritos de tu OneDrive. Teams guarda las transcripciones en el OneDrive para la Empresa del organizador. oTranscribe, Whisper, noScribe y aTrain funcionan en tu ordenador.
Una voz grabada es un dato personal según el RGPD. Esta guía no sustituye el asesoramiento jurídico; el permiso para grabar y la base legal se tratan en nuestra guía para transcribir entrevistas.
