Pour une transcription audio en texte gratuite, la méthode la plus précise de notre test est Whisper, le moteur de reconnaissance vocale libre d'OpenAI, installé sur votre ordinateur : il fonctionne hors ligne et l'enregistrement ne quitte pas votre machine. Son modèle par défaut, turbo, s'est trompé sur moins de 2 mots sur 100 dans des livres audio en anglais et en allemand. Le français, nous ne l'avons pas encore mesuré. Autres options : « Transcrire » dans Word avec un abonnement Microsoft 365, le Dictaphone de l'iPhone pour vos propres enregistrements, ou un site en ligne, avec ses limites.
Quelle méthode pour quel enregistrement ?
- Un fichier qui doit rester chez vous : Whisper, de préférence dans un logiciel gratuit avec une interface comme noScribe ou aTrain. Une fois le modèle téléchargé, tout se passe hors ligne.
- Vous avez déjà Microsoft 365 : « Transcrire » dans Word accepte les fichiers .wav, .mp4, .m4a et .mp3, jusqu'à 300 minutes par mois. Le fichier part chez Microsoft.
- Vous allez enregistrer avec un iPhone : le Dictaphone et Notes transcrivent ce que vous enregistrez dans ces apps, en français aussi.
- Un fichier court, sans rien de personnel : un site de transcription en ligne, dans la limite de sa version gratuite.
- Vous voulez parler plutôt que taper : c'est de la dictée. Google Docs, Windows et macOS savent le faire, mais n'ouvrent aucun fichier audio.
- L'audio est une vidéo YouTube : il existe souvent déjà une transcription, voyez notre guide sur la transcription d'une vidéo YouTube.
- Vous avez besoin des décisions, pas du mot à mot : rédigez plutôt un compte rendu de réunion.
Notre test : ce que nous avons mesuré, et ce qui manque
Nous avons pris six livres audio du domaine public sur LibriVox, trois en anglais et trois en allemand, lus chacun par une personne différente. Nous les avons transcrits avec huit moteurs gratuits sur un ordinateur portable ordinaire, puis comparé le résultat mot à mot au texte imprimé du livre, repris du Project Gutenberg.
- Les enregistrements : le début de trois nouvelles d'O. Henry (1906) et trois récits de Franz Kafka tirés de « Ein Landarzt » (1919-1920), 17 minutes 39 secondes et un peu plus de 2 600 mots en tout.
- Les moteurs : Whisper en six tailles (tiny, base, small, medium, turbo et large-v3), avec les réglages de la commande
whisperet la langue indiquée, et Vosk, un autre moteur libre hors ligne, avec un petit et un grand modèle par langue. - La note : le taux d'erreur par mot, c'est-à-dire combien de mots du livre sur 100 ressortent faux, manquants ou en trop. Majuscules, ponctuation et écriture des nombres ne comptent pas.
- L'ordinateur : un portable avec un processeur AMD Ryzen 7 à 8 cœurs, 32 Go de mémoire et Windows 11, et pour comparaison sa carte graphique Nvidia RTX 4050 de 6 Go.
- Le contrôle : les modèles ont peut-être « entendu » ces anciens enregistrements pendant leur entraînement. Nous avons donc refait le test avec cinq lectures publiées par LibriVox à l'automne 2025.
Un livre audio est aussi le cas le plus favorable : une voix, un bon micro, aucune interruption. Un entretien, une réunion à plusieurs ou un accent marqué donneront plus d'erreurs.
Les résultats en anglais et en allemand
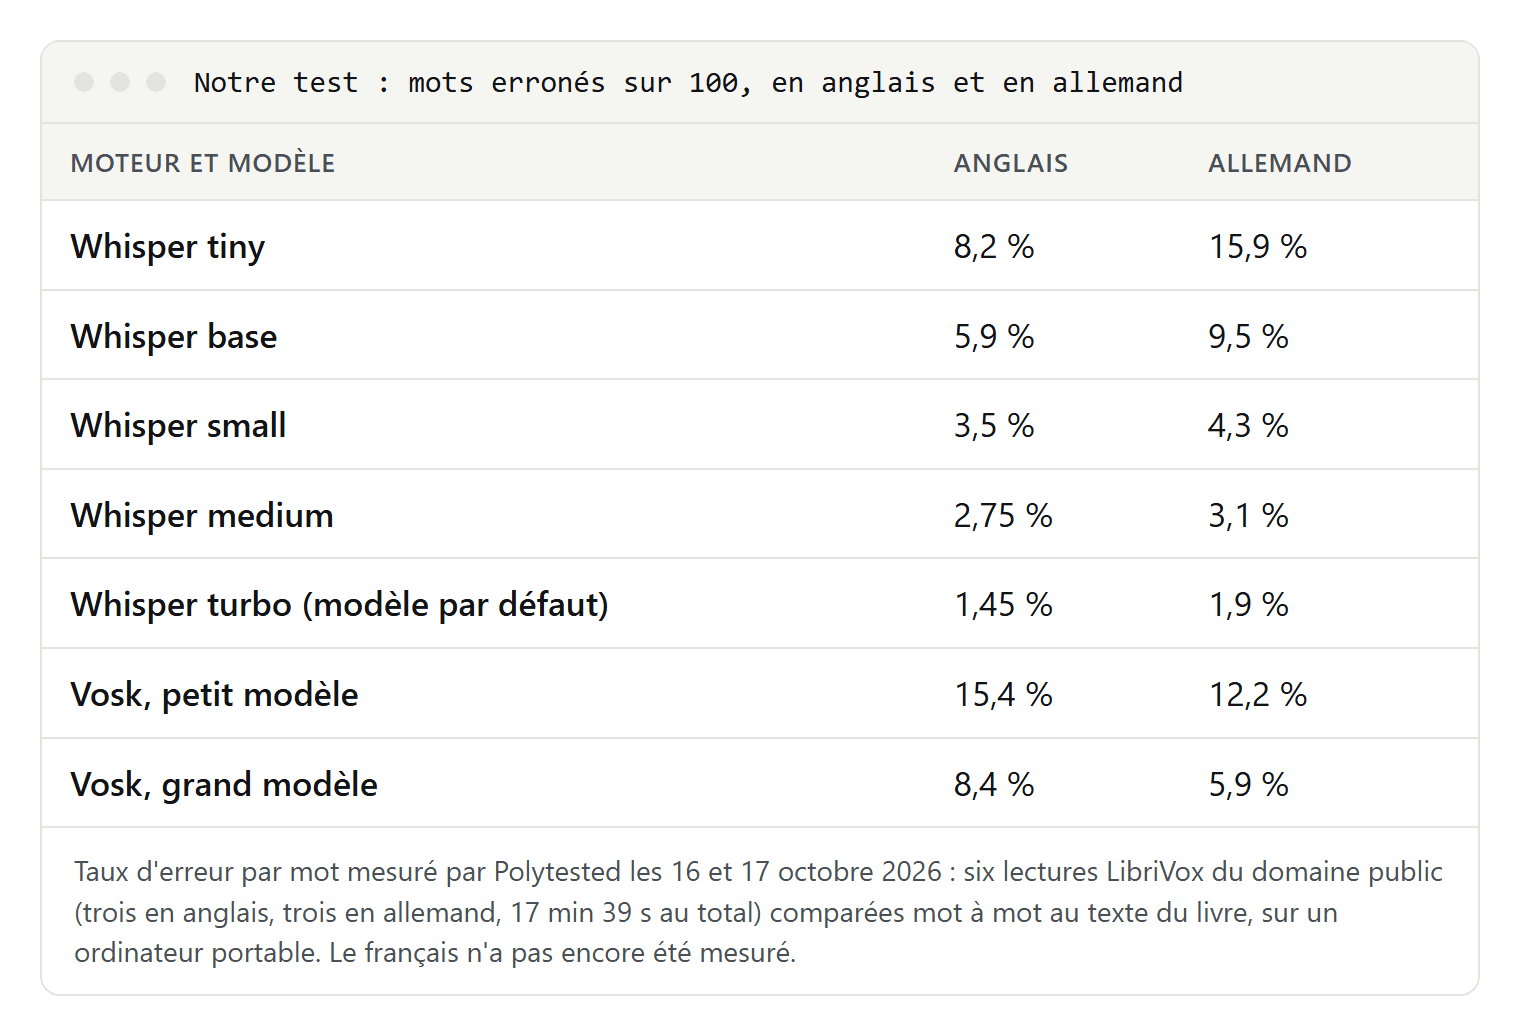
- turbo, le modèle par défaut de la commande
whisper, a fait 1,45 pour cent d'erreurs en anglais (18 mots sur 1 238) et 1,9 pour cent en allemand. - medium suit avec 2,75 et 3,1 pour cent, puis small avec 3,5 et 4,3, base avec 5,9 et 9,5 et tiny avec 8,2 et 15,9 pour cent.
- Vosk atteint 8,4 et 5,9 pour cent avec ses grands modèles, 15,4 et 12,2 avec les petits, sans majuscules ni ponctuation.
- large-v3, le plus gros modèle, si lent sur un portable que nous ne l'avons lancé que sur deux extraits, n'a pas fait mieux que turbo.
Sur les lectures de 2025, turbo est resté à 1,0 pour cent en anglais et 1,3 pour cent en allemand, et l'ordre des modèles n'a pas changé. Les résultats ne tiennent donc pas à de vieux enregistrements déjà connus des modèles.
Le plus instructif pour le français, c'est l'écart entre les deux langues. Les petits modèles perdent beaucoup plus en allemand qu'en anglais : tiny y fait presque deux fois plus d'erreurs. À partir de small, l'écart tombe sous un point. Une étude du centre CISPA sur onze services de transcription va dans le même sens : la plupart s'en sortaient mieux en anglais qu'en allemand, et Whisper était le meilleur service d'IA (état de décembre 2022). La documentation de Whisper prévient aussi que ses performances varient fortement selon la langue. Dans notre test, plus le modèle était gros, moins la langue comptait ; si le français suit la même pente, nous ne le savons pas encore.
Vosk publie ses propres chiffres pour le français : entre 12 et 22 pour cent d'erreurs pour son grand modèle (1,4 Go) selon le jeu de test, le chiffre le plus élevé portant sur des podcasts. Ce sont les mesures de l'éditeur, qui ne se comparent pas aux nôtres : pour son grand modèle allemand, Vosk annonce entre 10 et 33 pour cent, alors que ce modèle a fait 5,9 pour cent sur nos livres audio.
Pour savoir ce que vaut un outil sur votre français :
- Tapez à la main deux minutes typiques de votre enregistrement.
- Faites transcrire le même passage par l'outil.
- Comptez les mots faux, manquants et en trop, sans tenir compte des majuscules ni de la ponctuation.
- Divisez par le nombre de mots de votre texte et multipliez par 100 : c'est son taux d'erreur par mot sur votre enregistrement.
Combien de temps prend la transcription ?
| Modèle | Processeur seul (anglais / allemand) | Avec la carte graphique (anglais / allemand) |
|---|---|---|
| Whisper tiny | 6 / 7 minutes | 3 / 4 minutes |
| Whisper base | 13 / 15 minutes | 4 / 4 minutes |
| Whisper small | 33 / 34 minutes | 6 / 7 minutes |
| Whisper medium | environ 2 heures | 12 / 13 minutes |
| Whisper turbo | 39 / 42 minutes | 8 / 9 minutes |
| Whisper large-v3 | plus de 3 heures | ne tenait pas dans la carte |
| Vosk, petit modèle | 3 / 2 minutes | non testé |
| Vosk, grand modèle | 12 / 7 minutes | non testé |
Sans carte graphique, turbo a demandé une quarantaine de minutes de calcul par heure d'audio : à peine plus que small, pour moins de la moitié des erreurs. Avec la carte graphique, 8 à 9 minutes ont suffi. Le premier lancement télécharge le modèle : 75 Mo pour tiny, 1,62 Go pour turbo. Nos temps viennent d'un seul passage et peuvent varier d'environ un dixième ; selon la documentation de Whisper, la vitesse dépend aussi de la langue.
Ce qui a mal tourné dans nos essais
- Tout en minuscules, sans ponctuation. Pour 9 de nos 11 extraits, turbo n'a rendu que des mots en minuscules sans un seul signe de ponctuation, et large-v3 a fait de même sur ses deux extraits ; tiny à medium écrivaient des phrases normales. Une phrase neutre et bien ponctuée passée avec l'option
--initial_prompta tout rétabli, mais turbo a alors inventé des mots à la fin de 4 des 6 extraits anglais. - Des mots inventés dans le silence. Sans amorce, large-v3 a ajouté « you you » et « die die die die » après la dernière phrase de deux extraits. La fiche du modèle Whisper prévient qu'il peut produire du texte jamais prononcé.
- Une boucle. Sur le fichier complet d'une nouvelle de quatorze minutes et demie, le modèle base appelé avec les réglages bruts de sa bibliothèque Python a rendu 47 fois la ligne « CHAPTER II. » et rien d'autre. Avec les réglages par défaut de la commande
whisper, il a tout transcrit. - Les noms propres. Aucun système n'a écrit correctement à chaque fois « Odradek », le nom inventé par Kafka. Vosk en a fait « deck » ou un mot proche : il ne connaît que les mots de son vocabulaire.
D'où quelques règles : gardez les réglages par défaut, indiquez la langue (sans elle, tiny a pris une lecture anglaise pour de l'afrikaans), coupez les longs silences, lisez la fin et vérifiez que la longueur du texte correspond à la durée.
Whisper sur votre ordinateur : logiciels gratuits et ligne de commande
Whisper est publié sous licence MIT, et le français fait partie des langues qu'il reconnaît. Plusieurs logiciels gratuits l'enveloppent d'une interface ; nous ne les avons pas installés, les informations viennent de leurs pages de projet :
- noScribe, de Kai Dröge, est gratuit et libre (GPL-3.0), tourne entièrement en local sous Windows, macOS et Linux, distingue les intervenants, comprend une soixantaine de langues et inclut un éditeur. Son site officiel, noscribe.de, existe en anglais, allemand, espagnol, italien et néerlandais, pas en français. Un service payant sur un domaine en .ai n'a rien à voir avec le projet.
- aTrain, de l'université de Graz, transcrit hors ligne, n'envoie ni enregistrement ni transcription sur Internet, gère 99 langues dont le français et produit des fichiers pour MAXQDA, ATLAS.ti et NVivo. Sous Windows, il s'installe depuis le Microsoft Store.
- Buzz et Vibe transcrivent aussi hors ligne et exportent en TXT, SRT ou VTT. L'installateur Windows de Buzz n'est pas signé, d'où un avertissement de Windows.
Dans chacun, choisissez turbo si votre ordinateur suit, sinon small, et indiquez le français comme langue plutôt que la détection automatique. L'usage de noScribe et d'aTrain pour des entretiens est détaillé dans notre guide sur la retranscription d'un entretien.
En ligne de commande, installez Python et ffmpeg (la documentation de Whisper cite Chocolatey ou Scoop sous Windows, Homebrew sur Mac), puis :
pip install -U openai-whisper
whisper enregistrement.mp3 --model turbo --language French --output_format txt
Sans --output_format, Whisper écrit cinq fichiers : TXT, SRT, VTT, TSV et JSON ; pour retirer les codes temporels d'un SRT, voyez comment convertir un SRT en TXT. Les modèles dont le nom finit par .en ne servent qu'à l'anglais. Selon l'aide de la commande, --condition_on_previous_text False rend les boucles moins probables.
À ne pas confondre : le 26 août 2026, OpenAI a annoncé que ses modèles de transcription payants, dont whisper-1, quitteront son API le 26 février 2027. Le modèle libre installé chez vous n'est pas concerné.
Word « Transcrire » : seulement avec Microsoft 365
Nous n'avons pas testé Word ; ce qui suit vient de l'aide de Microsoft. Allez dans Accueil, Dicter, Transcrire, puis choisissez « Télécharger l'audio ».
- Abonnement requis : avec Microsoft 365, jusqu'à 300 minutes d'audio chargé par mois.
- Où ça marche : dans Word pour le Web avec le nouveau Microsoft Edge ou Chrome et, sur ordinateur, pour l'instant seulement dans Word pour Microsoft 365 sous Windows dans les locataires commerciaux. Internet est nécessaire.
- Résultat : des intervenants étiquetés « Intervenant 1 », « Intervenant 2 », des horodatages cliquables et le bouton « Ajouter tout au document ». Un document ne garde qu'une transcription.
- Langues : plus de 80 paramètres régionaux, dont seulement « Français (France) » et « Français (Canada) », sans variante belge ou suisse.
- Stockage : l'enregistrement reste dans le dossier « Fichiers transcrits » de votre OneDrive jusqu'à ce que vous le supprimiez.
Microsoft écrit : « Vos fichiers audio sont envoyés à Microsoft et utilisés uniquement pour vous fournir ce service. » Après la transcription, son service ne conserve ni l'audio ni le résultat. Les horodatages de Word sont détaillés dans notre guide sur la transcription avec horodatage.
Dictaphone et Notes sur iPhone
Non testé non plus ; ces informations viennent de l'aide d'Apple. Sur un iPhone 12 ou plus récent, le Dictaphone (dossier Utilitaires) transcrit vos enregistrements, en direct ou après coup. Apple cite le français, l'anglais, l'espagnol, l'allemand et six autres langues, et précise que la fonction n'existe que dans certains pays et régions.
- Dictaphone : touchez l'enregistrement, puis « Afficher la transcription » pour en copier une partie ou « Copier la transcription » pour tout le texte.
- Notes : dans une note, choisissez « Enregistrement audio » ; la transcription apparaît si la langue du système est prise en charge. Ensuite, « Ajouter une transcription à la note » ou « Copier la transcription ». Les appels enregistrés dans Téléphone ou FaceTime y sont aussi transcrits, à partir d'iOS 18.1.
Aucune des deux pages ne décrit l'import d'un fichier existant, par exemple un MP3 reçu par e-mail. Pour un enregistrement fait ailleurs, passez par Whisper.
Sites en ligne, ChatGPT, Descript et Fireflies
Les sites gratuits prennent votre fichier dans le navigateur. Sur les pages d'outils lues pour nos versions anglaise et allemande, « gratuit » voulait dire une durée maximale par fichier, quelques fichiers par jour ou des minutes par mois, parfois un simple aperçu sans compte. Les précisions affichées, de 90 à 99,9 pour cent, ne venaient jamais avec une méthode de mesure. Avant d'envoyer un fichier, cherchez où il est traité, s'il sert à entraîner des modèles et quand il est supprimé.
Trois services avec compte, non testés, d'après leurs pages d'aide :
- ChatGPT n'accepte les fichiers audio qu'avec un abonnement payant, jusqu'à 512 Mo. OpenAI prévient que la transcription peut contenir des erreurs et que les résultats varient selon la langue.
- Descript transcrit 26 langues à alphabet latin, dont le français, mais une seule langue par fichier ; la détection des mots de remplissage ne marche qu'en anglais. Il traite et stocke les données aux États-Unis et peut s'en servir pour entraîner ses modèles d'IA.
- Fireflies accepte MP3, M4A, WAV, MP4 et WEBM, jusqu'à 150 minutes par fichier, avec la langue à choisir à l'envoi. Les données sont stockées et traitées aux États-Unis par défaut ; le stockage dans l'UE de l'offre Enterprise ne change pas le lieu de traitement.
La dictée n'est pas une transcription
Ces fonctions gratuites écrivent ce que vous dites au micro, en direct. Aucune n'ouvre un fichier :
- Google Docs : Outils, puis « Saisie vocale », dans Chrome, Edge et Safari. Le français est pris en charge ; c'est le navigateur qui contrôle la reconnaissance vocale. Les commandes vocales d'édition ne marchent qu'en anglais.
- Windows + H : la saisie vocale utilise la reconnaissance en ligne des services vocaux Azure et demande une connexion Internet. Elle prend en charge « Français (France) » et « Français (Canada) ».
- Dictée sur Mac : elle s'arrête après 30 secondes sans parole. Les réglages Clavier indiquent si vos dictées sont traitées sur l'appareil, sans passer par les serveurs de Siri.
Elles servent quand c'est vous qui parlez, par exemple pour dicter vos notes juste après un entretien.
Confidentialité : où part votre enregistrement ?
Avec Whisper, Vosk, noScribe ou aTrain, l'enregistrement reste sur votre ordinateur. Word l'envoie à Microsoft, Descript et Fireflies (par défaut) aux États-Unis ; chez ChatGPT, l'usage des données dépend de l'abonnement et des réglages. Les pages d'aide du Dictaphone et de Notes ne disent pas où se fait la transcription.
Une voix enregistrée est une donnée personnelle au sens du RGPD. Un service en ligne qui transcrit pour vous agit comme sous-traitant, et la CNIL rappelle que ce traitement doit être encadré par un contrat. Dans son programme de travail pour 2026, publié le 7 avril 2026, elle annonce aussi vouloir clarifier les conditions d'usage des outils de transcription automatique. La fiche du modèle Whisper déconseille de transcrire des personnes enregistrées sans leur consentement ; consentement et article 226-1 du Code pénal sont expliqués dans notre guide sur la retranscription d'un entretien. Ces repères valent pour la France ; en Belgique, en Suisse ou au Québec, d'autres textes s'appliquent. Ce n'est pas un conseil juridique.
Check-list : du texte brut à une transcription propre
- Indiquez la langue plutôt que la détection automatique.
- Testez d'abord deux minutes et comptez les erreurs, comme expliqué plus haut.
- Vérifiez la longueur : le texte correspond-il à la durée ? Une ligne se répète-t-elle ?
- Lisez la fin : les mots inventés apparaissent volontiers dans le silence final.
- Cherchez les noms propres et les termes techniques : c'est là que les erreurs se concentraient.
- Contrôlez majuscules et ponctuation : si tout est en minuscules, essayez medium ou small.
- Harmonisez les nombres : selon le modèle, les montants sortaient en chiffres ou en toutes lettres.
- Réécoutez en lisant, surtout s'il y a plusieurs voix ou du bruit.
