El SEO (del inglés search engine optimization, optimización en buscadores) es el trabajo que ayuda a buscadores como Google o Bing a encontrar tus páginas, entenderlas y mostrarlas en sus resultados gratuitos, y que hace que valga la pena hacer clic en ellas. Tiene tres partes: la técnica (¿puede el buscador leer la página?), el contenido (¿responde la página a la pregunta?) y los enlaces de otras webs. Los anuncios de pago no son SEO. Te lo explicamos de forma sencilla con nuestra propia web, que abrimos a los buscadores el 13 de octubre de 2026.
Qué es el SEO y qué no es
En su guía para principiantes, Google explica que el SEO consiste en ayudar a los buscadores a entender tu contenido, y a los usuarios a encontrar tu sitio y decidir si lo visitan desde un buscador. En España también se habla de posicionamiento web. Y las mismas siglas sirven para la persona que hace el trabajo: la página de Google sobre contratar ayuda se titula «¿Necesitas un especialista en SEO?».
El SEO trata de los resultados orgánicos, los que nadie paga. Google afirma que nunca acepta dinero por incluir sitios en sus resultados ni por influir en su posicionamiento, y que anunciarse en Google no influye en la presencia de un sitio en ellos. Los anuncios son otro canal. Ojo con la sigla SEM (search engine marketing): en sentido amplio abarca anuncios y SEO, pero en el sector se usa a menudo solo para las campañas de pago. Si alguien te ofrece «SEM», pregunta qué incluye.
Por qué importa el SEO
En España, casi toda la búsqueda pasa por Google. StatCounter, que cuenta las visitas que llegan a más de un millón de webs con su código de seguimiento, atribuía en septiembre de 2026 a Google el 93,81 por ciento de las visitas procedentes de buscadores, a Bing el 3,49 por ciento y a Yahoo! el 1,92 por ciento. En ordenadores, Bing subía al 12,16 por ciento: si tus lectores trabajan delante de una pantalla, abre también una cuenta de Bing Webmaster Tools.
Los clics orgánicos son gratis, y una página útil sigue atrayendo visitas mucho después de que un anuncio se apague por falta de presupuesto. La pega: nada está garantizado. Google aclara que no garantiza rastrear, indexar ni mostrar una página, aunque cumpla todas sus normas básicas.
Cómo encuentra, indexa y ordena Google las páginas
Google describe la Búsqueda en tres fases, y no todas las páginas las superan:
- Rastreo. El robot de Google, Googlebot, descarga textos, imágenes y vídeos de las páginas. Descubre direcciones nuevas a través de los enlaces de páginas que ya conoce y de los sitemaps que le envías. Al rastrear, renderiza la página y ejecuta su JavaScript con una versión reciente de Chrome.
- Indexación. Google analiza el contenido, incluido el elemento
<title>y el texto alternativo de las imágenes, y guarda lo que aprende en su índice. También agrupa las páginas con contenido parecido y elige la más representativa, la canónica. La indexación tampoco está garantizada. - Publicación de resultados. En cada búsqueda, Google busca en el índice las páginas que coinciden y muestra las que considera más relevantes. Según Google, la relevancia depende de cientos de factores, como la ubicación, el idioma y el dispositivo de quien busca.
Un detalle para una web española: el rastreador de Google suele trabajar desde Estados Unidos. Si tus páginas cambian según la ubicación del visitante, comprueba lo que Google ve desde allí. Y ningún pago hace que Google rastree más a menudo ni que posicione mejor un sitio.
Lo que un buscador lee en nuestra página
Un rastreador no mira primero el diseño: lee el código HTML. Esta es la parte de arriba de una de nuestras guías en español, tal como la descarga un rastreador:
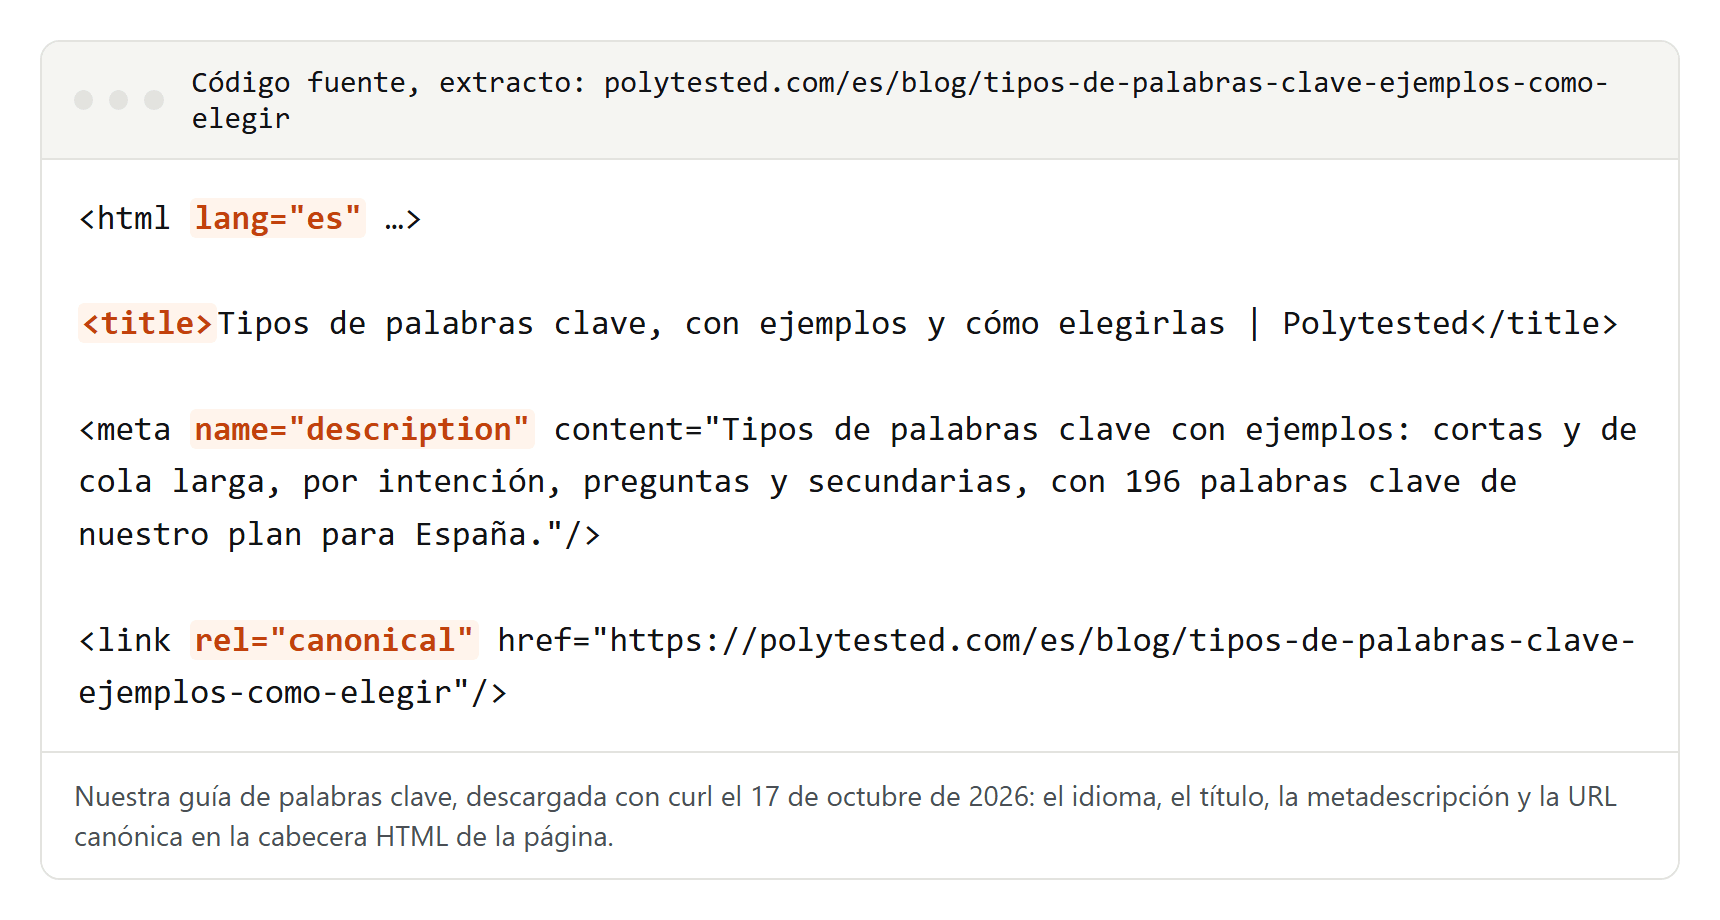
Línea a línea:
- El idioma:
lang="es"declara que la página está en español. - El título: aparece en la pestaña del navegador y es la fuente principal del enlace de título en los resultados, aunque Google también puede usar los encabezados. El nuestro repite el titular del artículo y añade el nombre de la web tras una barra vertical. Google pide títulos únicos para cada página, claros, concisos y fieles al contenido.
- La metadescripción: un resumen de una o dos frases. Google la usa a veces para el fragmento, la descripción bajo el título, pero casi siempre lo saca del propio texto de la página.
- La etiqueta canonical: la página indica su propia dirección como la preferida. Importa en cuanto un mismo contenido está disponible en varias direcciones; nuestra guía de la etiqueta canonical explica cuándo.
Más abajo, la misma página enlaza sus versiones en inglés, alemán y francés con etiquetas hreflang, que explicamos en nuestra guía de hreflang. Puedes ver todo esto en cualquier web: abre el código fuente de la página con Ctrl+U en Chrome, Edge o Firefox en Windows.
El segundo archivo que pide cualquier rastreador es el robots.txt. El nuestro, ese mismo día:
User-Agent: *
Allow: /
Disallow: /admin$
Disallow: /admin/
Disallow: /api/
Disallow: /go/

Sitemap: https://polytested.com/sitemap.xml
Permite rastrear toda la web salvo la zona de administración, la API y nuestros enlaces de redirección salientes, e indica el sitemap. El nuestro es un índice con un sitemap por idioma; el 17 de octubre de 2026, el español contenía 29 direcciones.
Qué pasó cuando abrimos nuestra web a Google
Hasta el lanzamiento, cada respuesta de nuestro servidor llevaba una regla noindex, y el robots.txt permitía rastrear sin mencionar ningún sitemap. El rastreo tenía que seguir abierto: Google solo puede cumplir una regla noindex en una página que puede descargar. Nuestra checklist de migración web explica cómo proteger un entorno de pruebas sin arruinar el lanzamiento. El día del estreno, un solo interruptor y una nueva compilación de la web quitaron la regla. Esto es lo que vino después:
| Hora | Qué pasó |
|---|---|
| 13 oct., 19:14 | Lighthouse analiza la página de inicio con el noindex todavía activo: puntuación SEO de 69 sobre 100. Única comprobación fallida: «Page is blocked from indexing». |
| 13 oct., 19:29 | Volvemos a compilar la web con la indexación activada. |
| 13 oct., 19:32 | Lighthouse otra vez: puntuación SEO de 100. |
| 13 oct., 19:40 | Enviamos el índice de sitemaps en Search Console. Google lo descarga cuatro segundos después. |
| 13 oct., 19:42 | El robot de Google para smartphones rastrea la página de inicio y la del blog. Las dos acaban indexadas. |
| 14 oct., hacia las 16:40 | Comprobamos las 86 direcciones de nuestros sitemaps con la herramienta de inspección de URLs de Search Console. |
El resultado, un día después del lanzamiento:
| Idioma | Direcciones | Indexadas | «Descubierta: actualmente sin indexar» | Desconocidas para Google |
|---|---|---|---|---|
| Inglés | 41 | 13 | 12 | 16 |
| Alemán | 27 | 7 | 0 | 20 |
| Francés | 9 | 6 | 2 | 1 |
| Español | 9 | 1 | 5 | 3 |
| Total | 86 | 27 | 19 | 40 |
Entonces aún no habíamos publicado ninguna guía en español: nuestras nueve direcciones en español eran la portada, las páginas corporativas y la página del autor. Solo una estaba indexada, «Cómo probamos», y Search Console indicaba que Google la había encontrado a través de sus versiones en inglés y francés y del sitemap alemán, es decir, de los enlaces entre idiomas. Cinco estaban descubiertas pero sin indexar, y tres, entre ellas la portada /es, eran todavía desconocidas para Google.
Más lecciones para cualquier web nueva. El rastreo puede empezar en minutos, pero la indexación llega página a página: un día después, Google no conocía 40 de nuestras direcciones. Las 27 páginas indexadas las había rastreado el robot para smartphones, que es lo que significa en la práctica la indexación centrada en los móviles. Y estar indexado no es lo mismo que aparecer: el 14 de octubre, Search Console aún no mostraba impresiones. Hasta el 16 de octubre, toda la web sumó 437 impresiones y 2 clics, como contamos en nuestra guía de palabras clave long tail.
SEO técnico: que te encuentren y te entiendan
Lo básico para que los buscadores lleguen a tus páginas y las lean:
- Deja entrar a los rastreadores. Google cita tres problemas frecuentes: errores del servidor, problemas de red y reglas del robots.txt que bloquean a Googlebot.
- Distingue noindex de robots.txt. Una regla noindex deja la página fuera del índice. El robots.txt solo impide el rastreo, y una dirección bloqueada puede aparecer igualmente en los resultados si otras páginas la enlazan.
- Envía un sitemap. Ayuda a Google a descubrir tus direcciones, pero no garantiza que las rastree. Según Google, a una web nueva con pocos enlaces externos le viene especialmente bien, mientras que una web pequeña, de 500 páginas o menos y bien enlazada, quizá no lo necesite.
- Una dirección por contenido. Si una página responde en varias direcciones, Google elige una; la etiqueta canonical indica tu preferencia. Si cambias una dirección, redirige la antigua de forma permanente.
- Piensa primero en el móvil. Google indexa y posiciona la versión para móviles de las páginas, rastreada con su agente para smartphones.
- Vigila las Métricas web principales. Los objetivos de Google: que el mayor elemento con contenido se renderice (LCP) en menos de 2,5 segundos, que la página responda a las interacciones (INP) en menos de 200 milisegundos y que los cambios de diseño acumulados (CLS) queden por debajo de 0,1. En el lanzamiento, Lighthouse midió en laboratorio un LCP de 2,1 segundos y ningún cambio de diseño en nuestra portada.
Según Google, unas buenas métricas van en la línea de lo que premian sus sistemas de posicionamiento, pero la velocidad no sustituye a una buena respuesta.
Contenido y SEO on-page: responde a la pregunta que hay detrás
La técnica mete una página en el índice; el contenido decide dónde aparece. Google pide contenido creado sobre todo para las personas, no para manipular el posicionamiento. Entre sus preguntas para revisarlo: ¿demuestra experiencia de primera mano? Después de leerlo, ¿alguien sabrá lo suficiente para conseguir su objetivo?
En la práctica:
- Elige una palabra clave principal por página y averigua qué quiere quien la escribe. Quien busca «plantilla acta de reunión» quiere primero una plantilla, no un ensayo. Nuestra guía sobre tipos de palabras clave explica volumen, dificultad e intención.
- Enseña tu propio trabajo. Mediciones, capturas y ejemplos propios distinguen una página de otras cien parecidas.
- Dale a cada página su título y su metadescripción. Nosotros ponemos la palabra clave principal al principio del título.
- Estructura el texto con encabezados. Según Google, su orden no importa para la Búsqueda, pero un orden lógico ayuda a los lectores de pantalla.
- Cuida las URL, el texto alternativo de las imágenes y el texto de los enlaces entre tus páginas: palabras claras, en español.
Dónde va la palabra clave en cada uno de estos sitios, y qué reglas populares no vienen de Google, lo explicamos en dónde poner las palabras clave.
Los enlaces de otras webs
Google usa los enlaces como señal para valorar la relevancia de las páginas y para encontrar páginas nuevas. PageRank, el algoritmo que analiza los enlaces, es uno de sus algoritmos fundamentales, pero Google lo presenta como un factor de posicionamiento entre muchos.
Comprar enlaces para influir en el posicionamiento va contra las políticas de spam de Google. Los enlaces de pago están permitidos si la web que los publica los marca con rel="sponsored" o rel="nofollow". Para una web nueva, Google aconseja conseguir que otros sitios te enlacen, pero sin pagarles. Los buenos enlaces suelen premiar lo que otros quieren citar: datos propios, una plantilla, una herramienta.
Mitos que Google desmiente
La guía de Google enumera varias creencias de las que no tienes que preocuparte:
- La etiqueta meta keywords: la Búsqueda de Google no la usa.
- Palabras clave en el dominio o en la ruta de la URL: por sí solas apenas tienen efecto en el posicionamiento.
- La extensión del dominio: un .es solo importa si te diriges a usuarios de un país concreto, e incluso entonces suele ser una señal débil.
- El número de palabras: no hay mínimo ni máximo.
- Subdominio o subdirectorio: haz lo que mejor encaje con tu negocio.
- La «penalización» por contenido duplicado: el mismo contenido en varias direcciones de tu web es poco eficiente, pero no provoca una acción manual. Copiar contenido ajeno es otra historia.
- El número y el orden de los encabezados: no hay una cantidad ideal.
- El E-E-A-T como factor de posicionamiento: experiencia, conocimiento, autoridad y fiabilidad vienen de las directrices de los evaluadores humanos de Google, y no son un factor de posicionamiento. Sus sistemas sí buscan señales de estas cualidades, sobre todo en temas de salud, dinero o seguridad.
Lo que sí perjudica: el exceso de palabras clave, repetir las mismas palabras una y otra vez, que va contra las políticas de spam.
SEO y búsqueda con IA
En España, las vistas creadas con IA llegaron a la Búsqueda de Google el 26 de marzo de 2025, en español e inglés y, al principio, para usuarios mayores de 18 años que hubieran iniciado sesión. ¿Sigue sirviendo el SEO? La documentación de Google dice que sí: sus funciones de IA se basan en los mismos sistemas de posicionamiento y calidad que la búsqueda normal. No hay requisitos adicionales para aparecer en las vistas creadas con IA ni en el modo IA; la página tiene que estar indexada y poder mostrarse con un fragmento. Para Google, el AEO (optimización para buscadores de respuestas) y el GEO (para buscadores generativos) siguen siendo SEO.
Google incluye entre lo que puedes ignorar para su Búsqueda los archivos llms.txt y otros archivos especiales (no los usa, así que ni ayudan ni perjudican), trocear el contenido en pedazos pequeños, reescribir textos solo para la IA y buscar menciones poco auténticas. Los datos estructurados no son necesarios para la IA, aunque siguen siendo útiles para los resultados enriquecidos.
Desde el 31 de agosto de 2026, cualquier web puede decidir en Search Console, en Ajustes, apartado «IA generativa en la Búsqueda», si su contenido puede aparecer en las vistas creadas con IA, el modo IA y las funciones de IA generativa de Discover. La inclusión es la opción por defecto. Según Google, una exclusión suele aplicarse en uno o dos días, a veces más, y no se usa como señal de posicionamiento para el resto de la Búsqueda.
Cuánto tarda el SEO en dar resultados
No hay un plazo fijo. Google explica que algunos cambios se aplican en horas y otros tardan meses, y que en general conviene esperar unas semanas antes de valorar si tu trabajo ha servido. Además, no todos los cambios tienen un efecto visible.
Verás a menudo la cifra «de cuatro meses a un año». Aparecía, efectivamente, en la versión en inglés de la página de Google sobre contratar un especialista en SEO, pero ya no está en la versión revisada en junio de 2026, una actualización con la que, según Google, se eliminaron ejemplos obsoletos.
Para una web nueva, Google avisa de que puede tardar algunas semanas en detectarla. La nuestra se rastreó dos minutos después de enviar el sitemap, pero un día más tarde Google aún no conocía casi la mitad de nuestras direcciones. Que te encuentren y posicionar bien son pasos distintos, y Google es claro: nadie puede asegurarte el primer puesto.
Hacer SEO por tu cuenta: herramientas, ayuda y checklist
Google lo dice sin rodeos: si diriges una pequeña empresa local, probablemente puedas hacer la mayor parte del trabajo tú mismo, empezando por su Guía de SEO para principiantes. Según Google, el mejor momento para contratar a un especialista es un rediseño o el lanzamiento de una web nueva.
Si contratas a alguien, Google sugiere pedirle ejemplos de trabajos anteriores y preguntarle qué resultados espera y en qué plazo. Para una auditoría, dale solo acceso de lectura a Search Console, y desconfía de quien garantice posiciones: ninguna herramienta SEO de terceros tiene acceso a los datos internos de posicionamiento de Google.
Para empezar bastan herramientas gratuitas:
- Google Search Console: el informe de rendimiento muestra clics, impresiones, CTR (porcentaje de clics) y posición media por consulta, página, país y dispositivo; el informe de indexación de páginas muestra qué páginas están en el índice; la inspección de URLs revisa una página concreta.
- Bing Webmaster Tools: lo mismo para Bing.
- Lighthouse, en las herramientas para desarrolladores de Chrome: una prueba de laboratorio de una página.
Una primera checklist:
- Abre Search Console y Bing Webmaster Tools.
- Comprueba que no queda ninguna regla noindex ni
Disallow: /del entorno de pruebas. - Envía un sitemap XML.
- Elige para cada página importante una palabra clave principal y la intención que hay detrás.
- Dale a cada página su propio título y su propia metadescripción.
- Escribe contenido que responda mejor que los resultados actuales, con experiencia propia, y enlaza las páginas relacionadas.
- Redirige cada dirección que cambies.
- Revisa Search Console cada mes: qué búsquedas traen visitas y qué páginas faltan.
