La etiqueta canonical es una línea que va en la cabecera HTML de una página, por ejemplo <link rel="canonical" href="https://polytested.com/es/seo"/>. Sirve para decir a los buscadores cuál es la dirección principal de una página cuando el mismo contenido se puede abrir desde varias URL. Google la trata como una señal fuerte, no como una orden: suele seguirla, pero puede elegir otra URL. Casi todos los CMS la añaden solos. El 17 de octubre de 2026 comprobamos cómo responde nuestra web a 19 variantes de sus direcciones en español.
Qué es la etiqueta canonical, en pocas palabras
- Qué es: un elemento
linkconrel="canonical"dentro del<head>que indica la dirección preferida, la URL canónica. También se llama etiqueta canónica; Google llama «canonicalización» al proceso completo. - Para qué sirve: si una página existe en varias direcciones, Google solo indexa una y reúne en ella señales como los enlaces. La etiqueta le dice cuál prefieres.
- Una pista, no una orden: la documentación de Google en español lo resume así: «indicar una preferencia canónica es una sugerencia, no una regla».
- ¿En todas las páginas? Recomendable, no obligatoria. Desde julio de 2026, Google aconseja de forma expresa una etiqueta que apunte a la propia página.
- No sirve para: una página trasladada (redirección), una traducción (hreflang) ni la página 2 de un listado, que se nombra a sí misma.
Si los conceptos de rastreo e indexación son nuevos para ti, empieza por nuestra guía sobre qué es el SEO.
Cómo es la etiqueta canonical en el código
La etiqueta lleva la dirección completa, con https://. Esta es la línea que devuelve nuestra página de categoría SEO:
<link rel="canonical" href="https://polytested.com/es/seo"/>Las reglas de Google:
- Solo en el
<head>: en el<body>Google la ignora. Un elemento no válido dentro del<head>, como una imagen o uniframe, marca para Google el final de la cabecera, y una etiqueta canonical colocada después se pierde. El título de la página está en la misma zona; lo explicamos en nuestra guía sobre la etiqueta title. - URL absoluta: una ruta relativa como
/es/seose acepta, pero Google no la recomienda; da problemas, por ejemplo, si se rastrea por error un sitio de pruebas. - Una sola etiqueta por página: Google incluye las etiquetas múltiples entre los errores frecuentes.
- Comillas rectas: escribe
", nunca comillas tipográficas como ” ” ni «». En nuestra prueba del 16 de octubre de 2026, Chrome no reconoció ninguna de las dos líneas escritas con comillas curvas, solo la de comillas rectas. Los procesadores de texto suelen cambiarlas sin avisar: copia el código desde un editor de texto plano. - Cabecera HTTP para archivos: un PDF no tiene
<head>, así que el servidor puede enviarLink: <https://www.ejemplo.es/informe.pdf>; rel="canonical". Google solo la usa en la búsqueda web y aconseja elegir entre cabecera y etiqueta, porque usar las dos a la vez multiplica los errores. Según el Web Almanac 2025, solo alrededor del 0,6 por ciento de las páginas de escritorio la usa.
Google, Yahoo!, Microsoft y Ask.com anunciaron que admitían la etiqueta en febrero de 2009. Google la acepta entre dominios distintos desde diciembre de 2009, y la RFC 6596 la describió en abril de 2012.
Por qué una misma página tiene varias URL
Para Google, cada diferencia de escritura es una URL distinta. Los casos más habituales:
- Parámetros de seguimiento:
?utm_source=newsletter, los identificadores de clicfbclidde Facebook ygclidde Google Ads. - Orden y filtros:
?orden=precioen una tienda,?category=seoen nuestro blog. - Protocolo, host y escritura:
http://ohttps://, con o sinwww, con o sin barra final, con mayúsculas o sin ellas. Para Google,/APPLEy/appleson dos URL. - Tildes y eñes: en un enlace, la «ñ» se convierte en
%C3seguido de%B1, la codificación por porcentajes que Google recomienda para cualquier carácter no ASCII. Nuestras direcciones van sin tildes (/es/sobre-nosotros,paisesen lugar depaíses); escrita con tilde, la misma dirección devuelve un error 404. - Direcciones técnicas:
?p=con el número de una entrada en WordPress o, en Shopify, un producto mostrado dentro de la ruta de una colección. - Copias: versiones para imprimir, PDF, versiones de demostración accesibles por error y artículos reproducidos en otras webs.
Nuestra prueba: 19 direcciones de nuestras páginas en español
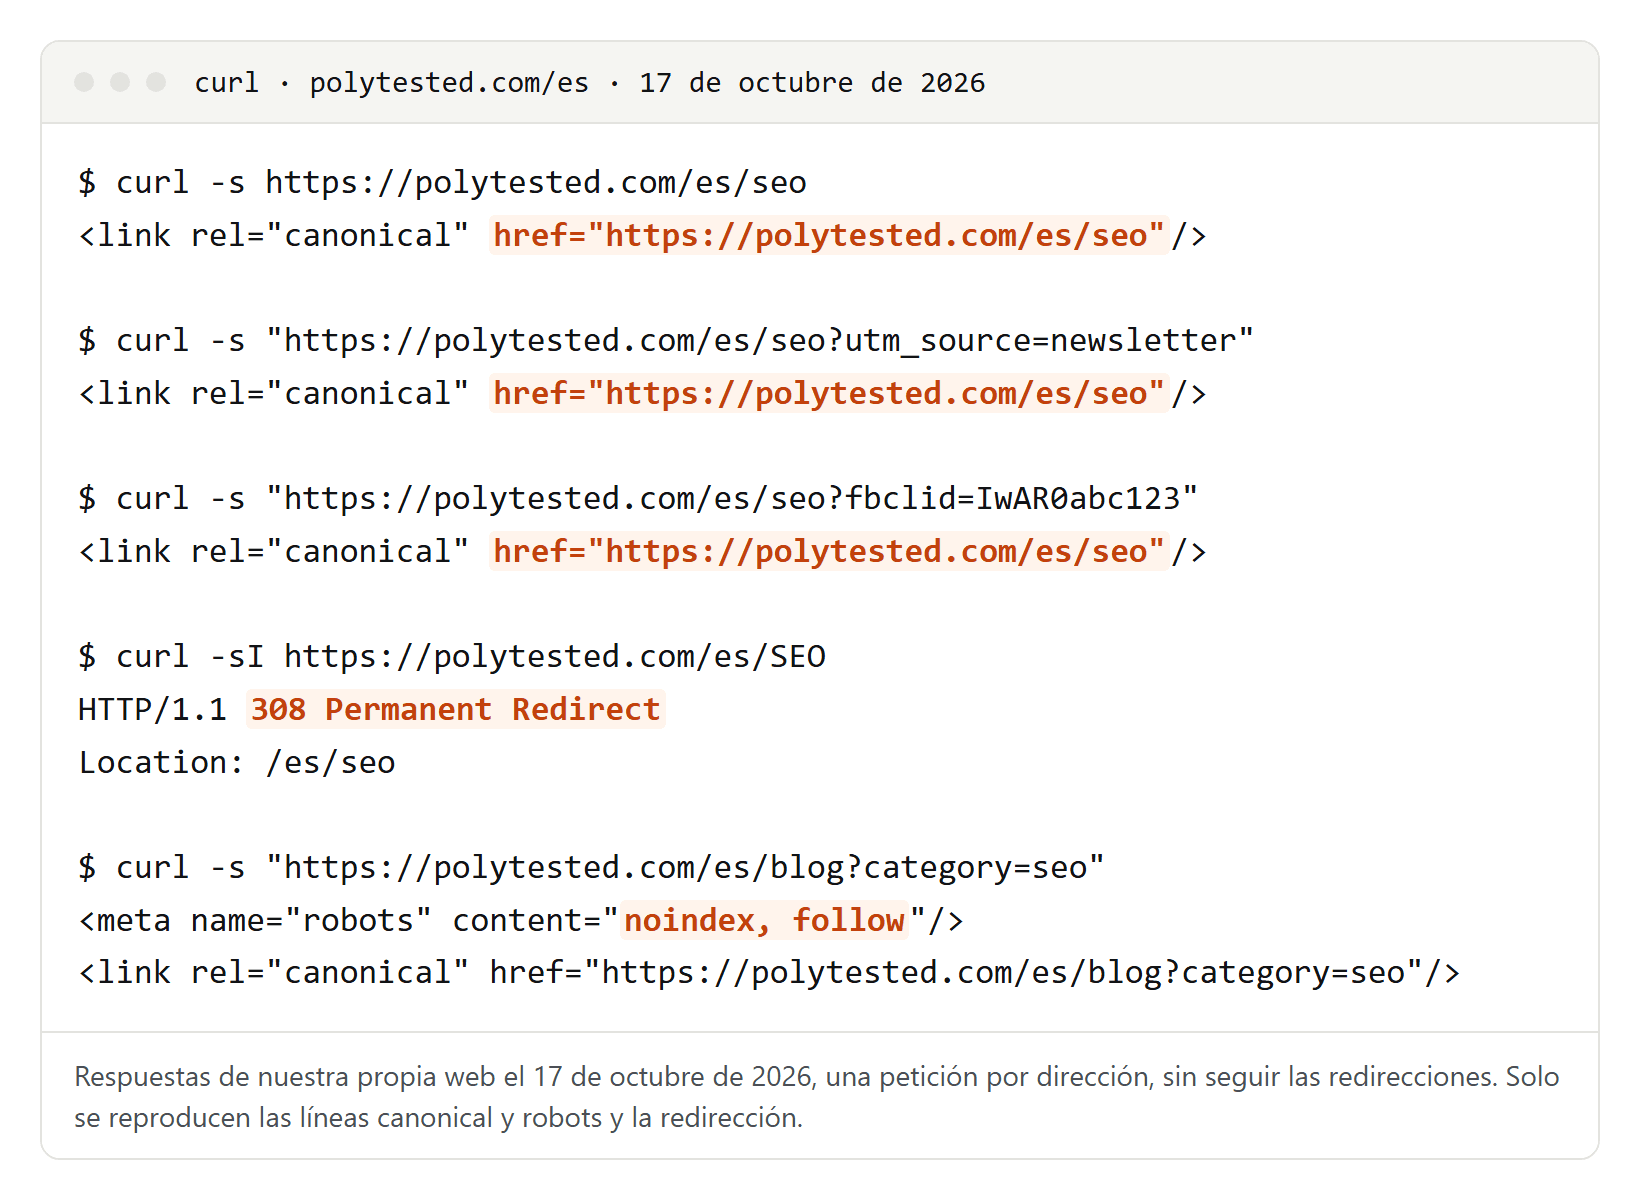
El 17 de octubre de 2026 pedimos 19 variantes de nuestras direcciones en español, una petición por dirección y sin seguir las redirecciones, a partir de nuestra página de categoría SEO, nuestra guía de hreflang, el listado del blog y la portada. Resultado:
- Parámetros de seguimiento (
utm_source,fbclid,gclid): código 200, y la etiqueta canonical indica la dirección sin parámetros. - Variantes de escritura: la barra final, las mayúsculas (también
/ES/),http://ywwwno muestran la página. Devuelven una redirección permanente 308 a la dirección única, así que la etiqueta no tiene nada que decidir. - Parámetros sin efecto:
?page=1y un parámetro inventado como?orden=recientemuestran el listado normal, con una etiqueta canonical hacia/es/blog. - El listado filtrado (
?category=seo) se nombra a sí mismo y llevanoindex, follow: no entra en el índice, pero sus enlaces se pueden seguir. - Las direcciones que no existen responden 404: la extensión
.htmly un número de página que no existe, como?page=99. Google recomienda ese código para los números de página inexistentes.
Nuestras páginas en inglés (13 de octubre) y en alemán (16 de octubre) siguen el mismo esquema; en el listado alemán, más largo, la página 2 se nombra a sí misma. Nuestro sitemap en español solo contiene direcciones sin parámetros, como pide también Bing.
Cómo elige Google la URL canónica
Google agrupa las páginas cuyo contenido principal es igual o muy parecido y elige la más completa y útil. La rastrea más a menudo que los duplicados y suele mostrarla en los resultados.
Las señales, de más fuerte a más débil:
- Redirecciones: una señal fuerte, pero solo las permanentes, como 301 y 308. Las temporales (302, 303, 307) no cuentan como señal.
rel="canonical", como etiqueta o cabecera HTTP: una señal fuerte.- Estar en el sitemap: una señal débil.
Las señales se refuerzan cuando coinciden. Google también prefiere las páginas HTTPS, las URL que forman parte de un grupo hreflang y la dirección a la que apuntan tus enlaces internos. Para los idiomas, mira nuestra guía de hreflang, x-default y canonical; para versiones por país en el mismo idioma, como España y México, Google aconseja usar canonical y hreflang juntos, tal como explica nuestra guía de SEO internacional. Después de una corrección, Google puede mantener las páginas agrupadas como duplicadas hasta dos semanas.
No hay penalización por contenido duplicado. Según Google, tener contenido duplicado en un sitio es normal y no infringe sus políticas de spam; Bing dice lo mismo. Aun así, se sigue leyendo lo contrario, incluso en la documentación de algún CMS. El riesgo real es otro: que Google muestre la dirección equivocada y que señales como los enlaces se repartan entre varias URL. Copiar textos ajenos es otra cosa, y lo tratamos en nuestra guía de SEO de sombrero blanco.
Las páginas de documentación de Google en español que consultamos están traducidas automáticamente del inglés, como indica su código fuente. Ante la duda, manda la versión inglesa.
¿Necesita cada página una canonical hacia sí misma?
Es recomendable, no obligatorio: sin indicación, Google elige solo. Desde julio de 2026, su documentación recomienda de forma expresa una etiqueta autorreferencial en la página canónica; la versión de marzo de 2026, archivada en Internet Archive, todavía no lo decía. La ventaja: si alguien abre la página con ?utm_source=…, devuelve la misma etiqueta que la dirección limpia.
Muchas veces se encarga el CMS: WordPress en entradas y páginas, Yoast, Wix y Shopify en todas, según su documentación. Según el Web Almanac 2025 de HTTP Archive, el 68 por ciento de las páginas de escritorio y el 67 por ciento de las móviles tienen una, frente al 65 por ciento un año antes. Mantén también og:url igual: el protocolo Open Graph la define como la URL canónica. En nuestras guías en español, las dos coinciden.
¿Canonical, redirección 301 o noindex?
- La dirección antigua debe desaparecer (página trasladada, slug cambiado): redirección permanente 301 o 308. Bing pide redirecciones en lugar de etiquetas canonical para el contenido trasladado. En nuestra guía sobre el rediseño de una web contamos cómo redirigimos nuestras direcciones antiguas.
- Las dos direcciones deben funcionar (parámetros de seguimiento, orden, versión para imprimir): etiqueta canonical hacia la dirección principal.
- La página no debe indexarse (búsqueda interna, listados filtrados):
noindex. - Otro idioma: hreflang, y cada versión se nombra a sí misma.
- Tu artículo reproducido por un socio: desde mayo de 2023, Google recomienda que el socio bloquee la indexación de su copia en lugar de usar una etiqueta canonical. Bing acepta una canonical hacia el original si el acuerdo con el socio lo permite.
Según Google, ni el archivo robots.txt (una dirección bloqueada puede indexarse sin su contenido) ni la herramienta de retirada de URL (oculta todas las versiones) sirven para elegir la URL canónica. Tampoco recomienda usar noindex con ese fin, porque la página desaparece de la búsqueda. Yoast, de hecho, no muestra ninguna etiqueta canonical en las páginas con noindex. Nuestro listado filtrado combina noindex, follow con una canonical hacia sí mismo: no señala ninguna otra página.
Paginación, filtros y variantes de producto
Paginación. Cada página de un listado tiene su propia URL, por ejemplo ?page=2, y su propia etiqueta canonical; Google pide no usar la primera página como canónica de las demás. La RFC 6596 explica el motivo: la página 2 no es una copia de la página 1, y lo que solo aparece más adelante puede quedarse fuera del índice. Una página «Ver todo» con el contenido completo sí puede ser la canónica. Google ya no usa rel="next" ni rel="prev".
Filtros. Los filtros por color, talla o precio generan un número casi infinito de URL. Si no deben indexarse, Google aconseja bloquear su rastreo, por ejemplo con robots.txt. rel="canonical" suele ser menos eficaz a largo plazo, aunque una etiqueta hacia la versión sin filtrar puede reducir el rastreo con el tiempo. Una combinación de filtros sin resultados debe responder 404.
Variantes. Si las variantes de un producto se distinguen por parámetros, la URL canónica es la dirección sin ellos, según la guía de Google sobre URL de comercio electrónico. Si cada variante tiene su propia URL, todas indican la URL del producto. En Search Console, estas variantes aparecen como duplicadas o alternativas; según la ayuda, suele ser buena señal.
WordPress, Shopify y Wix: quién escribe la etiqueta
- WordPress muestra una etiqueta canonical desde la versión 2.9, pero solo en entradas, páginas y adjuntos, no en categorías ni etiquetas. Además, redirige algunas variantes, como una barra final que falta o
?p=con el número de una entrada. - Yoast SEO añade la etiqueta automáticamente. Para cambiarla en una entrada, página, categoría o etiqueta: pestaña «Avanzado» de Yoast, campo «URL canónica», con la dirección completa.
- Rank Math: campo «URL canónica», en la pestaña «Avanzado» de su caja meta de SEO. Si lo dejas vacío, usa la dirección de la entrada.
- Shopify añade automáticamente etiquetas canónicas para que el contenido duplicado no aparezca en los resultados, según su centro de ayuda; los temas disponen del objeto Liquid
canonical_url. - Wix crea en cada página una canonical hacia sí misma y recomienda no cambiarla: si modificas la predeterminada, la página puede desaparecer del mapa del sitio.
El 16 de octubre de 2026 probamos las mismas variantes en una tienda Shopify y en el blog de una agencia web con WordPress y Yoast, dos webs alemanas:
| Variante | polytested.com | Tienda Shopify | Blog WordPress + Yoast |
|---|---|---|---|
Parámetro utm_source | 200, canonical sin parámetro | 200, canonical sin parámetro | 200, canonical sin parámetro |
| Mayúsculas | 308 a minúsculas | 200, canonical en minúsculas | 200, canonical en minúsculas |
| Barra final | 308 a la dirección sin barra | 200, canonical sin barra | sin barra: 301 a la dirección con barra |
http:// | 308 a https:// | no probado | 200, canonical en https:// |
www | 308 a la dirección sin www | sin www: 301 a www | 301 a la dirección sin www |
| Página 2 de un listado | se nombra a sí misma (listado alemán) | se nombra a sí misma | se nombra a sí misma |
| Orden o filtro | filtro: noindex, follow, canonical hacia sí mismo | canonical a la colección sin parámetro | búsqueda interna: noindex, follow, sin canonical |
Todas tratan igual los parámetros de seguimiento; las diferencias están en la escritura. Según Google, que respondan dos versiones es legítimo, pero es mejor redirigir. En las dos tiendas Shopify que probamos, un producto abierto desde una colección (/collections/<coleccion>/products/<producto>) indicaba /products/<producto>. No sabemos si el blog de WordPress sirve así la versión http:// a todos los visitantes.
Errores que hacen que Google ignore la etiqueta
- Varias etiquetas en una página, cuando el tema y un plugin añaden una cada uno.
- Una dirección incompleta:
ejemplo.es/paginasinhttps://se lee como una ruta de tu propia web. Google cita este error en su artículo de 2013 sobre cinco errores comunes con rel=canonical. - Un destino que redirige, da error o indica otra canonical: la RFC 6596 lo desaconseja. Apunta a la dirección final.
- Una categoría que señala un solo artículo: la categoría desaparece de los resultados, otro error de la lista de Google.
- Atributos de más: Google no tiene en cuenta para elegir la URL canónica una etiqueta
rel="canonical"que también llevehreflang,lang,mediaotype. - JavaScript que cambia la etiqueta: Google quiere encontrarla igual en el HTML. Según el Web Almanac 2025, el renderizado la cambia en el 2,7 por ciento de las páginas de escritorio y el 3,0 por ciento de las móviles.
- Enlaces internos contradictorios: enlaza a la dirección canónica, no a una variante.
Cómo comprobar qué URL canónica ha elegido Google
- El código fuente:
view-source:delante de la dirección o Ctrl+U, y busca «canonical»: una sola coincidencia, en el<head>. Las herramientas para desarrolladores (F12) muestran el estado después de JavaScript; Google las recomienda cuando un CMS o un plugin genera etiquetas erróneas. - Las redirecciones:
curl -Iseguido de la dirección muestra el código y el destino sin seguir la redirección. Así encuentras los 302 y 307 donde debería haber un 301 o un 308. - La herramienta de inspección de URLs de Search Console: en «Indexación de páginas», compara «Declarada por el usuario como canónica» y «Seleccionada por Google como canónica». La prueba en tiempo real («Probar URL publicada») no puede predecir si una versión será canónica; solo lo muestra el resultado del índice.
- El informe de indexación de páginas, tres estados:
- «Página alternativa con etiqueta canónica adecuada»: la página dirige bien a una canónica indexada. No hay nada que hacer. Search Console no detecta las páginas en otros idiomas.
- «Duplicada: el usuario no ha indicado ninguna versión canónica»: no has declarado preferencia y Google ha elegido otra página. No es un error; si se equivoca, declara una canónica o haz que las páginas sean claramente distintas.
- «Duplicada: Google ha elegido una versión canónica diferente a la del usuario»: Google no sigue tu etiqueta. Compara los dos campos. Una canónica que no se parece a la página nunca se elige.
- Los nombres vienen de las páginas de ayuda en español, que avisan de que pueden incluir traducciones hechas con IA. Con menos de unas 500 páginas, probablemente no necesites este informe, según Google.
- Ningún ajuste: en Search Console no se declara la URL canónica; el ajuste de dominio preferido desapareció en 2019 y la herramienta de parámetros de URL, en 2022.
- Después de corregir: «Solicitar indexación» tiene cuotas, resérvala para las direcciones importantes.
Lista de comprobación
- Cada página indexable se nombra a sí misma, con la dirección completa en
https://. - Una sola etiqueta por página, en el
<head>, antes de cualquier elemento no válido y con comillas rectas. http,www, barra final y mayúsculas redirigen con 301 o 308 a una única escritura.- Los parámetros de seguimiento y de orden indican la dirección sin parámetros.
- Las páginas 2 y siguientes, igual que las traducciones, se nombran a sí mismas.
- Enlaces internos, sitemap y etiqueta canonical citan la misma dirección.
- Ninguna canonical hacia una dirección que redirige, da error o lleva noindex.
- Una sola fuente escribe la etiqueta, y la herramienta de inspección de URLs confirma la elección de Google.
