Le SEO (Search Engine Optimization), qu'on appelle aussi référencement naturel, regroupe tout ce qui aide un moteur de recherche comme Google ou Bing à trouver vos pages, à les comprendre et à les afficher dans ses résultats gratuits, puis donne envie de cliquer. Il repose sur trois piliers : la technique (le moteur peut-il lire la page ?), le contenu (la page répond-elle à la question ?) et les liens venus d'autres sites. Les annonces payantes n'en font pas partie. Nous expliquons chaque pilier simplement, avec notre propre site, ouvert aux moteurs de recherche le 13 octobre 2026.
Le SEO, c'est quoi exactement ?
Google donne lui-même la définition dans son guide « Bien débuter en référencement naturel (SEO) » : le SEO consiste à aider les moteurs de recherche à interpréter votre contenu, et à aider les internautes à trouver votre site et à décider s'ils doivent s'y rendre depuis un moteur de recherche. La personne qui fait ce travail s'appelle un référenceur ; la page de Google consacrée au recrutement d'un professionnel s'intitule d'ailleurs « Avez-vous besoin d'un référenceur ? ».
Le SEO concerne les résultats naturels, ceux qu'on ne paie pas. Google écrit qu'il n'accepte en aucun cas d'inclure ou de classer des sites contre rémunération, et que faire de la publicité chez lui n'a aucun effet sur la présence d'un site dans ces résultats. Les annonces payantes forment un canal à part, souvent appelé SEA (Search Engine Advertising). Vous croiserez aussi le sigle SEM (Search Engine Marketing) : il désigne surtout la publicité sur les moteurs, parfois l'ensemble des deux. Demandez à votre interlocuteur ce qu'il entend par là.
Pourquoi le SEO compte
En France, presque toutes les recherches passent par Google. StatCounter, qui compte les visites arrivant sur plus d'un million de sites équipés de son code de suivi, attribuait en septembre 2026 à Google 88,16 pour cent des visites venues d'un moteur de recherche, à Bing 5,47 pour cent, à Ecosia 1,34 pour cent et à Qwant 0,86 pour cent. Sur ordinateur, Bing atteint 15,79 pour cent : si vos lecteurs travaillent devant un écran, par exemple en B2B, ouvrez aussi un compte Bing Webmaster Tools.
Les clics venus des résultats naturels sont gratuits, et une page utile attire des visiteurs bien après qu'une annonce s'est arrêtée faute de budget. La contrepartie : rien n'est garanti. Google précise qu'il ne garantit ni l'exploration, ni l'indexation, ni l'affichage d'une page, même si elle respecte toutes ses règles de base.
Comment Google trouve, indexe et classe les pages
Google décrit la recherche en trois étapes, et toutes les pages ne les franchissent pas :
- L'exploration. Googlebot télécharge les textes, images et vidéos des pages. Il découvre de nouvelles adresses grâce aux liens des pages qu'il connaît déjà et grâce aux sitemaps qu'on lui soumet. Au passage, il affiche la page et exécute son JavaScript avec une version récente de Chrome.
- L'indexation. Google analyse le contenu, dont l'élément
<title>et le texte alternatif des images, puis range les informations dans son index. Il regroupe aussi les pages au contenu similaire et choisit la plus représentative, la page canonique. L'indexation n'est pas garantie non plus. - La diffusion des résultats. À chaque recherche, Google cherche les pages correspondantes dans l'index et affiche celles qu'il juge les plus pertinentes. Selon lui, la pertinence dépend de centaines de facteurs, dont la zone géographique, la langue et l'appareil de l'internaute.
Un détail compte pour un site français : le robot de Google explore en général depuis les États-Unis. Si vos pages changent selon la localisation du visiteur, vérifiez ce que Google voit depuis là-bas. Et aucun paiement ne fait explorer un site plus souvent ni ne l'aide à mieux se classer, insiste Google.
Ce qu'un moteur de recherche lit sur notre page
Un robot ne regarde pas d'abord la mise en page : il lit le code HTML. Voici le haut de l'un de nos guides en français, tel qu'un robot le récupère :
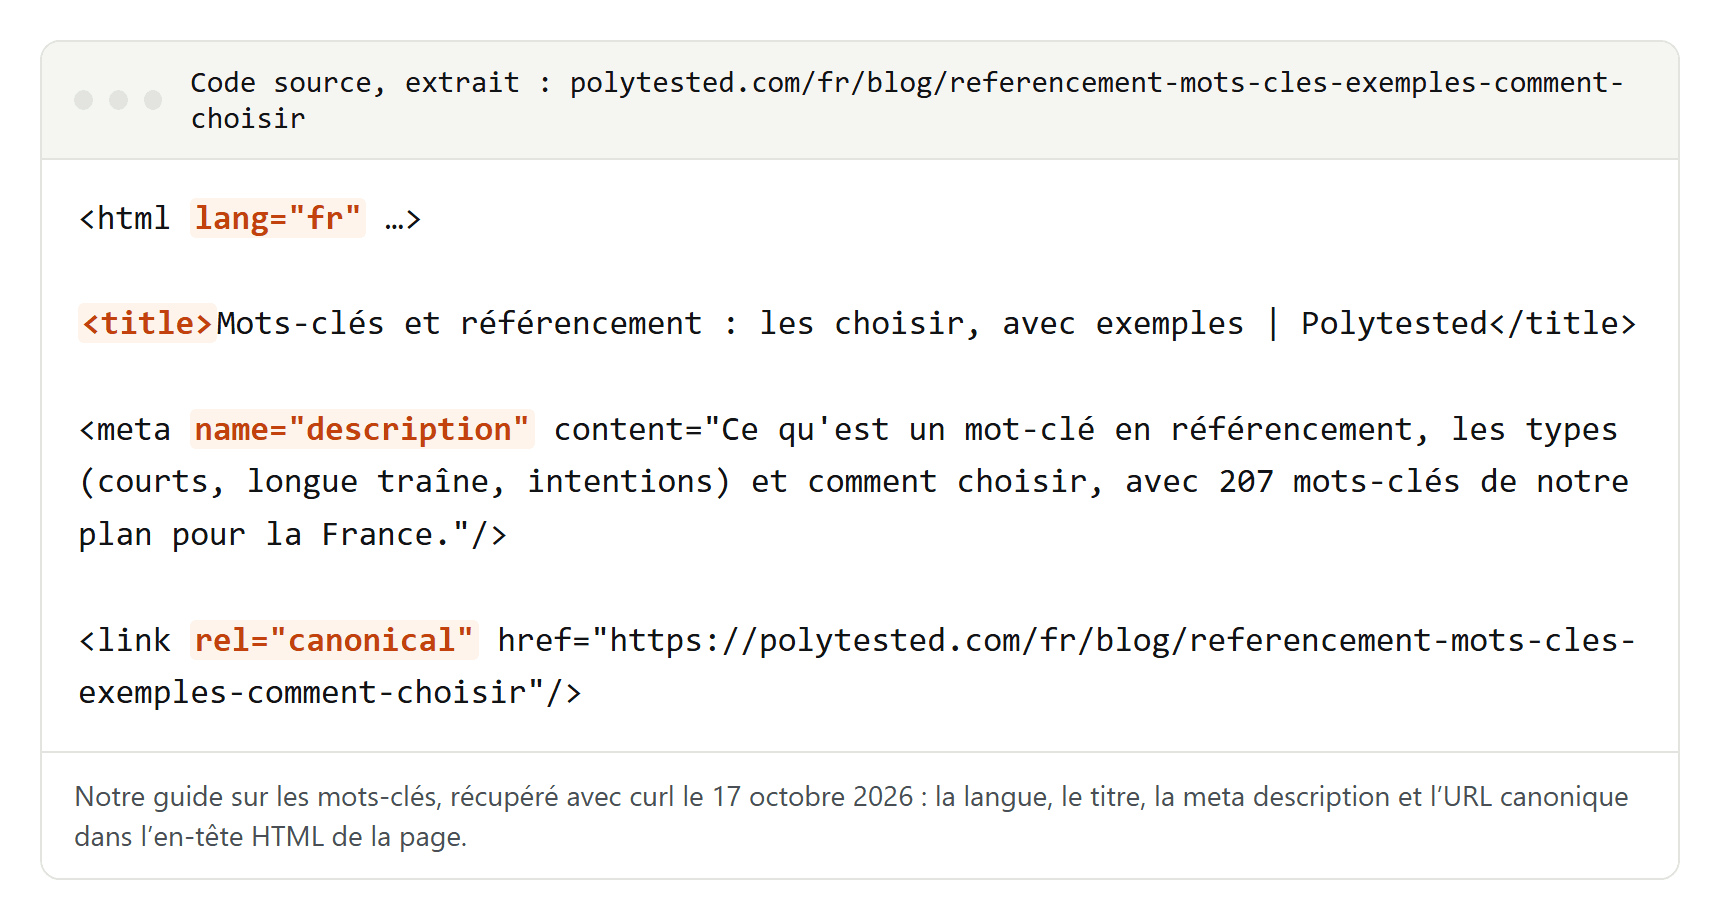
Ligne par ligne :
- La langue :
lang="fr"déclare que la page est en français. - Le titre : il s'affiche dans l'onglet du navigateur et sert de source principale au lien de titre dans les résultats, même si Google peut aussi puiser dans les intertitres. Il est plus court que le titre visible de l'article, « Mots-clés et référencement : comment les choisir, avec des exemples » : les deux n'ont pas à être identiques. Google demande un titre propre à la page, clair, concis et fidèle.
- La meta description : un résumé d'une ou deux phrases. Google s'en sert parfois pour l'extrait, la description sous le titre, mais le tire le plus souvent du texte de la page.
- La balise canonical : la page désigne sa propre adresse comme adresse préférée. Cela devient important dès qu'un contenu est accessible à plusieurs adresses ; notre guide sur la balise canonical montre dans quels cas.
Plus bas, la même page indique ses versions anglaise, allemande et espagnole avec des balises hreflang, expliquées dans notre guide sur la balise hreflang. Pour voir tout cela sur n'importe quel site, affichez le code source de la page : Ctrl+U dans Chrome, Edge ou Firefox sous Windows.
Le deuxième fichier que demande tout robot est le robots.txt. Le nôtre, le même jour :
User-Agent: *
Allow: /
Disallow: /admin$
Disallow: /admin/
Disallow: /api/
Disallow: /go/

Sitemap: https://polytested.com/sitemap.xml
Il autorise l'exploration de tout le site, sauf l'espace d'administration, l'API et nos liens de redirection sortants, et il indique le sitemap. Le nôtre est un index qui renvoie vers un sitemap par langue ; le 17 octobre 2026, le sitemap français listait 27 adresses.
Ce qui s'est passé quand nous avons ouvert notre site à Google
Jusqu'au lancement, chaque réponse de notre serveur portait une règle noindex, et le robots.txt autorisait l'exploration sans mentionner de sitemap. L'exploration devait rester ouverte : Google ne respecte une règle noindex que sur une page qu'il a le droit de récupérer. Notre checklist de migration SEO explique comment protéger une préproduction sans saboter le lancement. Le jour J, un seul interrupteur et une reconstruction du site ont levé la règle. Voici la suite :
| Heure | Ce qui s'est passé |
|---|---|
| 13 oct., 19 h 14 | Lighthouse teste la page d'accueil, noindex encore actif : score SEO de 69 sur 100. Seul contrôle échoué : « Page is blocked from indexing ». |
| 13 oct., 19 h 29 | Nous reconstruisons le site avec l'indexation activée. |
| 13 oct., 19 h 32 | Nouveau test Lighthouse : score SEO de 100. |
| 13 oct., 19 h 40 | Nous soumettons l'index des sitemaps dans la Search Console. Google le télécharge quatre secondes plus tard. |
| 13 oct., 19 h 42 | Googlebot pour smartphone explore la page d'accueil et la page du blog. Les deux seront indexées. |
| 14 oct., vers 16 h 40 | Nous vérifions les 86 adresses de nos sitemaps avec l'outil d'inspection d'URL de la Search Console. |
Le résultat, un jour après le lancement :
| Langue | Adresses | Indexées | « Détectée, actuellement non indexée » | Inconnues de Google |
|---|---|---|---|---|
| Anglais | 41 | 13 | 12 | 16 |
| Allemand | 27 | 7 | 0 | 20 |
| Français | 9 | 6 | 2 | 1 |
| Espagnol | 9 | 1 | 5 | 3 |
| Total | 86 | 27 | 19 | 40 |
À ce moment, nous n'avions encore publié aucun guide en français : nos neuf adresses françaises étaient la page d'accueil et des pages institutionnelles. Six étaient indexées (à propos, charte éditoriale, mentions légales, liens affiliés, notre méthode, page de l'auteur), mais la page d'accueil /fr était encore inconnue de Google. Pour cinq des six pages indexées, la Search Console indiquait que Google les avait trouvées par le sitemap allemand ou par une autre version linguistique de la même page. Google a donc surtout découvert nos pages françaises par les liens entre versions linguistiques, dont les balises hreflang de nos sitemaps ; notre guide du SEO international détaille cette organisation.
Autres leçons : l'exploration commence vite, mais l'indexation se fait page par page, et les 27 pages indexées avaient toutes été explorées par le robot pour smartphone. Être indexé ne veut pas dire être vu : le 14 octobre, la Search Console n'affichait aucune impression ; le 16 octobre, tout le site en comptait 437, pour 2 clics.
Le SEO technique : être trouvé et compris
L'essentiel pour que les moteurs atteignent et lisent vos pages :
- Laisser entrer les robots. Google cite trois problèmes d'exploration fréquents : les erreurs du serveur, les problèmes de réseau et les règles du robots.txt qui bloquent Googlebot.
- Distinguer noindex et robots.txt. Une règle noindex tient une page hors de l'index. Le robots.txt bloque seulement l'exploration, et une adresse bloquée peut quand même apparaître dans les résultats si d'autres pages renvoient vers elle.
- Soumettre un sitemap. Il aide Google à découvrir vos adresses, sans garantir leur exploration. Selon Google, un site récent avec peu de liens externes en profite particulièrement, alors qu'un petit site d'environ 500 pages ou moins, bien relié en interne, peut s'en passer.
- Une adresse par contenu. Si une page répond à plusieurs adresses, Google en choisit une ; la balise canonical indique votre préférence. Si une adresse change, redirigez l'ancienne de façon permanente.
- Penser mobile d'abord. Google indexe et classe la version mobile des pages, explorée avec son robot pour smartphone.
- Surveiller les Core Web Vitals. Les objectifs de Google : un affichage du plus grand élément (LCP) dans les 2,5 premières secondes, une réaction aux interactions (INP) en moins de 200 millisecondes et un décalage de mise en page (CLS) inférieur à 0,1. Au lancement, Lighthouse a mesuré en laboratoire un LCP de 2,1 secondes et aucun décalage sur notre page d'accueil.
Selon Google, de bonnes Core Web Vitals vont dans le sens de ce que ses systèmes de classement récompensent ; elles ne remplacent pas une bonne réponse.
Le contenu et le SEO on-page : répondre à la question derrière la recherche
La technique fait entrer une page dans l'index ; le contenu décide de sa place. Google demande des contenus créés d'abord pour les internautes, pas pour manipuler le classement. Parmi ses questions d'auto-évaluation : le contenu montre-t-il une expertise de première main ? Le lecteur repartira-t-il assez instruit pour atteindre son objectif ?
Concrètement :
- Choisissez un mot-clé principal par page et cherchez ce que veulent ceux qui le tapent. Quelqu'un qui cherche « modèle compte rendu de réunion » veut d'abord un modèle, pas une dissertation. Notre guide sur les mots-clés en référencement explique volume, difficulté et intention.
- Montrez votre propre travail. Mesures, captures et exemples maison distinguent une page de cent pages semblables.
- Donnez à chaque page son titre et sa meta description. Nous plaçons le mot-clé principal vers le début du titre.
- Structurez le texte avec des intertitres. Selon Google, leur ordre ne compte pas pour la recherche, mais un ordre logique aide les lecteurs d'écran.
- Soignez les URL, le texte alternatif des images et le texte des liens entre vos propres pages : des mots clairs, en français.
Où placer le mot-clé à chacun de ces endroits, et quelles règles répandues ne viennent pas de Google : c'est le sujet de notre guide sur le placement des mots-clés.
Les liens venant d'autres sites
Google utilise les liens comme signal pour juger de la pertinence des pages et pour trouver de nouvelles pages. PageRank, l'algorithme qui exploite les liens, fait partie de ses algorithmes fondamentaux, mais Google le présente comme un signal de classement parmi beaucoup d'autres.
Acheter des liens pour influencer le classement relève du spam selon les règles de Google. Les liens payants sont acceptés si le site qui les publie les marque avec rel="sponsored" ou rel="nofollow". Pour un nouveau site, Google conseille de se faire citer par d'autres sites, mais sans les payer. Les bons liens récompensent en général ce que d'autres veulent citer : des données originales, un modèle, un outil.
Les idées reçues que Google dément
Le guide de Google énumère plusieurs croyances dont vous n'avez pas à vous soucier :
- La balise meta keywords : la recherche Google ne l'utilise pas.
- Les mots-clés dans le nom de domaine ou le chemin de l'URL : seuls, ils n'ont pratiquement aucun effet sur le classement.
- L'extension du domaine : un .fr n'a d'importance que si vous visez les internautes d'un pays précis, et même alors c'est généralement un signal faible.
- Le nombre de mots : il n'existe ni minimum ni maximum.
- Sous-domaine ou sous-répertoire : faites ce qui convient à votre activité.
- La « pénalité » pour contenu en double : le même contenu à plusieurs adresses de votre site est inefficace, mais n'entraîne pas d'action manuelle. Copier le contenu des autres, c'est une autre histoire.
- Le nombre et l'ordre des titres : il n'y a pas de nombre idéal.
- L'E-E-A-T comme facteur de classement : expérience, expertise, autorité et fiabilité viennent des consignes destinées aux évaluateurs humains de Google, et ce n'est pas un facteur de classement. Ses systèmes repèrent toutefois ces qualités, surtout sur la santé, les finances ou la sécurité.
Ce qui nuit vraiment : le bourrage de mots-clés, la répétition des mêmes mots encore et encore, contraire aux règles de Google sur le spam.
SEO et recherche par IA
En France, les Aperçus IA et le Mode IA sont arrivés dans la recherche Google le 22 juillet 2026, bien après d'autres pays. Le SEO sert-il encore ? La documentation de Google répond oui : ses fonctionnalités d'IA reposent sur les mêmes systèmes de classement et de qualité que la recherche classique. Aucune exigence supplémentaire n'est requise pour y apparaître ; la page doit être indexée et pouvoir s'afficher avec un extrait. L'AEO (optimisation pour les moteurs de réponse) et le GEO (pour les moteurs génératifs) restent, pour Google, du SEO.
Google range parmi les astuces inutiles pour sa recherche le fichier llms.txt et les autres fichiers spéciaux (ignorés, donc ni nuisibles ni utiles), le « découpage » du contenu en petits morceaux, la réécriture spéciale pour l'IA et la recherche de mentions artificielles. Les données structurées ne sont pas requises pour l'IA, mais restent utiles pour les résultats enrichis.
Vous gardez la main : le jour du lancement en France, Google a ouvert un réglage dans la Search Console, étendu à tous les sites du monde le 31 août 2026. Sous Paramètres, puis « IA générative dans la Recherche », vous choisissez si votre contenu peut apparaître dans les Aperçus IA, le Mode IA et l'IA générative de Discover. L'inclusion est le réglage par défaut ; une exclusion agit en général en un ou deux jours et ne sert pas de signal de classement pour le reste de la recherche, selon Google.
Combien de temps faut-il pour voir des résultats ?
Pas de délai fixe. Google indique que certaines modifications prennent effet en quelques heures et d'autres en plusieurs mois, et qu'il vaut mieux attendre en général quelques semaines avant d'évaluer l'effet de votre travail. Toutes les modifications n'ont d'ailleurs pas d'impact visible.
Vous lirez souvent « de quatre mois à un an ». Ce chiffre figurait bien sur la page de Google consacrée au recrutement d'un référenceur, dans sa version anglaise ; il a disparu de la version révisée en juin 2026, une mise à jour qui, selon Google, a retiré des exemples périmés.
Pour un nouveau site, Google prévient que quelques semaines peuvent être nécessaires avant qu'il le détecte. Le nôtre a été exploré deux minutes après l'envoi du sitemap, mais un jour plus tard, Google ignorait encore près de la moitié de nos adresses. Être trouvé et être bien classé sont deux étapes différentes, et Google est clair : personne ne peut garantir la première position.
Faire son SEO soi-même : outils, aide et checklist
Google le dit sans détour : si vous gérez une petite entreprise locale, vous pourrez probablement faire l'essentiel vous-même, en commençant par son guide Bien débuter en référencement naturel. Selon Google, le meilleur moment pour faire appel à un référenceur est une refonte ou le lancement d'un nouveau site.
Si vous en recrutez un, demandez-lui, comme le suggère Google, des exemples de travaux et quels résultats il attend, dans quel délai. Pour un audit, donnez-lui seulement un accès en lecture à la Search Console, et fuyez les promesses de classement garanti : aucun outil SEO tiers n'a accès aux données de classement internes de Google.
Des outils gratuits suffisent pour commencer :
- La Google Search Console : le rapport sur les performances donne les clics, les impressions, le CTR (taux de clics) et la position moyenne par requête, page, pays et appareil ; le rapport sur l'indexation des pages montre quelles pages sont dans l'index ; l'outil d'inspection d'URL vérifie une page précise.
- Bing Webmaster Tools : l'équivalent pour Bing.
- Lighthouse, dans les outils de développement de Chrome : un test en laboratoire d'une page.
Une première checklist :
- Ouvrir la Search Console et Bing Webmaster Tools.
- Vérifier qu'aucune règle noindex ni
Disallow: /de la préproduction n'est restée. - Soumettre un sitemap XML.
- Choisir pour chaque page importante un mot-clé principal et l'intention qui va avec.
- Donner à chaque page son propre titre et sa propre meta description.
- Écrire des contenus qui répondent mieux que les résultats actuels, avec votre propre expérience, et relier les pages voisines.
- Rediriger chaque adresse que vous changez.
- Consulter la Search Console chaque mois : quelles recherches amènent des visiteurs, quelles pages manquent.
