Une transcription avec horodatage relie chaque passage du texte à un moment de l'enregistrement. À côté d'une phrase, vous lisez par exemple [00:12:41] et vous retrouvez aussitôt l'endroit pour le réécouter. On place ces repères à chaque changement de locuteur, à intervalle régulier ou à côté d'un mot inaudible. Le code temporel, qui compte aussi les images, sert au montage vidéo, et un fichier de sous-titres demande un début et une fin pour chaque ligne. Nous montrons un même extrait d'entretien inventé dans tous ces formats, avec les outils qui les produisent.
Horodatage, minutage, code temporel : de quoi parle-t-on ?
Un horodatage indique à quelle distance du début de l'enregistrement se trouve un passage : [00:12:41] signifie douze minutes et 41 secondes après le début. Ce n'est pas l'heure de l'horloge : un entretien commencé à 14 heures démarre quand même à 00:00:00 dans la transcription.
Le vocabulaire change d'un outil à l'autre. Microsoft parle d'« horodatage » dans Word et dans Teams, oTranscribe de « minutage », l'aide de YouTube de « codes temporels ». Dans une transcription, ces mots désignent la même chose. Trois notions sont en revanche à distinguer :
- L'horodatage : heures, minutes et secondes écoulées depuis le début, parfois avec une fraction de seconde. Il sert à retrouver un passage.
- Le code temporel SMPTE : il numérote en plus chaque image d'une vidéo, au format
hh:mm:ss:ff. Il sert au montage. - Le sous-titre : chaque bloc d'un fichier SRT ou WebVTT a une heure de début et une heure de fin. Il est fait pour s'afficher à l'écran, pas pour être lu ou cité.
Un même extrait, quatre façons de noter le temps
Pour comparer les formats, nous avons inventé un court extrait d'entretien avec Nadia, trésorière d'un club sportif, et un minutage lui aussi inventé. Voici deux interventions, d'abord avec un repère à chaque prise de parole, puis en code temporel :
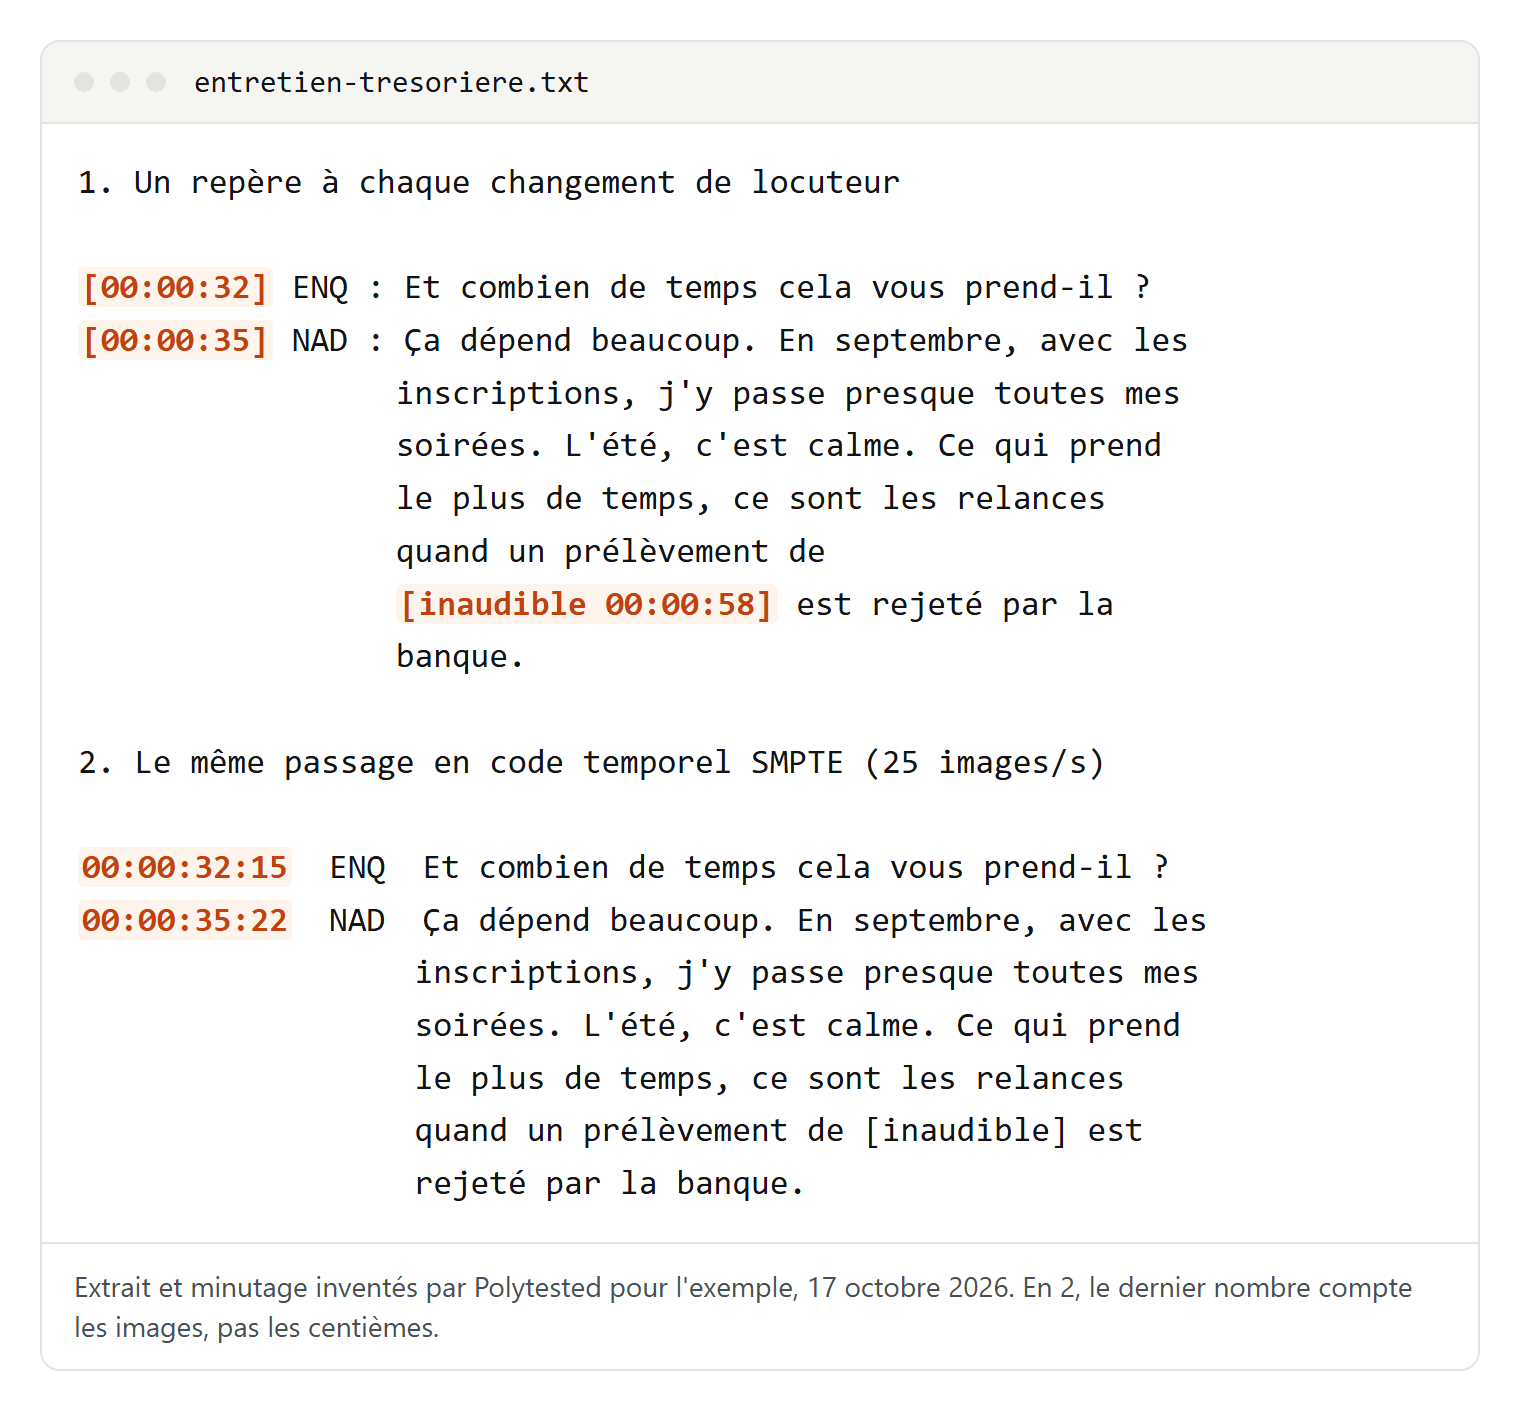
À chaque changement de locuteur. Le repère se place au début de chaque intervention. C'est la forme la plus courante pour les entretiens et les réunions, parce que chaque prise de parole peut être retrouvée. Le mot que l'on n'a pas compris reçoit son propre repère, ici [inaudible 00:00:58], pour qu'une deuxième personne réécoute exactement cet endroit.
À intervalle régulier. Un repère toutes les trente secondes ou toutes les deux minutes, quelle que soit la personne qui parle. Il peut tomber au milieu d'une phrase :
[00:00:00] ENQ : Comment êtes-vous devenue trésorière du club ?

NAD : Un peu par hasard. À l'assemblée générale, personne ne voulait reprendre la trésorerie, et je travaille dans la comptabilité. Alors j'ai levé la main. [elle rit] Depuis, je gère les adhésions, les cotisations et, une fois par an, le [00:00:30] rapport financier.
Ce rythme convient aux conférences, aux cours et aux longs monologues.
En code temporel. Heures, minutes, secondes et images. Avec 25 images par seconde, 00:00:35:22 veut dire 35 secondes et 22 images, et non 22 centièmes. C'est ainsi que comptent les logiciels de montage.
Mot par mot. La reconnaissance vocale peut enregistrer un début et une fin pour chaque mot. Les outils de montage et de sous-titrage s'en servent ; un lecteur, presque jamais.
Le même extrait en fichier SRT
Une transcription se lit, un fichier de sous-titres s'affiche. La différence saute aux yeux quand on transforme l'une en l'autre. Premier essai : un sous-titre par intervention.
1
00:00:02,400 --> 00:00:06,100
Comment êtes-vous devenue trésorière du club ?

2
00:00:06,900 --> 00:00:31,800
Un peu par hasard. À l'assemblée générale, personne ne voulait reprendre la trésorerie, et je travaille dans la comptabilité. Alors j'ai levé la main. [elle rit] Depuis, je gère les adhésions, les cotisations et, une fois par an, le rapport financier.
Deux problèmes apparaissent :
- Il manque les heures de fin. Une transcription avec un repère au début de chaque intervention ne donne que le début de la suivante. Nous avons pris la fin de l'intervention, que seul notre minutage inventé connaît.
- Le bloc est beaucoup trop long : 251 caractères, affichés près de 25 secondes. Lors de notre test du 15 octobre 2026, Chrome a affiché la version allemande de cette réponse comme un bloc de quatre lignes sur le quart inférieur de l'image.
Découpée en sous-titres de deux lignes de 42 caractères au plus, la réponse commence ainsi :
2
00:00:06,900 --> 00:00:14,410
Un peu par hasard. À l'assemblée générale,
personne ne voulait reprendre la

3
00:00:14,410 --> 00:00:21,820
trésorerie, et je travaille dans la
comptabilité. Alors j'ai levé la main.
Les heures intermédiaires sont des estimations : nous avons réparti la durée de la réponse selon la longueur des mots. Et la coupure « reprendre la / trésorerie » tombe mal. Mieux vaut laisser un outil qui analyse le son créer les sous-titres, puis corriger les lignes dans un éditeur. Le format et l'encodage des accents sont expliqués dans notre guide du fichier SRT, le chemin inverse dans convertir un SRT en texte. Notre test a aussi montré que Chrome refuse un fichier SRT comme piste de sous-titres : il ne lit que le WebVTT.
Quel rythme choisir ?
- Entretien de recherche : un repère à chaque changement de locuteur, plus un à chaque passage inaudible. MAXQDA, logiciel d'analyse qualitative, recommande pour les transcriptions faites ailleurs au moins un repère à la fin de chaque paragraphe et un autre dans les passages difficiles à comprendre. Demandez à votre laboratoire ou à votre direction de recherche s'il existe une consigne. Conventions et RGPD : voir notre guide sur la retranscription d'un entretien.
- Conférence, cours, long monologue : un repère toutes les une à deux minutes.
- Réunion : Teams et Zoom notent l'heure à chaque intervention. Si seules les décisions comptent, un compte rendu de réunion sera plus utile.
- Vidéo à monter : le code temporel, à la cadence d'images du fichier vidéo.
- Sous-titres : un fichier SRT ou WebVTT, avec un début et une fin par bloc.
- Très long enregistrement : un sommaire avec des plages horaires, par exemple de
01:10:12à01:13:34pour un thème, puis seulement les passages utiles mot à mot.
Un même instant, onze écritures
Chaque logiciel écrit le même moment à sa façon. Nous avons converti un instant, une heure, deux minutes et 3,48 secondes après le début, dans les notations relevées dans les pages d'aide, les manuels et nos propres tests :
| Outil ou format | Notation | Source |
|---|---|---|
| Repère classique (noScribe, Rev, Transcribe) | [01:02:03] | aide de MAXQDA, site de noScribe |
| f4transkript, f4x (logiciels allemands) | #01:02:03-4# | aide de MAXQDA |
| MAXQDA Transcription | [1:02:03.4] | aide de MAXQDA |
| HappyScribe, transcription automatique | [01:02:03.480] | aide de MAXQDA |
| Panneau de transcription de YouTube | 1:02:03 | notre relevé, octobre 2026 |
| oTranscribe | 1:02:03, et 00:58 sous une heure | notre test, 15 octobre 2026 |
| Sous-titres SRT | 01:02:03,480 | format SubRip |
| Sous-titres WebVTT | 01:02:03.480 | spécification du W3C |
| Whisper, fichier TSV | 3723480, en millisecondes | code source de Whisper |
| Code temporel, 25 images par seconde | 01:02:03:12 | norme de l'UER |
| Code temporel drop-frame, 29,97 images par seconde | 01:02:03;14 | calcul selon SMPTE |
Ce qu'il faut retenir :
- Les heures. YouTube et oTranscribe les omettent sous une heure (
0:58,00:58). Les notations génériques que MAXQDA accepte à l'import les comportent toutes. - Virgule ou point. Le SRT sépare les millisecondes par une virgule, le WebVTT par un point. Inverser les deux donne un fichier défectueux.
- Le chiffre après le tiret. Les documents de f4 et de MAXQDA que nous avons lus ne disent pas ce qu'il représente : c'est une fraction de seconde, probablement le dixième.
Cela compte dès qu'un logiciel d'analyse lit la transcription. MAXQDA ne reconnaît que les formats de sa liste ; il convertit les horodatages en repères internes, les retire du texte et supprime tout repère qui renvoie à un moment antérieur au précédent. Il importe aussi les fichiers VTT de Zoom, Teams ou Webex. NVivo importe lui aussi des transcriptions horodatées et les relie au fichier audio ou vidéo. Ajoutez les heures aux repères de YouTube ou d'oTranscribe avant l'import : l'aide de MAXQDA ne dit pas s'il reconnaît 00:58.
Lire un code temporel SMPTE
Un code temporel comme 00:01:23:12 ressemble à un horodatage avec des centièmes, mais les deux derniers chiffres comptent des images. La norme de l'UER, l'Union européenne de radio-télévision, est faite pour la télévision européenne à 25 images par seconde, France, Belgique et Suisse comprises. Les images vont donc de 00 à 24, et :12 désigne la douzième image, soit 0,48 seconde. Pour convertir, divisez le numéro de l'image par 25 : 00:01:23:12 se situe 83,48 secondes après le début.
Trois particularités :
- Le Québec suit une autre cadence. Le Canada a adopté la norme de télévision NTSC des États-Unis, à 29,97 images par seconde ; les images y vont de 00 à 29.
- Le drop-frame. À 29,97 images par seconde, un code temporel compté normalement retarde d'environ 3,6 secondes par heure sur l'horloge. Le drop-frame saute donc les numéros d'image 00 et 01 au début de chaque minute, sauf toutes les dix minutes. Aucune image ne disparaît, seulement des numéros. On le reconnaît au point-virgule, comme dans
01:02:03;14. Pour notre instant, le code non drop-frame indique01:01:59:22, soit 3,75 secondes de retard. - Le code ne commence pas toujours à zéro. Une caméra peut démarrer à
10:00:00:00. Pour aligner une transcription sur une vidéo, il faut le code de départ et la cadence d'images.
Une erreur à éviter : lire 00:00:09:21 comme 9,21 secondes. À 25 images par seconde, c'est 9,84 secondes ; à 30 images par seconde, 9,7.
Transcrire à la main avec oTranscribe
oTranscribe est une application web gratuite et open source (licence MIT) de la MuckRock Foundation, disponible en français, qui fonctionne uniquement sur ordinateur :
- Ouvrez otranscribe.com, cliquez sur « Démarrer la transcription » et choisissez votre fichier audio ou vidéo.
- Échap lance ou met en pause la lecture, F1 et F2 reculent et avancent, F3 et F4 changent la vitesse.
- Ctrl+J (Cmd+J sur Mac) insère le minutage actuel. Chaque repère est cliquable.
- Exportez en Markdown, en texte brut ou au format .otr.
Nous l'avons testé dans Chrome le 15 octobre 2026, avec un fichier audio silencieux de 65 minutes créé par nos soins, en tapant notre extrait et en plaçant des repères à des moments précis :
- Notation : sous une heure,
00:58; au-delà,1:02:03. Les fractions sont coupées : 58,7 secondes deviennent00:58. - Navigation : un clic sur un repère a ramené la lecture au moment marqué.
- Export : dans les fichiers texte et Markdown, les repères deviennent du texte normal en début de ligne, sans lien vers l'audio.
- Confidentialité : sur les 40 requêtes réseau relevées, aucune n'a envoyé l'audio ; elles chargeaient la page, les polices et les scripts. Le texte est sauvegardé chaque seconde dans le navigateur : sur un ordinateur partagé, effacez-le.
C'est la méthode la plus lente, mais elle marche dans toutes les langues.
Word, Teams, Zoom et YouTube : l'horodatage automatique
Word, avec un abonnement Microsoft 365, transcrit un enregistrement via Accueil > Dicter > Transcrire. Dans le volet Transcrire, « Démarrer l'enregistrement » enregistre en direct et « Télécharger l'audio » envoie un fichier .wav, .mp4, .m4a ou .mp3, jusqu'à 300 minutes par mois. Word sépare les voix en « Intervenant 1 », « Intervenant 2 », et un clic sur l'horodatage d'une section rejoue ce passage. Avec « Ajouter tout au document », la transcription devient du texte normal avec un lien vers le fichier audio : les repères ne sont cliquables que dans le volet. L'aide de Microsoft propose Français (France) et Français (Canada), sans variante belge ou suisse. Sur ordinateur, la fonction est réservée à Word pour Microsoft 365 sous Windows dans les locataires commerciaux ; sur le web, au nouveau Microsoft Edge et à Chrome.
Teams affiche dans la transcription en direct le nom et l'horodatage de chaque intervenant. Pendant la réunion : Autres actions > Transcrire, confirmez la langue parlée, puis « Confirmer » ; un enregistrement lance aussi la transcription, et tous les participants en sont avertis. Ensuite, l'organisateur et les co-organisateurs la téléchargent en .docx ou en .vtt : Chat, conversation de la réunion, Récapitulatif, Transcription, puis la flèche à côté de Télécharger. Langues proposées : Français (France) et Français (Canada).
Zoom ne transcrit que les réunions enregistrées dans le cloud, avec un compte Pro, Business, Education ou Enterprise. La transcription arrive comme fichier VTT séparé, en sections horodatées. Zoom la génère en anglais par défaut : pour une réunion en français, changez la langue de l'enregistrement dans le portail web, et Zoom la refait.
YouTube affiche la transcription de toute vidéo sous-titrée : « Afficher la transcription » dans la description, puis un clic sur une ligne pour y aller. Les repères n'ont pas de zéros inutiles (0:58, 1:02:03), d'après notre relevé d'octobre 2026. Pour vos propres vidéos, la « Synchronisation automatique » de YouTube Studio prend un texte collé ou importé et définit elle-même les codes temporels. Le texte doit être dans la langue de la vidéo, YouTube ne la recommande pas au-delà d'une heure ou avec un son médiocre, et la piste est publiée automatiquement une fois prête.
Les fichiers VTT de Teams ou de Zoom s'ouvrent dans un éditeur de texte ; notre guide du fichier VTT montre comment en tirer un texte propre.
En local et automatiquement : Whisper, noScribe, aTrain
Si l'enregistrement ne doit pas quitter votre ordinateur, trois outils gratuits transcrivent sur votre machine :
- Whisper, le modèle de reconnaissance vocale open source d'OpenAI, écrit des fichiers SRT, VTT, TSV et JSON avec les temps, par exemple avec
whisper entretien.mp3 --language French --output_format srt. Attention au format TXT : il ne contient que le texte, sans un seul repère. Whisper ne distingue pas les locuteurs. - noScribe, conçu pour la recherche en sciences sociales, peut insérer des repères comme
[00:01:38]et produit un fichier HTML à ouvrir dans Word, du texte brut ou du WebVTT. - aTrain, développé à l'Université de Graz, transcrit hors ligne, reconnaît les locuteurs et produit des fichiers importables dans ATLAS.ti, MAXQDA et NVivo, avec des repères cliquables.
Nous avons mesuré la précision de Whisper sur des livres audio en anglais et en allemand, pas encore en français : voir notre guide pour transcrire un fichier audio en texte. Quel que soit l'outil, vérifiez les noms, les chiffres et les termes techniques en réécoutant avant de citer.
Les erreurs qui décalent les horodatages
- MP3 à débit variable : l'éditeur du logiciel f4 conseille un MP3 à débit constant, car un débit variable peut décaler les repères. MAXQDA note que des programmes calculent différemment la durée d'un MP3 et recommande alors le format AAC.
- Enregistrement coupé ou assemblé : si vous retirez le début ou collez deux fichiers, tous les repères suivants sont faux. Notez le décalage, ou retranscrivez la version définitive.
- Heures absentes :
58:12peut vouloir dire 58 minutes et 12 secondes, ou 58 secondes et 12 images. Écrivez00:58:12. - Repères devenus du texte : ce que Word ajoute au document et ce qu'oTranscribe exporte en texte ne se clique plus.
- Une seule version : gardez le premier export intact et travaillez sur une copie, pour pouvoir vérifier chaque repère.
Données personnelles : où part l'enregistrement ?
Ce n'est pas l'horodatage qui pose problème, mais l'enregistrement. Word, Teams et Zoom traitent l'audio dans le cloud. Pour Word, Microsoft précise que les fichiers audio lui sont envoyés pour fournir le service et que son service ne conserve ni l'audio ni le résultat après la transcription ; l'enregistrement reste toutefois dans le dossier Fichiers transcrits de votre OneDrive. Teams stocke les transcriptions dans le OneDrive Entreprise de l'organisateur. oTranscribe, Whisper, noScribe et aTrain fonctionnent sur votre ordinateur.
Une voix enregistrée est une donnée personnelle au sens du RGPD. Ce guide ne remplace pas un conseil juridique ; l'information des participants et la base légale sont traitées dans notre guide sur la retranscription d'un entretien.
