Das Canonical-Tag ist eine Zeile im Kopfbereich einer Webseite, zum Beispiel <link rel="canonical" href="https://polytested.com/de/blog">. Sie nennt Suchmaschinen die Hauptadresse einer Seite, wenn derselbe Inhalt unter mehreren Adressen erreichbar ist. Google behandelt das als Hinweis, nicht als Regel, folgt ihm aber meistens. Die meisten Content-Management-Systeme setzen das Tag automatisch. Wir zeigen, wie unsere Website auf 21 Adressvarianten antwortet und was TYPO3, Shopware 6, Shopify und WordPress mit Yoast auf echten deutschen Websites daraus machen, dazu eine Vorlage von Wix. Getestet haben wir am 16. Oktober 2026.
Das Wichtigste in Kürze
- Was es ist: ein
link-Element mitrel="canonical"im<head>einer Seite, das die bevorzugte, die kanonische URL nennt. „Kanonisch“ heißt laut Duden: als Richtschnur oder klassisches Muster dienend. - Wozu es dient: Ist eine Seite unter mehreren Adressen erreichbar, indexiert Google nur eine davon und bündelt dort Signale wie Links. Mit dem Tag sagst du, welche du bevorzugst.
- Ein Hinweis, keine Regel: In Googles Dokumentation steht, eine kanonische Präferenz sei „ein Hinweis und keine Regel“.
- Auf jeder Seite? Empfohlen, aber keine Pflicht. Seit Juli 2026 rät Google ausdrücklich zu einem Canonical, das auf die Seite selbst zeigt.
- Nicht dafür gedacht: Umgezogene Seiten bekommen eine Weiterleitung, Übersetzungen verbindest du mit hreflang, und Seite 2 einer Liste nennt sich selbst.
- Der Artikel: Ein Tag im Sinne der EDV ist laut Duden sächlich, also „das Canonical-Tag“.
Was Crawling und Indexierung bedeuten, erklärt unser Ratgeber SEO einfach erklärt.
So sieht das Canonical-Tag aus
Das Tag steht im <head> und nennt die vollständige Adresse samt https://. In unserem deutschen Ratgeber zu hreflang sieht es so aus:
<link rel="canonical" href="https://polytested.com/de/blog/hreflang-x-default-canonical-dach">
Googles Regeln dazu:
- Nur im Kopfbereich: Im
<body>ignoriert Google das Tag. Ein ungültiges Element wie<img>oder<iframe>im<head>wertet Google als dessen Ende und liest danach nichts mehr. Bei uns steht das Canonical direkt nach Seitentitel und Beschreibung; mehr zum Titel steht im Ratgeber SEO-Title. - Vollständige Adresse: Relative Pfade wie
/de/blogfunktionieren, Google rät aber davon ab. Sie können etwa Probleme machen, wenn eine Testumgebung versehentlich gecrawlt wird. - Ein Canonical pro Seite: Mehrere oder widersprüchliche Angaben führen laut Google zu unerwarteten Ergebnissen.
- HTTP-Header für Dateien: PDFs bekommen ihr Canonical per Header, etwa
Link: <https://www.beispiel.de/whitepaper.pdf>; rel="canonical". Google wertet ihn nur für die Websuche aus und rät, sich für Header oder HTML-Tag zu entscheiden, weil beides zusammen fehleranfälliger ist. Laut Web Almanac 2025 nutzen nur 0,6 Prozent der Desktopseiten den Header. - Gerade Anführungszeichen: Schreib im Code
", nicht „ “ oder ” ”. Warum, zeigt unser Test weiter unten.
Im Februar 2009 kündigten Google, Yahoo!, Microsoft (heute Bing) und Ask.com die Unterstützung an. Seit Dezember 2009 wertet Google das Tag auch zwischen verschiedenen Domains aus, und im April 2012 erschien es als RFC 6596, geschrieben von den beiden Autoren der Google-Ankündigung.
Warum eine Seite unter vielen Adressen erreichbar ist
Für Google ist jede abweichende Schreibweise eine eigene URL. Als Ursachen nennt Google unter anderem Regions-, Geräte- und Protokollvarianten, Sortier- und Filterfunktionen und versehentlich erreichbare Demoversionen einer Website. Typisch sind:
- Tracking-Parameter:
?utm_source=newsletter, die Klick-IDsfbclidvon Facebook undgclidvon Google Ads oder Kampagnenparameter wiemtm_campaignvon Matomo. - Sortierung und Filter:
?order=price-ascim Shop,?category=seoin unserem Blog. - Protokoll und Host:
http://oderhttps://, mit oder ohnewww. - Schreibweise: ein Schrägstrich am Ende oder Großbuchstaben. Laut Google sind
/APPLEund/applezwei verschiedene URLs. - Umlaute: In Links stehen sie prozentcodiert; in Googles Beispiel wird aus „gemüse“
gem%C3%BCse. Wir schreiben Umlaute in unseren Adressen als ae, oe und ue. - Technische Adressen: In unserem Test waren das
/detail/mit Produkt-ID in Shopware,?id=mit Seitennummer in TYPO3 und?p=mit Beitrags-ID in WordPress. Shopify zeigt Produkte auch unter dem Pfad einer Kollektion. - Kopien: Druckversionen, PDF-Fassungen, offene Testumgebungen und Artikel, die andere Websites übernehmen.
Unser Test: 21 Adressen rund um unsere deutschen Seiten
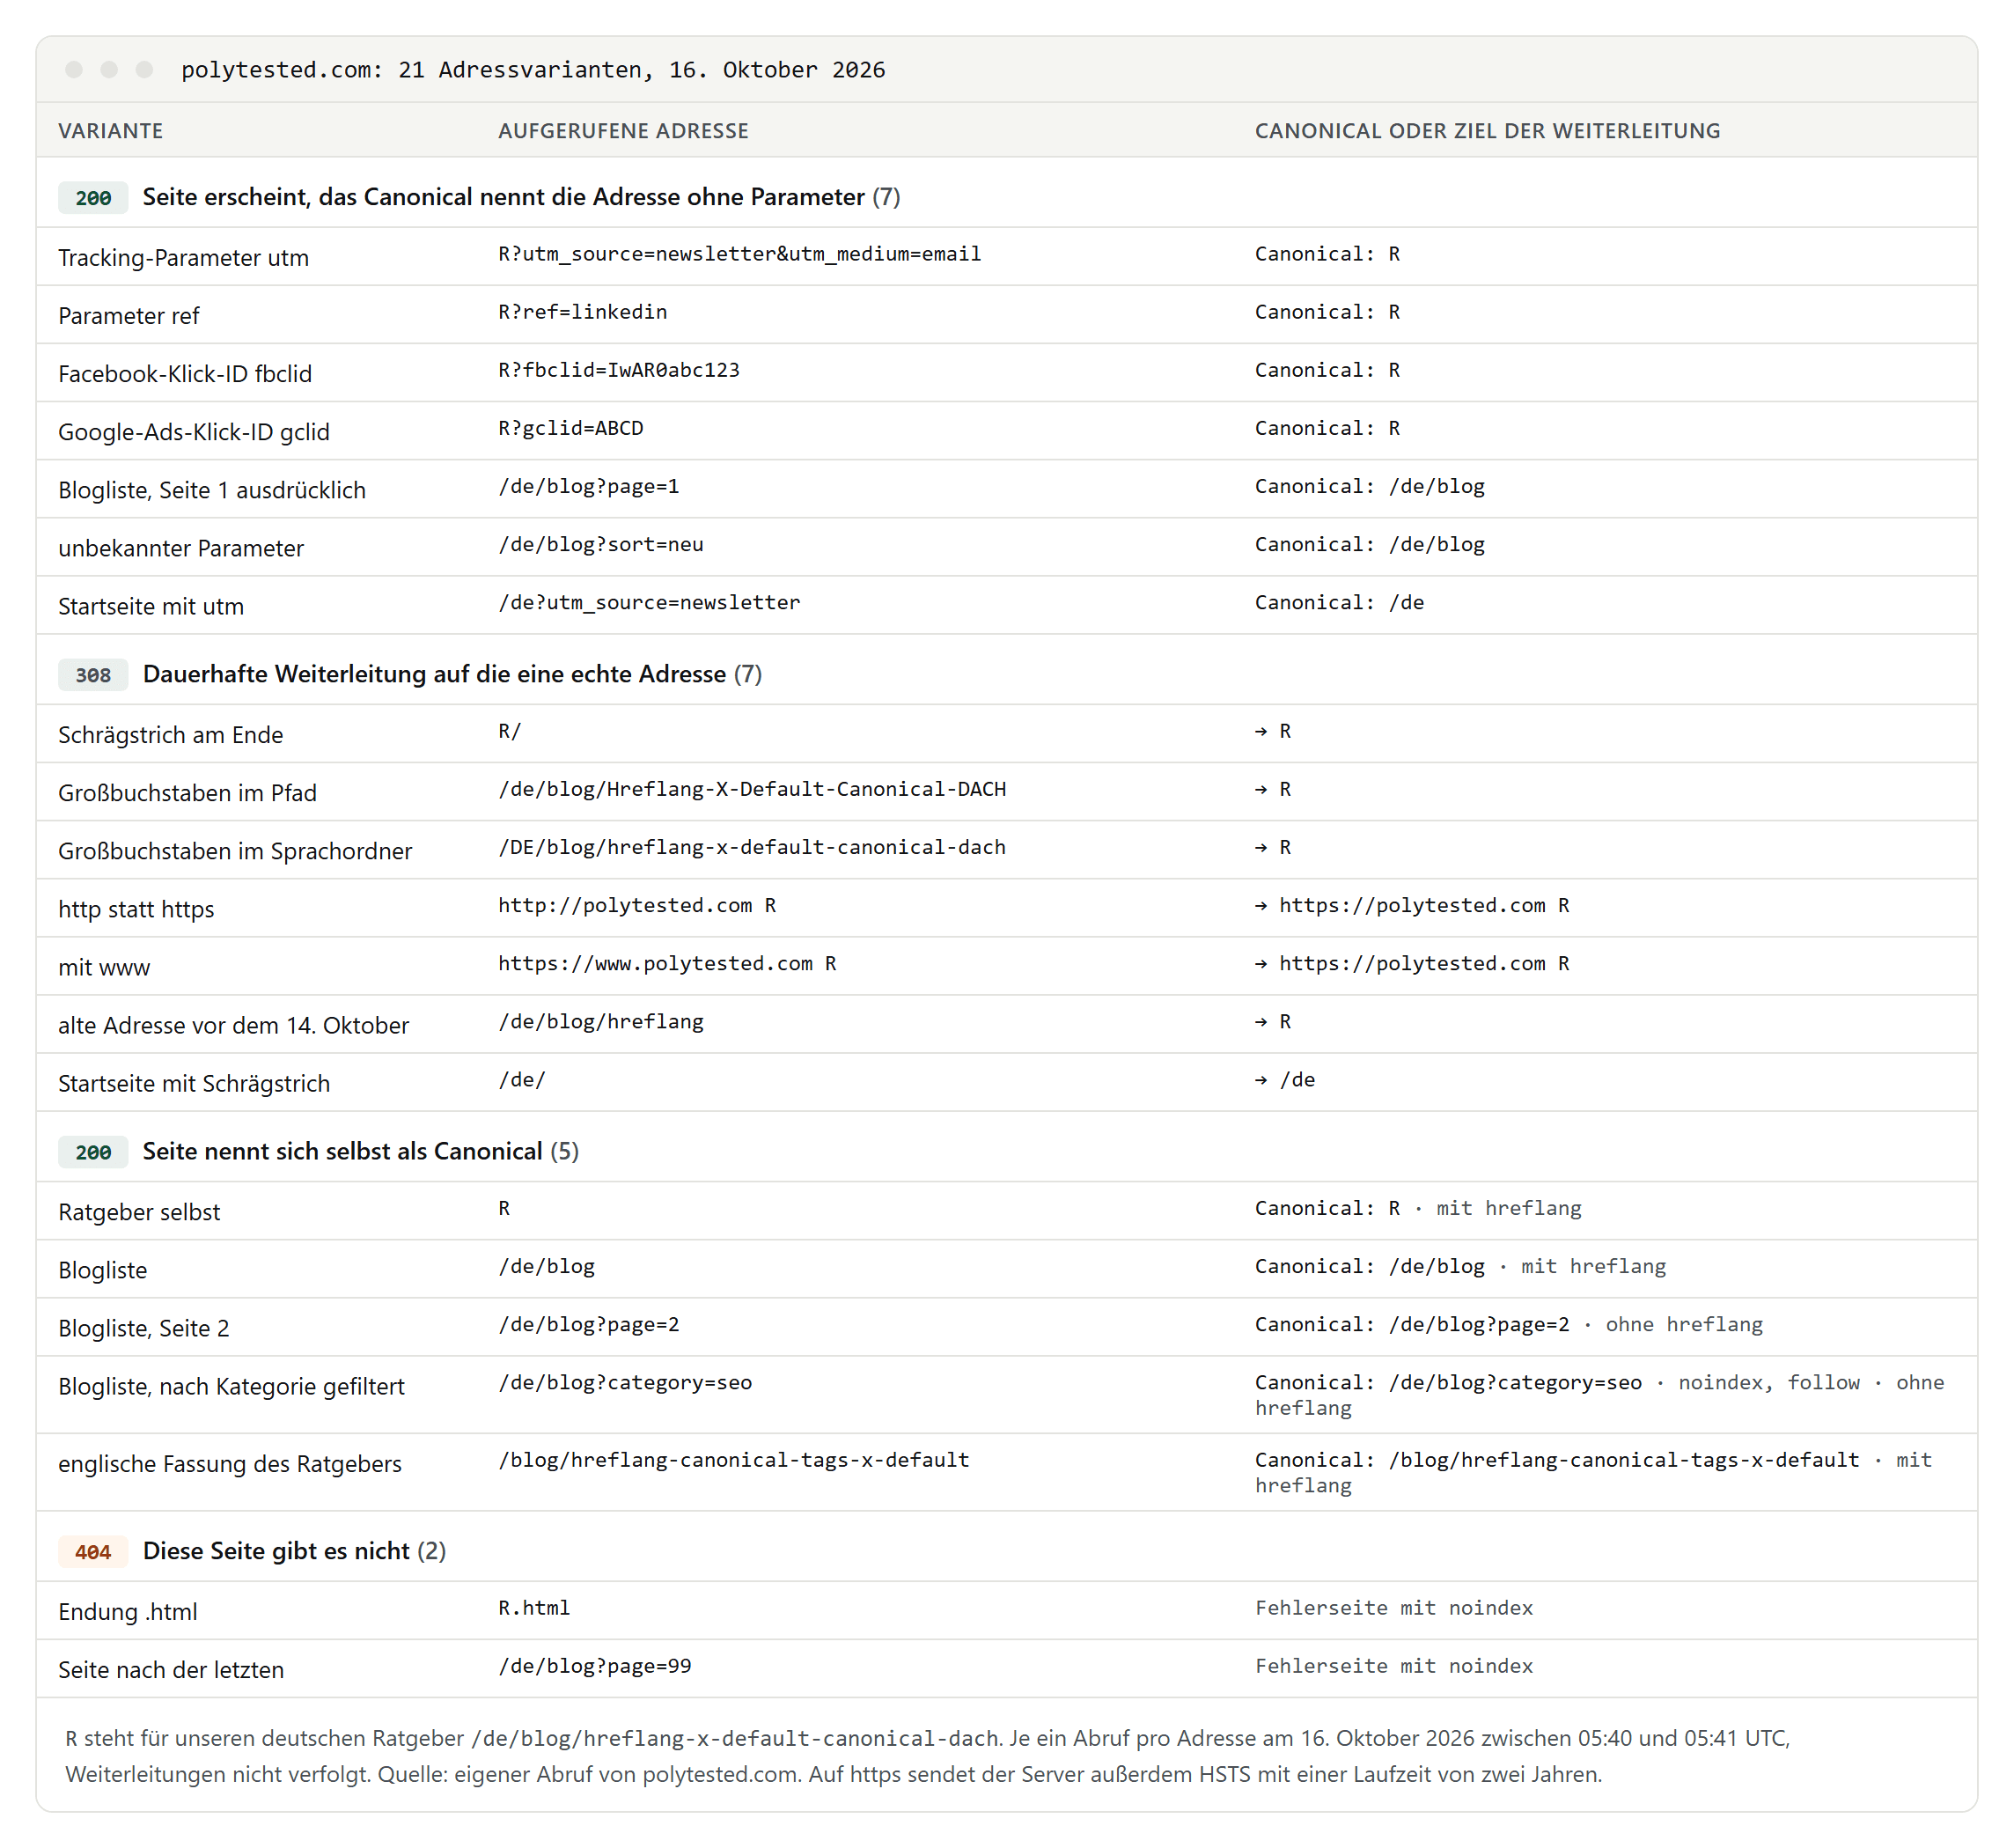
Am 16. Oktober 2026 haben wir 21 Varianten unserer Adressen je einmal aufgerufen, ohne Weiterleitungen zu folgen. Ausgangspunkte waren unser deutscher Ratgeber zu hreflang, die deutsche Blogliste und die deutsche Startseite. Das Ergebnis:
- Tracking-Parameter wie
utm_source,ref,fbclidodergclid: Die Seite erscheint mit Status 200, ihr Canonical nennt die Adresse ohne Parameter. Ein Newsletter-Link ändert also nichts an der Hauptversion. - Schreibvarianten zeigen gar keine Seite. Schrägstrich am Ende, Großbuchstaben (auch im Sprachordner
/DE/),http://undwwwleiten mit 308 dauerhaft auf die eine echte Adresse weiter, das Canonical muss hier nichts entscheiden. Zusätzlich sendet unser Server einen HSTS-Header, der Browsern sagt, die Website zwei Jahre lang nur verschlüsselt aufzurufen. - Die alte Adresse des Ratgebers, gültig bis zu unserer Umstellung am 14. Oktober, leitet ebenfalls mit 308 auf die neue weiter. Wie wir das gemacht haben, steht im Ratgeber zum Website-Relaunch.
- Seite 2 der Blogliste (
?page=2) nennt sich selbst, nicht Seite 1. Die Adresse mit?page=1verweist dagegen auf/de/blog, denn das ist dieselbe Seite. - Die gefilterte Liste (
?category=seo) nennt sich selbst und trägtnoindex, follow: Sie soll nicht in den Index, ihre Links dürfen Suchmaschinen aber verfolgen. - Ein unbekannter Parameter wie
?sort=neuzeigt die normale Liste mit Canonical auf/de/blog. - Nicht vorhandene Adressen wie die Endung
.htmloder?page=99antworten mit 404. - Die englische Fassung des Ratgebers nennt ebenfalls sich selbst; hreflang verbindet beide Fassungen.
Unsere deutsche Sitemap listete am selben Tag 43 Adressen, alle ohne Parameter. Nur kanonische URLs in die Sitemap, das verlangt auch Bing in seinen Richtlinien.
Fünf Systeme, dieselben Varianten
Am selben Morgen haben wir ähnliche Varianten an Websites mit fünf verbreiteten Systemen ausprobiert: zwei Universitätswebsites mit TYPO3, ein Onlineshop mit Shopware 6, zwei Onlineshops mit Shopify, der Blog einer Webdesign-Agentur mit WordPress und Yoast und eine deutsche Vorlage von Wix. Das System haben wir jeweils am Quelltext erkannt.
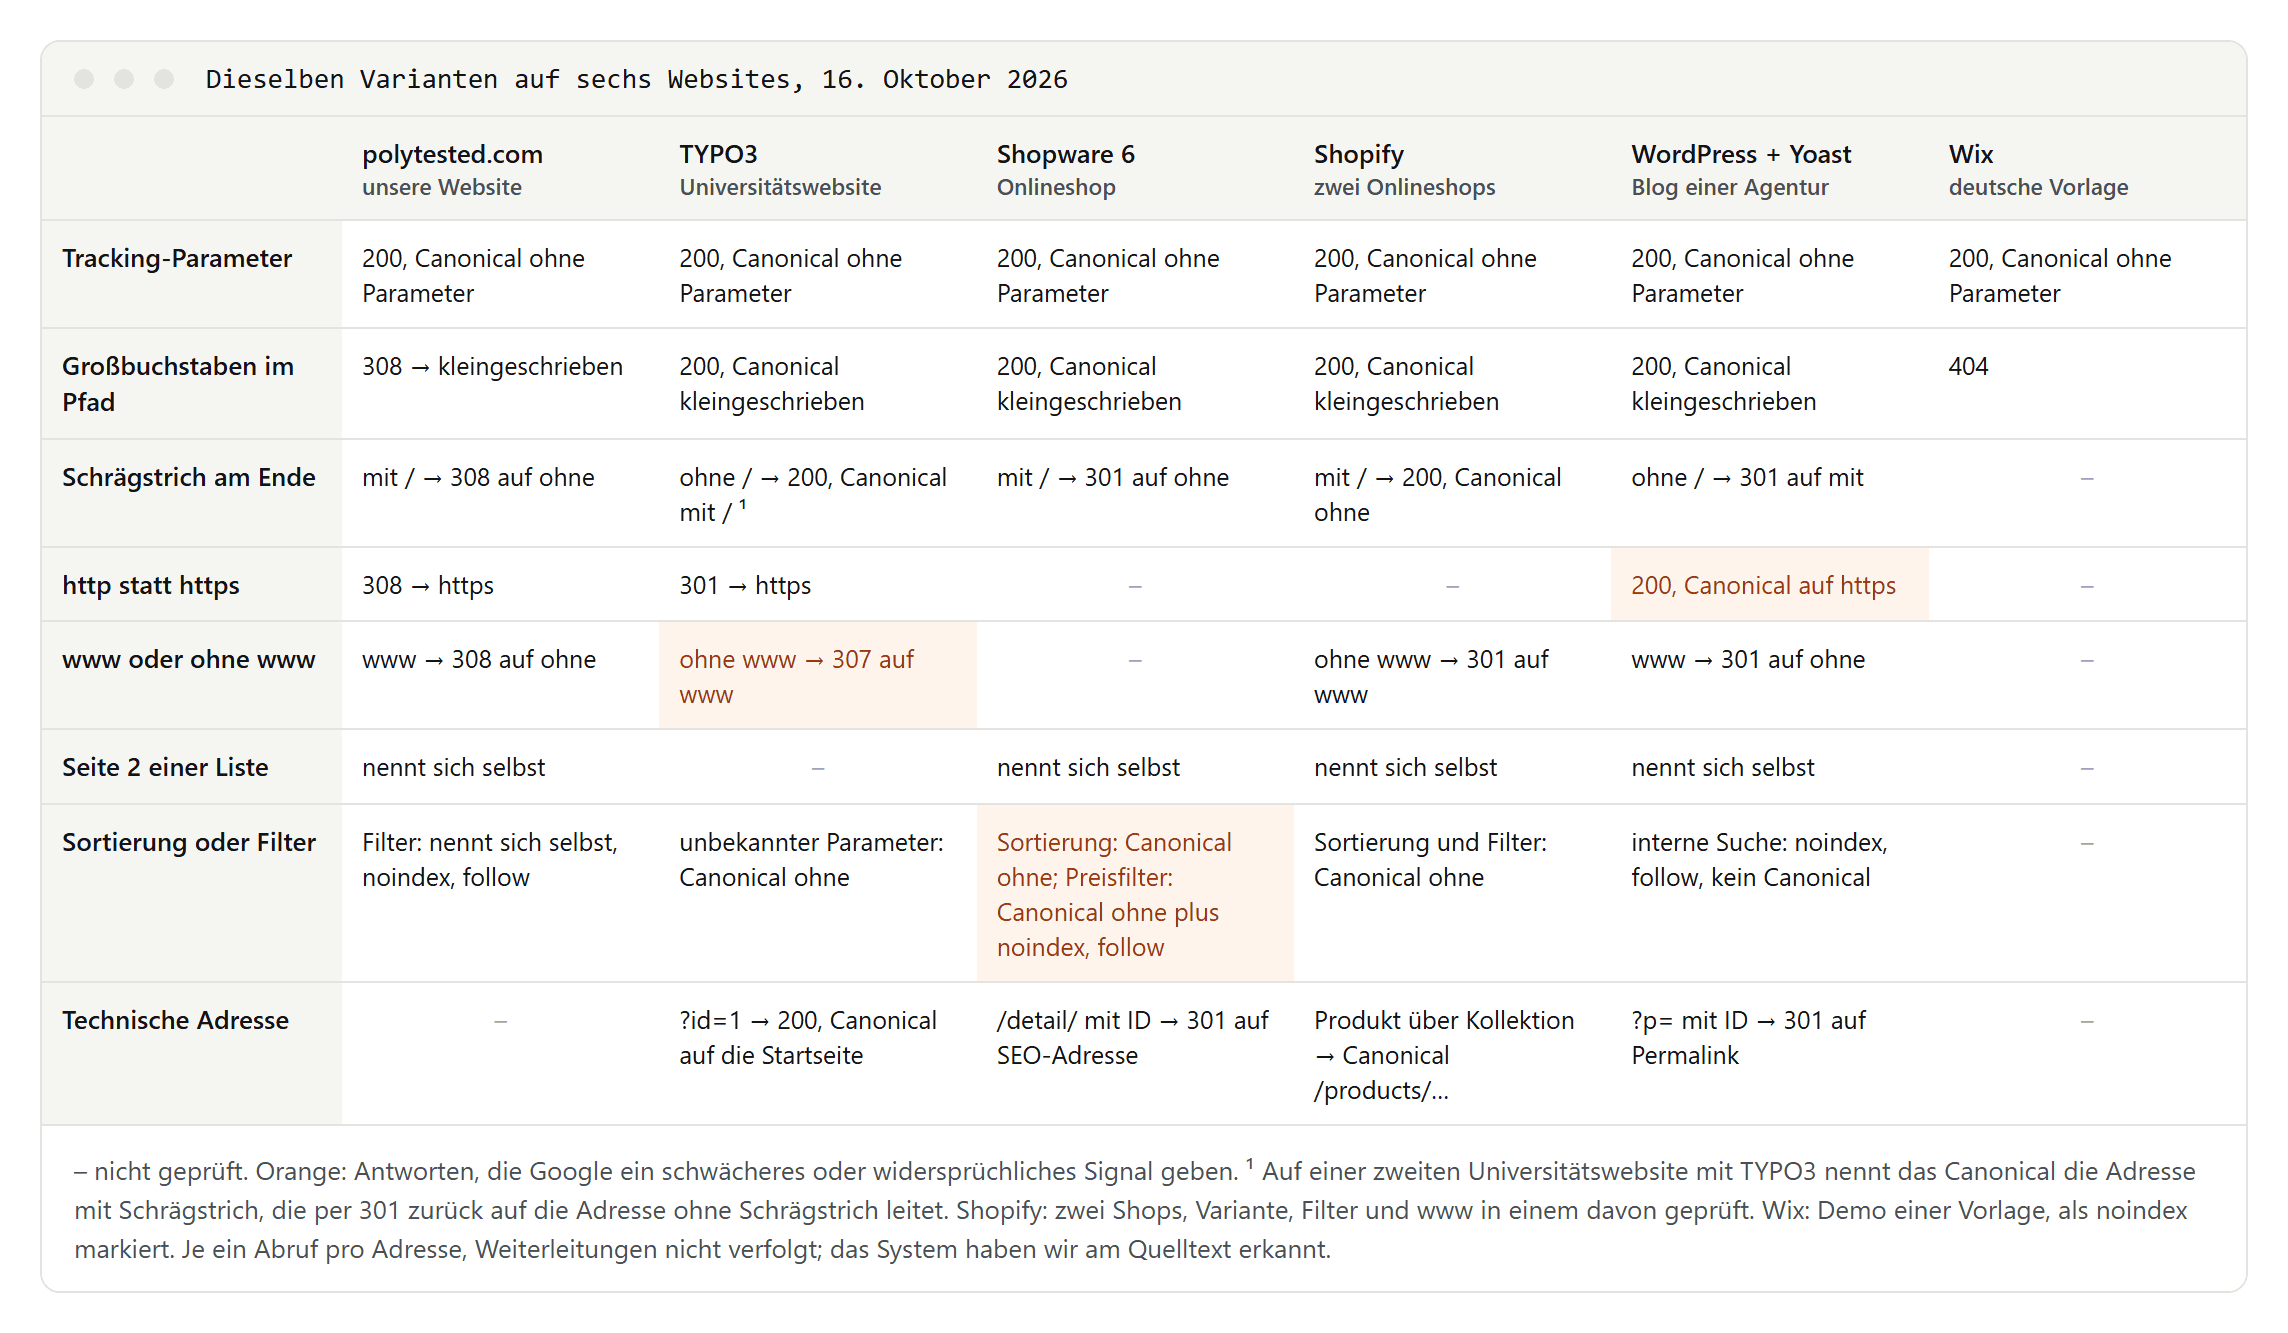
- Tracking-Parameter lösen alle Systeme gleich: Die Seite erscheint, das Canonical nennt die Adresse ohne Parameter.
- Großbuchstaben: TYPO3, Shopware, Shopify und WordPress zeigen die Seite auch mit Großbuchstaben an und nennen per Canonical die kleingeschriebene Adresse. Die Wix-Vorlage antwortet mit 404, wir leiten mit 308 weiter. Google rät, durchgehend eine Schreibweise zu verwenden, wenn dein Server beide gleich behandelt.
- Schrägstrich am Ende: Shopware leitet die Variante mit Schrägstrich auf die ohne um, WordPress umgekehrt, beide mit 301. TYPO3 und Shopify zeigen beide Varianten und regeln es über das Canonical. Laut Google ist das legitim, eine Weiterleitung aber besser. Welche Schreibweise du wählst, ist egal.
- http und www: Eine der Universitätswebsites leitet
http://mit 301 um, die Adresse ohnewwwaber mit 307. Vorübergehende Weiterleitungen nutzt Google nicht als Signal für die kanonische URL; eine 301 oder 308 wäre hier selbst ein starkes Signal. Der WordPress-Blog lieferte bei unserem Abruf unterhttp://die Seite mit Status 200 und einem Canonical auf die https-Adresse aus. Ob das für jeden Besucher gilt, etwa wegen eines vorgeschalteten Sicherheitsdienstes, wissen wir nicht. Google nennt die Weiterleitung auf HTTPS als Weg, die bevorzugte Version festzulegen. - Ein Widerspruch: Bei der zweiten Universitätswebsite nennt das Canonical der Adresse
/dedie Variante/de/, und die leitet per 301 zurück auf/de. Bei einer Unterseite war es genauso. RFC 6596 rät davon ab, auf eine Adresse zu verweisen, die dauerhaft weiterleitet. Welche Adresse Google dort gewählt hat, haben wir nicht geprüft.
Bei den Schreibvarianten gehen die Systeme also verschiedene Wege, und dort lagen die meisten Widersprüche, die wir gefunden haben. Prüf an deiner eigenen Website deshalb mindestens Schrägstrich, Großbuchstaben, www und http.
Wie Google die kanonische URL auswählt
Google fasst Seiten mit gleichem oder sehr ähnlichem Hauptinhalt zu einem Cluster zusammen und wählt daraus die vollständigste und nützlichste als kanonische Seite. Diese crawlt Google am häufigsten, bewertet an ihr Inhalt und Qualität und zeigt sie meist in den Suchergebnissen. Passt ein Duplikat deutlich besser, etwa die mobile Seite auf dem Smartphone, kann Google aber dieses zeigen.
Die Signale nach ihrer Stärke, laut Google:
- Weiterleitungen: ein starkes Signal, aber nur dauerhafte wie 301 und 308. Vorübergehende wie 302, 303 und 307 nutzt Google nicht als Signal für die kanonische URL.
rel="canonical", als Tag oder HTTP-Header: ebenfalls ein starkes Signal.- Die Aufnahme in die Sitemap: ein schwaches Signal.
Zeigen mehrere Signale in dieselbe Richtung, verstärken sie sich. Außerdem bevorzugt Google HTTPS-Seiten und Adressen in einem hreflang-Cluster und achtet darauf, wohin deine internen Links zeigen. Das Zusammenspiel mit hreflang erklärt unser Ratgeber zu hreflang, x-default und Canonical. Für Länderfassungen in derselben Sprache empfiehlt Google Canonical und hreflang zusammen; wie du solche Fassungen aufbaust, steht im Ratgeber Internationales SEO.
Nach einer Korrektur kann es laut Google bis zu zwei Wochen dauern, bis Google Seiten aus einem Cluster löst.
Eine Strafe für doppelte Inhalte gibt es nicht. Laut Google ist eine gewisse Menge Duplicate Content normal und kein Verstoß gegen die Spamrichtlinien, und Bing sagt dasselbe. Das Risiko ist ein anderes: Google zeigt womöglich die falsche Adresse, und Signale wie Links verteilen sich auf mehrere URLs. Trotzdem ist in mehreren deutschen Ratgebern von einer Abstrafung die Rede, sogar in der Entwicklerdokumentation zweier großer CMS. Spam ist dagegen, fremde Texte ohne eigenen Mehrwert zu kopieren; mehr dazu im Ratgeber White-Hat-SEO.
Braucht jede Seite ein Canonical auf sich selbst?
Empfohlen ja, Pflicht nein. Laut Google ist keine der Methoden erforderlich; ohne Angabe wählt Google selbst die Version, die es für die beste hält. Seit Juli 2026 steht in Googles Anleitung aber ausdrücklich, auch der kanonischen Seite selbst ein Canonical zu geben, ein sogenanntes selbstreferenzierendes Canonical. In der Fassung vom März 2026 fehlte dieser Punkt noch, wie zwei archivierte Versionen im Internet Archive zeigen. Googles Leitfaden zur URL-Struktur von Onlineshops, Stand Dezember 2025, empfiehlt es für alle indexierbaren Seiten. Der Nutzen: Ruft jemand die Seite mit ?utm_source=… auf, liefert sie dasselbe Canonical aus wie die saubere Adresse.
Meist setzt das System das Tag: WordPress auf Beiträgen und Seiten, Yoast, Wix, Shopify und TYPO3 mit seiner SEO-Erweiterung automatisch. Laut Web Almanac 2025 des HTTP Archive tragen 68 Prozent der Desktop- und 67 Prozent der Mobilseiten ein Canonical, ein Jahr zuvor waren es je 65 Prozent. Halte auch og:url gleich: Das Open-Graph-Protokoll für Vorschauen in sozialen Netzwerken versteht es als kanonische Adresse. Bei unseren Ratgebern stimmen beide überein.
Canonical, Weiterleitung oder noindex?
Welches Werkzeug passt, hängt davon ab, was mit der zweiten Adresse passieren soll:
- Die alte Adresse soll verschwinden, etwa nach einem Umzug oder einem neuen Slug: dauerhafte Weiterleitung mit 301 oder 308. Bing bittet bei umgezogenen Inhalten ausdrücklich um Weiterleitungen statt Canonical-Tags.
- Beide Adressen müssen funktionieren, etwa bei Tracking-Parametern, Sortierungen oder Druckansichten: Canonical auf die Hauptadresse.
- Die Seite soll gar nicht in den Index, etwa die interne Suche oder gefilterte Listen:
noindex. - Derselbe Inhalt in einer anderen Sprache: hreflang, und jede Fassung nennt sich selbst.
- Seite 2, 3 und so weiter: Jede Seite nennt sich selbst.
Zwei Werkzeuge taugen laut Google nicht zum Kanonisieren: die robots.txt, weil gesperrte Adressen trotzdem im Index landen können, nur ohne Inhalt, und das Tool zum Entfernen von URLs, weil es alle Versionen einer Adresse ausblendet.
Und noindex zusammen mit einem Canonical? Google rät davon ab, die Wahl der kanonischen Seite mit noindex zu steuern, weil die Seite dann ganz aus der Suche verschwindet. Yoast und TYPO3 geben auf Seiten mit noindex gar kein Canonical aus, so steht es in der Hilfe von Yoast und im Quellcode von TYPO3. Der Shopware-Shop aus unserem Test kombiniert dagegen auf gefilterten Kategorieseiten noindex, follow mit einem Canonical auf die ungefilterte Kategorie. Das sind zwei Signale mit verschiedener Absicht; klarer ist es, sich für eins zu entscheiden. Unsere gefilterte Blogliste trägt ebenfalls noindex, follow, ihr Canonical zeigt aber auf sie selbst.
Paginierung: Seite 2 nennt sich selbst
Für Listen über mehrere Seiten ist Googles Anleitung eindeutig: Jede Seite bekommt eine eigene URL, etwa mit ?page=2, und ein eigenes Canonical. Die erste Seite soll nicht das Canonical der Folgeseiten sein. Den Grund nennt schon RFC 6596: Seite 2 ist keine Kopie von Seite 1. Verweist sie trotzdem dorthin, wertet eine Suchmaschine womöglich nur Seite 1 aus, und was nur auf den Folgeseiten steht, kann verloren gehen. Erlaubt ist laut RFC dagegen ein Canonical auf eine Seite „Alle anzeigen“ mit dem kompletten Inhalt.
Die Auszeichnung mit rel="next" und rel="prev" nutzt Google nicht mehr. Ob die erste Seite ?page=1 heißt oder nicht, sollte überall gleich sein, in Links, Sitemap und Canonical; bei uns heißt sie überall /de/blog. Für nicht vorhandene Seitenzahlen wie unser ?page=99 empfiehlt Google einen 404.
Alle Websites, bei denen wir Seite 2 aufgerufen haben, nennen dort sich selbst: unsere Blogliste, der Shopware-Shop (?p=2), die Shopify-Shops (?page=2) und der WordPress-Blog (/page/2/). Trotzdem raten mehrere deutsche Ratgeber noch, Folgeseiten auf Seite 1 zu lenken oder ihnen gar kein Canonical zu geben. Beides widerspricht Googles aktueller Anleitung.
Filter, Sortierung und Varianten im Onlineshop
Filter nach Farbe, Größe oder Preis können laut Google fast unendlich viele Adressen erzeugen. Sollen gefilterte Seiten nicht in den Index, rät Google, ihr Crawling zu verhindern, etwa per robots.txt. Hier geht es also ums Crawlen, nicht um die Wahl einer Hauptversion. Canonical und nofollow sind laut Google langfristig meist weniger wirksam; ein Canonical auf die ungefilterte Seite kann aber mit der Zeit dafür sorgen, dass Google die Filterseiten seltener crawlt. Filterkombinationen ohne Treffer sollen mit 404 antworten.
Für Produktvarianten gilt laut Googles Leitfaden zur URL-Struktur: Kennzeichnest du Varianten mit Parametern, ist die Adresse ohne Parameter die kanonische. Hat jede Variante eine eigene URL, nennen alle Variantenseiten die kanonische Produktadresse.
So machen es die Shops in unserem Test:
- Shopify: In beiden Shops nannte das Canonical die Produktadresse
/products/<produkt>, auch wenn wir das Produkt über eine Kollektion aufriefen (/collections/<kollektion>/products/<produkt>). Sortierte Kollektionen nannten die Kollektion ohne Parameter. In einem der Shops galt das auch für eine Produktvariante (?variant=…) und einen Filter. Shopifys Hilfe sagt nur, dass kanonische Tags automatisch ergänzt werden. - Shopware 6: Sortierte Kategorieseiten nannten die Kategorie, eine nach Preis gefilterte zusätzlich mit
noindex, follow. Technische Adressen mit der internen ID eines Produkts oder einer Kategorie leiteten per 301 auf die sprechende SEO-Adresse. Ob das Voreinstellungen von Shopware sind oder Einstellungen dieses Shops, haben wir nicht geprüft.
Solche Varianten erscheinen im Bericht zur Seitenindexierung der Search Console als „Duplikat“ oder „alternativ“. Laut Hilfe ist das meist ein gutes Zeichen: Google hat die kanonische Version gefunden.
PDFs, andere Domains und übernommene Artikel
- Dateien: Gibt es ein Dokument als PDF und als Word-Datei, kann die Word-Datei per HTTP-Header auf das PDF als Canonical verweisen. So lautet Googles eigenes Beispiel.
- Druckversionen zählt Bing zu den technischen Duplikaten. Bleiben sie erreichbar, bekommen sie ein Canonical auf die normale Seite.
- Andere Domain oder Subdomain: Seit Dezember 2009 wertet Google Canonicals auch domainübergreifend aus. In unserem Test verweist eine der Universitätswebsites von einer Campus-Seite per Canonical auf eine Seite ihrer Bibliothek, die auf einer eigenen Subdomain liegt. Das ist erlaubt, wenn der Inhalt derselbe ist.
- Übernommene Artikel: Veröffentlicht ein Partner deine Artikel, rät Google seit Mai 2023 nicht mehr zum Canonical, weil sich die Seiten oft stark unterscheiden. Am wirksamsten ist laut Google, dass der Partner seine Kopie aus dem Index hält; die Hilfe für Google News nennt dafür
<meta name="Googlebot" content="noindex">. Bing rät dagegen, Partner um ein Canonical auf dein Original zu bitten, wenn eure Vereinbarung das zulässt. Mehrere deutsche Ratgeber empfehlen für übernommene Artikel noch pauschal das Canonical; für Google ist das überholt. - Ein Übersetzungsfehler: Die deutsche Fassung von Googles Seite zur Fehlerbehebung spricht dabei von Werbetreibenden. Im englischen Original geht es um alle, die Duplikate durch Syndizierungspartner vermeiden wollen.
- Kopien und Angriffe: Wählt Google die Adresse einer fremden Website, die deine Inhalte ohne Zustimmung kopiert hat, kannst du beim Hoster die Entfernung verlangen und bei Google einen Antrag nach dem US-Urheberrechtsgesetz DMCA stellen (keine Rechtsberatung). Bei manchen Hackerangriffen wird ein Canonical auf eine Spam-Seite eingeschleust. Taucht in deinem Quelltext plötzlich eins auf eine fremde Domain auf, prüf die Website auf einen Angriff.
WordPress, Shopify, Wix und Jimdo: wo das Canonical herkommt
- WordPress gibt seit Version 2.9 selbst ein Canonical aus, aber nur auf Einzelseiten wie Beiträgen, Seiten und Anhängen. Kategorie- und Schlagwortseiten bekommen von WordPress selbst keins; das ergänzt zum Beispiel ein SEO-Plugin wie Yoast. Getrennt davon leitet WordPress Adressvarianten weiter, etwa einen fehlenden Schrägstrich oder
?p=mit der Beitrags-ID; im getesteten Blog geschah das jeweils mit 301. - Yoast SEO ergänzt Canonicals automatisch. Ändern kannst du sie pro Beitrag, Seite, Kategorie oder Schlagwort in der Yoast-Seitenleiste unter „Erweitert“ im Feld „Canonical-URL“, immer mit vollständiger Adresse. Auf Seiten mit noindex gibt Yoast kein Canonical aus; im getesteten Blog trug die interne Suche
noindex, followund kein Canonical. - Rank Math: Hier heißt das Feld „Kanonische URL“, in der SEO-Meta-Box unter der Registerkarte „Erweitert“. Bleibt es leer, nimmt Rank Math die Adresse des Beitrags.
- Shopify ergänzt kanonische Tags automatisch. Für Themes stellt Shopify die Adresse im Liquid-Objekt
canonical_urlbereit. - Wix setzt auf jeder Seite automatisch ein Canonical auf sich selbst und rät, es nicht zu ändern. Wenn doch: im Editor unter „Seiten & Menü“ neben der Seite auf „Weitere Aktionen“, dann „SEO-Basics“, Tab „Erweiterte SEO“ und „Zusätzliche Tags“. Neben „kanonisch“ wählst du wieder „Weitere Aktionen“ und „Bearbeiten“, trägst den Wert unter „TAG-WERT“ ein und klickst auf „Übernehmen“. Laut Wix kann eine Seite aus der Sitemap verschwinden, wenn du ihr Standard-Canonical änderst.
- Jimdo: In beiden Hilfe-Centern von Jimdo, für den Creator und für den neueren Baukasten, ergab die Suche nach „canonical“ am 16. Oktober 2026 keinen Treffer. Prüf das Tag deshalb im Quelltext deiner Seite, wie weiter unten beschrieben.
Shopware und TYPO3: die Einstellungen im Detail
Shopware 6. Die sprechenden Adressen entstehen aus Vorlagen, die du in den SEO-Einstellungen pro Verkaufskanal festlegst; mit dem Twig-Filter lower werden sie durchgehend kleingeschrieben. Das Canonical eines Produkts stellst du aber im Produkt selbst ein, im Tab „SEO“:
- „Verwende dieselbe Canonical-URL für alle Varianten“ erscheint nur bei Produkten mit Varianten. Aktivierst du die Option, wählst du unter „Variante für Canonical-URL“, welche Variante die Adresse liefert. Wird genau diese Variante später deaktiviert, prüf das Canonical der übrigen.
- „SEO-URLs“: Hier legst du pro Verkaufskanal den SEO-Pfad fest und bei Produkten in mehreren Kategorien die „Hauptkategorie“.
- „Statt Canonical URLs direkt per HTTP 301 auf die aktuellste URL leiten“ steht in den SEO-Einstellungen unter „Verhalten der Weiterleitung“. Ändert sich eine SEO-Adresse, leitet Shopware die alte dann per 301 auf die neue weiter.
TYPO3. Seit Version 9.5 setzt TYPO3 das Canonical selbst, wenn die Systemerweiterung „seo“ installiert ist.
- Pro Sprache: In den Seiteneigenschaften lässt sich das Canonical im Reiter „SEO“ für jede Sprache überschreiben, mit dem Link-Assistenten auch auf externe Ziele. In der englischen Oberfläche heißt das Feld „Canonical link“, in deutschen Redaktionsanleitungen „Kanonischer Link“. Ohne Eintrag verweist TYPO3 auf die aktuelle Seite.
- Parameter: Im Canonical bleiben nur Parameter, die nach der cHash-Logik von TYPO3 den Inhalt bestimmen; weitere ergänzt du mit
additionalCanonicalizedUrlParameters. Das passt zu unserem Test, in dem?utm_source=und ein ausgedachter Parameter wegfielen. - Kein Canonical gibt TYPO3 aus, wenn die Seite auf noindex steht (Feld
no_index) oder TypoScript es mitdisableCanonicalabschaltet. - Doppelte Canonicals: Setzt zusätzlich eine SEO-Erweiterung eins, stehen zwei im Code. Laut dem Änderungsprotokoll von TYPO3 darf nur eine von beiden das Tag erzeugen.
Typische Fehler, die Google das Canonical ignorieren lassen
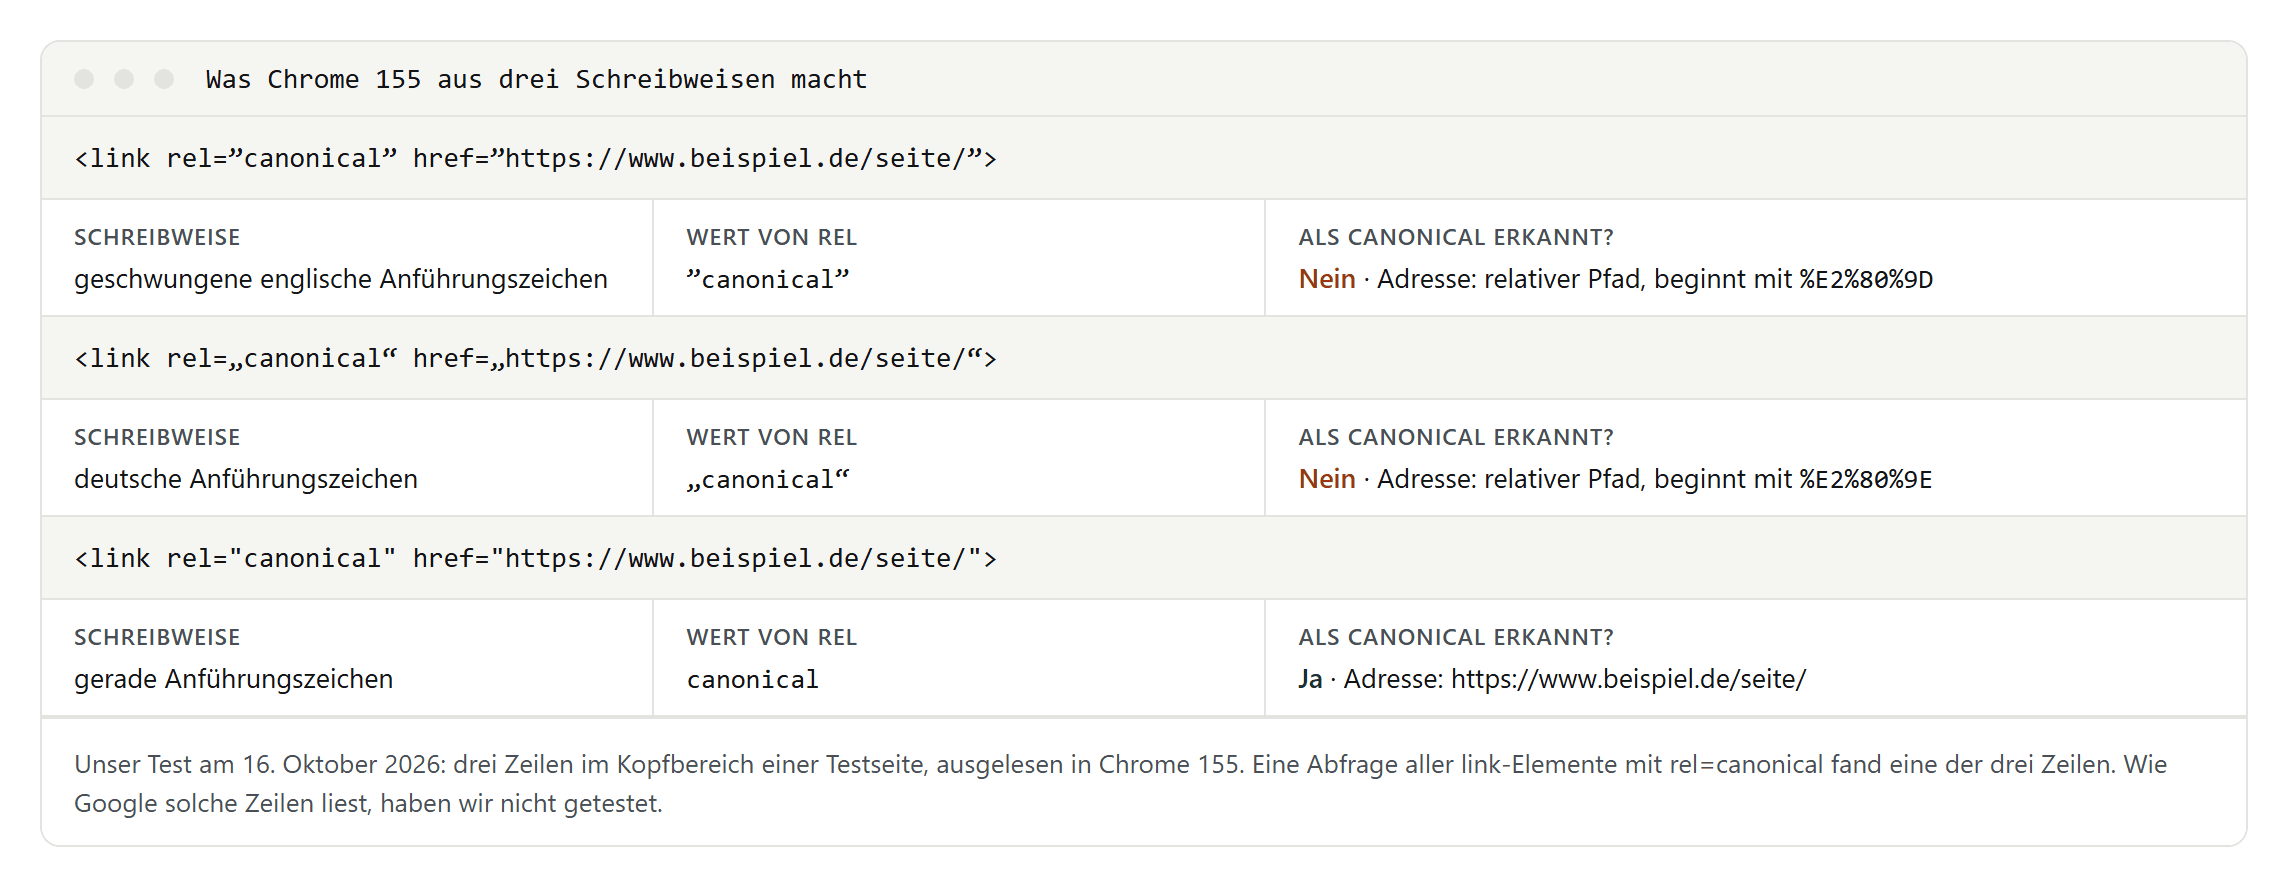
- Typografische Anführungszeichen: Mehrere deutsche Ratgeber zeigen Code-Beispiele mit geschwungenen Anführungszeichen, wie sie Textprogramme automatisch setzen. In unserem Test in Chrome wurden diese Zeichen Teil des Werts:
relwar nicht mehrcanonical, und die Adresse wurde zu einem relativen Pfad. Nur die Zeile mit geraden Anführungszeichen erkannte Chrome als Canonical. Ob Google solche Zeilen anders liest, haben wir nicht getestet; verlass dich nicht darauf. - Mehrere Canonicals auf einer Seite, etwa wenn das CMS und eine Erweiterung beide eins ausgeben.
- Canonical außerhalb des Kopfbereichs oder hinter einem ungültigen Element wie
<img>im<head>. - Unvollständige Adresse:
beispiel.de/seiteohnehttps://ist ein relativer Pfad auf deiner eigenen Website. Google nennt diesen Fehler in einem Beitrag über fünf häufige Fehler mit rel=canonical. - Ein Ziel, das weiterleitet, einen Fehler liefert oder ein anderes Canonical nennt: Davon rät RFC 6596 ab. Verweise auf die endgültige, erreichbare Adresse.
- Eine Kategorieseite verweist auf einen einzelnen Artikel: Dann verschwindet die Kategorieseite aus den Ergebnissen. Auch das steht in Googles Liste häufiger Fehler.
- Zusatzattribute: Ein
rel="canonical"mithreflang,lang,mediaodertypenutzt Google nicht für die Kanonisierung. - Eine Übersetzung verweist auf die englische Seite: Jede Sprachfassung nennt sich selbst. Ein deutscher Ratgeber behauptet sogar, Canonical und hreflang widersprächen sich; Google bittet bei hreflang aber ausdrücklich um ein Canonical in derselben Sprache. Mehr dazu im Ratgeber SEO-Übersetzung.
- JavaScript ändert das Canonical: Google möchte es unverändert im HTML-Quelltext sehen. Laut Web Almanac 2025 ändert sich das Canonical beim Rendern auf 2,7 Prozent der Desktop- und 3,0 Prozent der Mobilseiten.
- Interne Links widersprechen dem Canonical: Google bittet, intern auf die kanonische Adresse zu verlinken. Eine der getesteten Universitätswebsites verlinkt von ihrer Startseite auf eine Adresse mit Kampagnenparametern von Matomo, die erst per 301 weiterleitet.
So prüfst du, welche URL Google gewählt hat
- Quelltext: Öffne die Seite mit
view-source:vor der Adresse oder mit Strg+U und such nach „canonical“. Es sollte genau ein Treffer im<head>sein. Die Entwicklertools (F12) zeigen den Stand nach JavaScript; diesen Weg empfiehlt Google auch, wenn ein CMS falsche Canonicals ausgibt. - Weiterleitungen: Mit
curl -Iund der Adresse siehst du Statuscode und Ziel einer Weiterleitung, ohne ihr zu folgen. So findest du 302 und 307, wo 301 oder 308 hingehört. - URL-Prüftool der Search Console: Gib die vollständige Adresse oben in die Suchleiste ein. Unter „Seitenindexierung“ stehen zwei Felder: „Vom Nutzer angegebene kanonische URL“ ist die Adresse, die deine Seite nennt, „Von Google ausgewählte kanonische URL“ die, die Google gewählt hat. Der Live-Test („Live-URL testen“) kann laut Google nicht vorhersagen, ob eine Version kanonisch wird; das zeigt nur das Ergebnis aus dem Index.
- Bericht zur Seitenindexierung: Drei Meldungen betreffen das Canonical.
- „Alternative Seite mit richtigem kanonischen Tag“: Die Seite verweist korrekt auf eine indexierte Hauptseite, du musst nichts tun. Alternative Sprachversionen erkennt die Search Console laut Hilfe nicht.
- „Duplikat – vom Nutzer nicht als kanonisch festgelegt“: Die Seite hat kein Canonical, und Google hat eine andere Seite als Hauptversion gewählt. Das ist kein Fehler. Ist Googles Wahl falsch, gib ein Canonical an oder sorg dafür, dass sich die Seiten deutlich unterscheiden.
- „Duplikat – Google hat eine andere Seite als der Nutzer als kanonische Seite bestimmt“: Google folgt deinem Canonical nicht. Vergleiche die beiden Felder im URL-Prüftool. Ein Canonical auf eine Seite, die der geprüften nicht ähnelt, wählt Google laut Hilfe nie.
- Kleine Websites: Bei weniger als etwa 500 Seiten brauchst du den Bericht laut Google wahrscheinlich gar nicht.
- Keine Einstellung: Eine kanonische URL legst du in der Search Console nicht fest. Die Einstellung „Bevorzugte Domain“ hat Google im Juni 2019 abgeschafft, das URL-Parameter-Tool im Frühjahr 2022. Anleitungen, die noch etwas anderes empfehlen, etwa der Ratgeber eines SEO-Plugin-Herstellers oder die TYPO3-Redaktionshilfe einer Hochschule, sind veraltet.
- Nach einer Korrektur: „Indexierung beantragen“ hat Kontingente, nutze es nur für wichtige Adressen. Bei Bing hilft IndexNow, Änderungen schneller zu melden.
Checkliste
- Jede indexierbare Seite nennt sich selbst als Canonical, mit vollständiger Adresse samt
https://. - Genau ein Canonical pro Seite, im
<head>, vor jedem ungültigen Element und mit geraden Anführungszeichen. http,www, Schrägstrich und Großbuchstaben leiten mit 301 oder 308 auf eine Schreibweise um, nicht mit 302 oder 307.- Tracking-Parameter und Sortierungen verweisen per Canonical auf die Adresse ohne Parameter.
- Seite 2 und alle folgenden nennen sich selbst.
- Übersetzungen nennen sich selbst und sind per hreflang verbunden.
- Interne Links, Sitemap und Canonical nennen dieselbe Adresse.
- Kein Canonical auf Adressen, die weiterleiten, 404 liefern oder noindex tragen.
- Im CMS gibt nur eine Quelle das Canonical aus.
- Im URL-Prüftool verglichen, welche Adresse Google gewählt hat.
