La síntesis de voz, también llamada texto a voz o text to speech (TTS), es la tecnología que convierte un texto escrito en habla: un programa lee el texto con una voz artificial. Es lo que hace hablar al GPS, a los lectores de pantalla, a la lectura en voz alta del navegador y a muchos vídeos. Tu ordenador y tu móvil ya la traen de serie. Aquí verás para qué sirve, cómo funciona, qué voces en español encontramos en nuestro propio PC y por qué las fechas, las cifras y las tildes le complican la vida.
¿Qué es la síntesis de voz (text to speech)?
Síntesis de voz, texto a voz, text to speech y TTS son nombres para lo mismo: convertir texto escrito en voz. Microsoft explica en su documentación en español que la función de texto a voz «también se conoce como síntesis de voz», y Google llama a la página de ajustes de Android «Salida de conversión de texto a voz». El proceso contrario, pasar de voz a texto, es el reconocimiento de voz (speech to text); lo explicamos en nuestra guía para transcribir audio.
Hay tres cosas que se confunden a menudo con la síntesis de voz:
- El lector de pantalla: una aplicación como el Narrador de Windows, VoiceOver de Apple o TalkBack en Android, que lee todo lo que aparece en pantalla y permite a las personas ciegas manejar el dispositivo. Usa una voz sintética, pero hace mucho más que leer.
- La lectura en voz alta: la función que lee un artículo o un texto seleccionado, por ejemplo en el navegador o en un lector de libros electrónicos.
- El asistente de voz: primero entiende tu pregunta con reconocimiento de voz y después responde con una voz sintética.
¿Para qué sirve la síntesis de voz?
- Accesibilidad: los lectores de pantalla leen el contenido a personas ciegas o con baja visión.
- Leer textos: navegadores, lectores de libros electrónicos y móviles leen artículos y documentos; los pasos para cada dispositivo están en nuestra guía para leer un texto en voz alta.
- Navegación y avisos: las indicaciones del GPS, los mensajes automáticos y las centralitas de atención al cliente.
- Vídeos: muchos tutoriales y anuncios llevan una voz sintética, y el doblaje con IA la usa para poner voz a una traducción (consulta qué es el doblaje).
- Streaming: en Twitch, herramientas como Streamlabs leen en directo el mensaje de un espectador que envía una propina o bits. El streamer fija un importe mínimo, elige la voz y puede filtrar el spam y los insultos.
Cómo funciona la síntesis de voz: los seis pasos
La norma del W3C para marcar textos destinados a la síntesis de voz, SSML, describe el camino del texto al sonido en seis pasos. Tomemos la frase «El 25/10/2026 la Sra. García pagó 1.234,56 €.»:
- Leer las marcas: si el texto lleva instrucciones SSML, el motor las lee primero.
- Analizar la estructura: localizar párrafos y frases para hacer las pausas en su sitio.
- Normalizar el texto:
25/10/2026pasa a «veinticinco de octubre de dos mil veintiséis»,Sra.a «señora» y el importe a «mil doscientos treinta y cuatro euros con cincuenta y seis». Es el paso más delicado: la propia norma reconoce que, ante formas ambiguas, dos motores pueden leer el mismo texto de manera distinta. - Convertir en fonemas: cada palabra recibe su pronunciación.
- Prosodia: entonación, ritmo, pausas y acentos.
- Generar el sonido: se produce el audio.
Antes, los motores unían fragmentos grabados por un locutor o calculaban la voz con un modelo estadístico; según DeepMind, el primer método era difícil de cambiar sin grabar una base de datos nueva y el segundo sonaba menos natural. En 2016, su red neuronal WaveNet demostró que se podía generar directamente la onda sonora. En 2017, Tacotron 2 combinó una red que calcula un espectrograma a partir del texto con una variante de WaveNet que lo convierte en sonido. Hoy Microsoft afirma que sus voces neuronales son casi indistinguibles de las grabaciones de voces humanas.
Wolfgang von Kempelen describió en 1791 una máquina parlante que funcionaba con un fuelle; el Deutsches Museum de Múnich conserva un ejemplar considerado el más antiguo de su tipo. Hubo que esperar a 1939, con el Voder de Homer Dudley, para oír una voz generada electrónicamente. En los móviles, Android incorporó un motor de síntesis de voz en la versión 1.6, en 2009, con el español entre sus cinco primeros idiomas; el código fuente de Android incluye además los archivos en español del motor Pico, de la empresa suiza SVOX.
Nuestra prueba: las voces en español de nuestro PC
Las voces disponibles dependen del dispositivo. En nuestro PC de pruebas, con Windows 11 configurado en turco, revisamos qué voces ofrecen Chrome y Edge a las páginas web y cuáles tenía instaladas Windows.
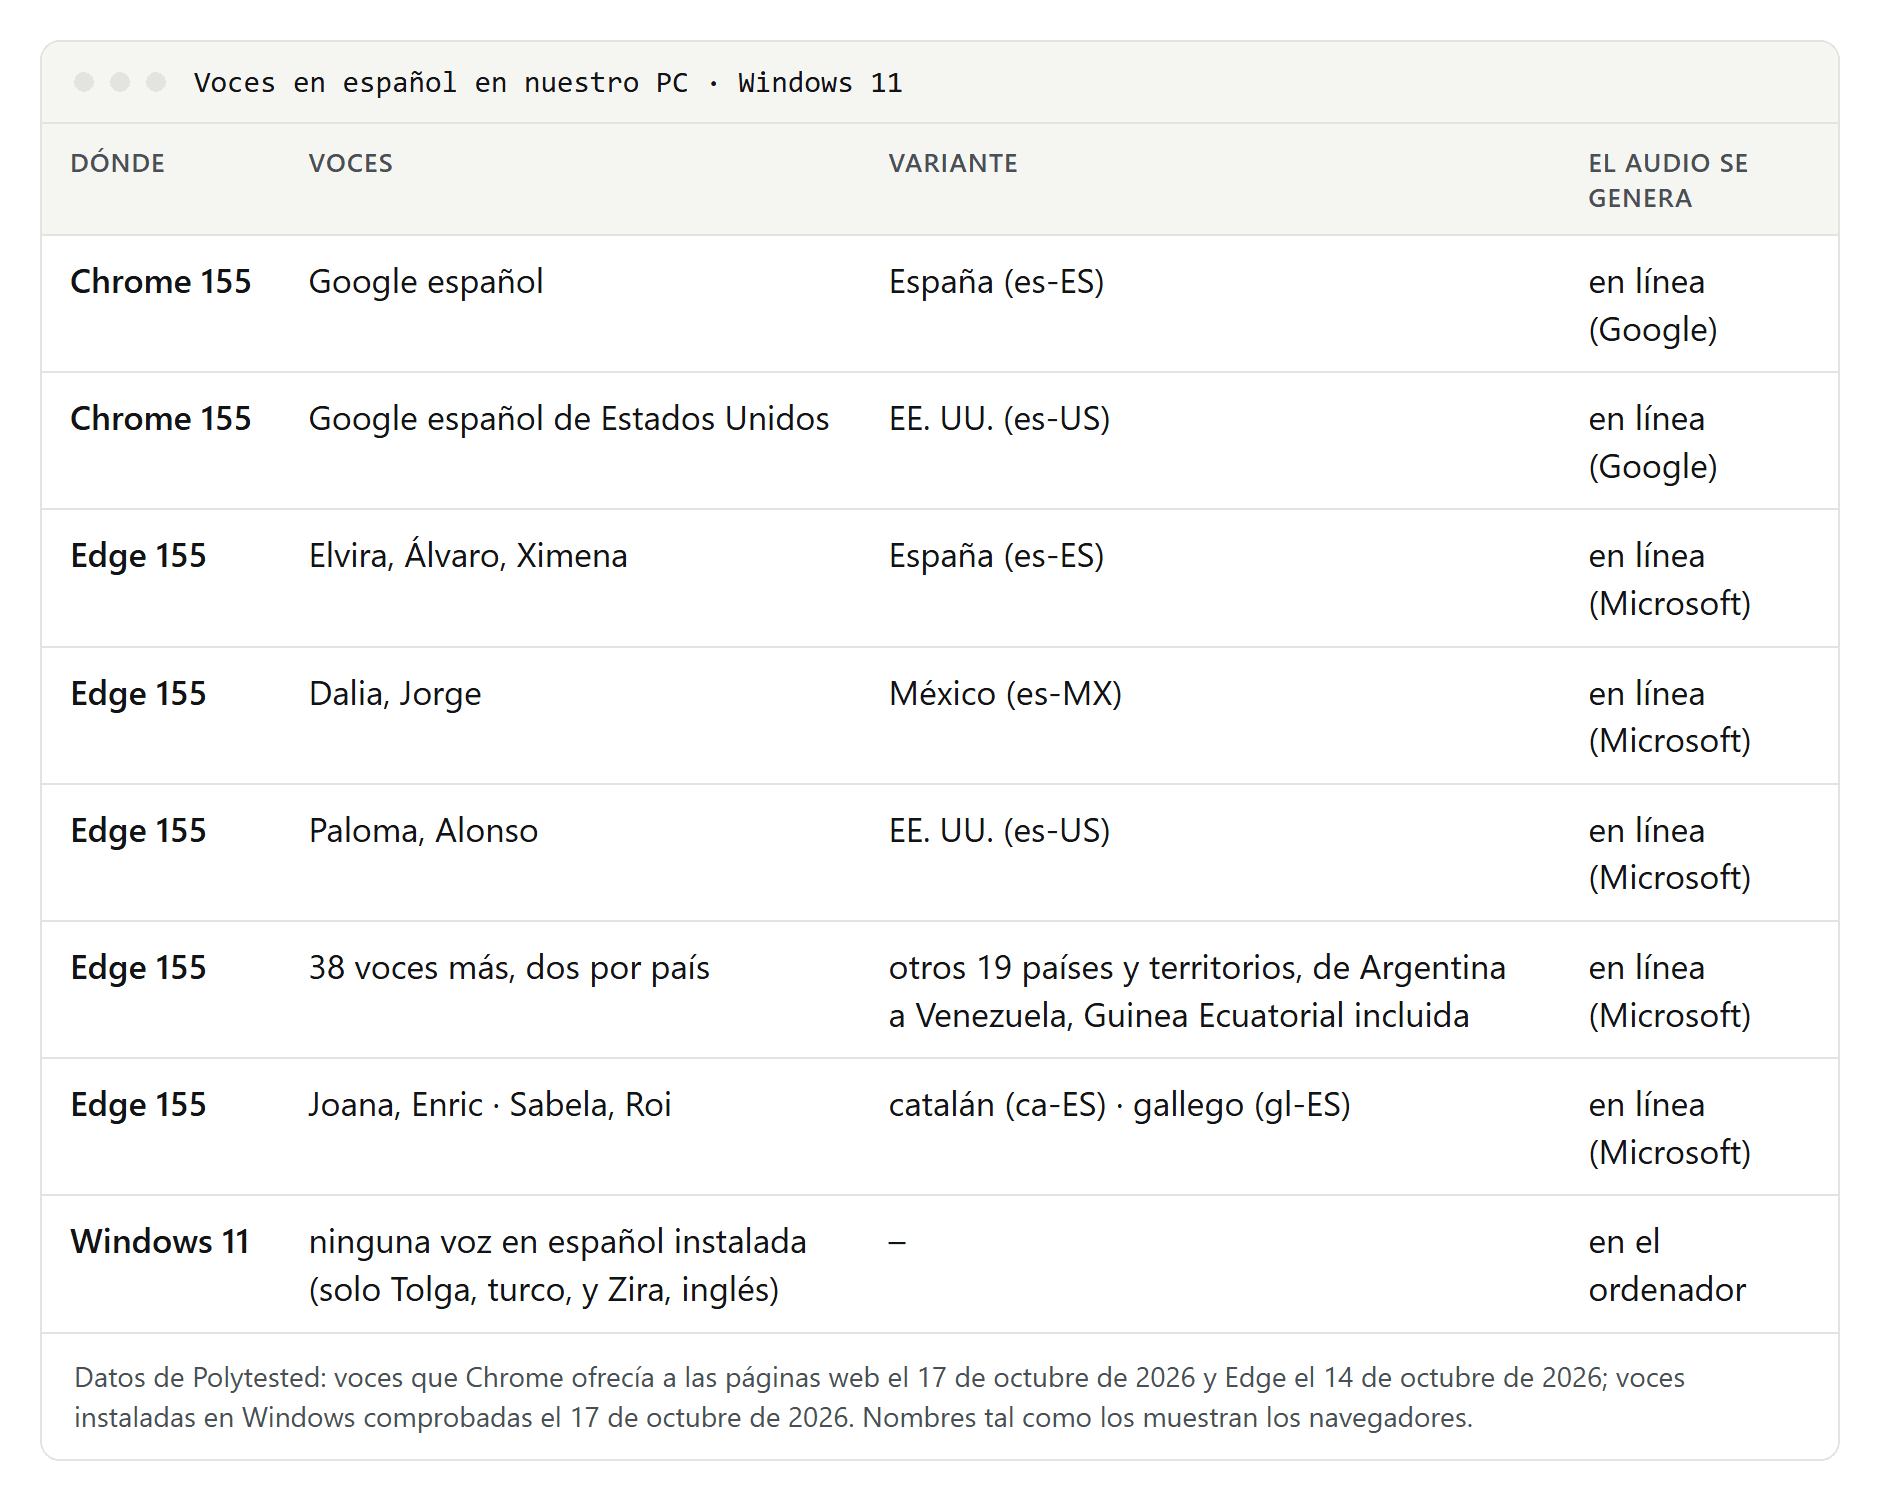
- Chrome 155 ofrecía 20 voces el 17 de octubre de 2026: 19 voces de Google en línea, entre ellas «Google español» y «Google español de Estados Unidos», y una sola voz de Windows, Microsoft Tolga (turco).
- Edge 155 ofrecía 322 el 14 de octubre: 321 voces en línea de Microsoft, más Tolga. De ellas, 45 eran en español, en 22 variantes: tres para España (Elvira, Álvaro y Ximena) y dos para cada una de las demás, de México a Guinea Ecuatorial. Había además dos voces en catalán y dos en gallego; en euskera, ninguna.
- Windows no tenía ninguna voz en español. Tiene dos listas de voces: la antigua solo contenía Microsoft Zira (inglés de Estados Unidos) y la nueva, solo Tolga.
Zira no aparece en ningún navegador: según el código fuente de Chromium, la base de Chrome y Edge, en Windows el navegador lee primero la lista nueva y solo recurre a la antigua si falla. Un detalle si programas: la voz de Windows llegó un instante después que las voces en línea (el primer aviso traía 19 voces y el segundo, 20), así que espera al evento voiceschanged antes de leer la lista.
Voz local o voz en línea: adónde va tu texto
Cada voz del navegador es local, si se genera en tu dispositivo, o en línea, si la produce un servicio de internet. Según MDN, la propiedad localService indica de qué tipo es, y una voz en línea puede suponer más espera, más tráfico o costes adicionales. Miramos en el registro de red del navegador qué significa esto para tu texto (prueba del 14 de octubre de 2026, con una frase en alemán):
- Chrome con una voz de Google: Chrome envió la frase entera dentro de la dirección de una petición a google.com. Lo probamos con «Google Deutsch»; según el código fuente de Chromium, «Google español» forma parte de la misma extensión y sigue el mismo camino.
- Edge con una voz «Online (Natural)»: Edge abrió una conexión con un servidor de Microsoft. Microsoft indica que, con las voces que llevan «Online» en el nombre, el texto viaja cifrado junto con un token aleatorio, y que el texto y el audio se borran justo después de la conversión.
- Voz local de Windows: ninguna petición. Según Microsoft, con una voz local no se envía nada.
Las voces naturales del Narrador, entre ellas las de España y México, también funcionan en el dispositivo: según Microsoft, una vez descargadas, no necesitan conexión a internet. Nuestro consejo: para un contrato, datos de salud o datos personales de otras personas, usa una voz local.
Voces en español en Windows, Mac, iPhone y Android
- Windows: Microsoft indica para el español las voces Pablo, Helena y Laura (España) y Raúl y Sabina (México), además de Herena para el catalán. Para el Narrador hay voces naturales: Álvaro y Elvira (España), Jorge y Dalia (México). Abre la configuración del Narrador con la tecla Windows + Ctrl + N, elige «Agregar voces heredadas» y después «Agregar voces» en «Administrar voces». Las voces naturales se instalan con el botón «Agregar» de la sección «Agregar voces naturales».
- Mac: menú Apple > Ajustes del Sistema > Accesibilidad > «Lectura y voz», menú «Voz del sistema». Las voces nuevas se descargan de Apple y necesitan conexión a internet; Apple avisa de que no hay voces en todos los idiomas.
- iPhone y iPad: Ajustes > Accesibilidad > «Lectura y voz» > Voces, donde eliges una voz y un dialecto. Según Apple, las voces de calidad mejorada pueden ocupar 100 MB o más y se descargan por wifi. En la misma pantalla están «Detectar idiomas» y «Pronunciaciones», para dictar o deletrear cómo debe pronunciarse una palabra. La «voz personal», una versión sintética de tu propia voz, existe en español de México; aparte, solo en inglés (Estados Unidos) y chino mandarín.
- Android: Ajustes > Accesibilidad > «Salida de conversión de texto a voz». Ahí eliges el motor (el de Google, el del fabricante o uno descargado de Google Play), el idioma, la velocidad y el tono. «Instalar datos de voz» añade otros idiomas.
Voces en español en la nube y de código abierto
Para vídeos, webs o aplicaciones se suele recurrir a un servicio en la nube. Sin precios; los nombres salen de la documentación de cada proveedor:
- Microsoft: las voces «Online» de Edge proceden de su servicio en la nube, que según Microsoft cubre más de 100 idiomas y variantes regionales. Las voces en español que encontramos están en la tabla de arriba.
- Amazon Polly: Conchita, Lucia, Alba, Enrique, Sergio y Raúl para España; Mia y Andrés para México; Lupe, Penélope, Miguel y Pedro para Estados Unidos, y Arlet para el catalán.
- Piper: un motor de código abierto que funciona por completo en tu ordenador. Su lista incluye ocho voces en español (cinco de España, dos de México y una de Argentina) y dos en catalán.
La calidad en español de las grandes voces de IA, como las de ElevenLabs, la mediremos en nuestras propias pruebas.
Números, fechas y abreviaturas: donde la voz tropieza
Una persona entiende al momento 25/10/2026 o 1.234,56 €; una voz tiene que adivinarlo, y las convenciones cambian según el país. Lo muestran los formatos por defecto de Unicode CLDR, la base de datos que usan muchos programas (nuestra consulta del 17 de octubre de 2026, CLDR 46):
| Variante | 25 de octubre de 2026 | El número 1234,56 |
|---|---|---|
| España (es-ES) | 25/10/2026 | 1234,56 |
| México (es-MX) | 25/10/2026 | 1,234.56 |
| Estados Unidos (es-US) | 25/10/2026 | 1,234.56 |
| Argentina (es-AR) | 25/10/2026 | 1.234,56 |
| Colombia (es-CO) | 25/10/2026 | 1.234,56 |
| Inglés de EE. UU. (en-US) | 10/25/2026 | 1,234.56 |
En México, 1,234 es un número con separador de miles; en España, la coma marca decimales. La voz tiene que saber qué convención sigue el texto, así que elige la voz del país de tu público y escucha el resultado. A esto se suman las abreviaturas (Sr., Dra., pág., EE. UU., n.º) y los ordinales (1.º, 2.ª).
Nuestra prueba con una frase en alemán llena de estas trampas (14 y 15 de octubre de 2026) muestra qué pasa con una voz de otro idioma. Las voces alemanas en línea de Microsoft trataron la fecha, el importe 1.234,56 € y las abreviaturas como bloques únicos. La voz inglesa Zira partió el importe por el punto y por la coma, como si fuera una cifra inglesa, y la voz turca Tolga dividió la fecha en siete trozos y el importe en ocho. Estos cortes muestran cómo leyó la voz el texto, no si la pronunciación es correcta; para eso hace falta un oído humano. La regla es sencilla: un texto en español, con una voz en español.
Tildes, siglas y anglicismos: los retos del español
Incluso una buena voz en español tiene dificultades propias del idioma:
- Las tildes: «práctico», «practico» y «practicó» son tres palabras distintas, y solo la tilde dice dónde va el acento. Si el texto llega sin tildes, algo habitual en mensajes escritos con prisa en el móvil, la voz tiene que adivinar; si sigue las reglas generales de acentuación, leerá «practico» aunque quisieras decir «práctico». Lo mismo pasa con «papa» y «papá».
- Las siglas: «ONU» se lee como una palabra, mientras que «DNI» se deletrea. La voz tiene que saber cuál es cuál.
- Los anglicismos y los nombres propios: «streaming», «meeting» o una marca en mitad de una frase en español. Microsoft indica que sus voces multilingües reconocen por sí mismas el idioma del texto, y el iPhone ofrece «Detectar idiomas».
En una web, marca los fragmentos en otro idioma con el atributo lang para que los lectores de pantalla apliquen las reglas de pronunciación correctas. Las pautas de accesibilidad WCAG eximen de ello a los nombres propios, los términos técnicos y las palabras que ya forman parte del idioma.
SSML: cómo decirle a la voz qué leer y cómo
Si programas síntesis de voz o usas un servicio en la nube, el lenguaje SSML te permite indicar cómo leer partes concretas del texto. Los servicios de Google, Amazon y Microsoft lo admiten, cada uno con sus propios límites. Los elementos principales de la norma del W3C:
<speak version="1.1" xmlns="http://www.w3.org/2001/10/synthesis" xml:lang="es-ES">
  La cita es el <say-as interpret-as="date" format="dmy">25/10/2026</say-as>
  con la <sub alias="señora">Sra.</sub> García.
  Trae el <say-as interpret-as="characters">DNI</say-as>.
  Hoy viene <phoneme alphabet="ipa" ph="paˈpa">papa</phoneme>.
  El <lang xml:lang="en-US">meeting</lang> empieza puntual.
</speak>
say-as indica cómo leer una fecha (aquí, día, mes y año) o una sigla letra a letra; sub sustituye una abreviatura por lo que debe decirse; phoneme fija la pronunciación con el alfabeto fonético (aquí, «papá» aunque falte la tilde), y lang marca un fragmento en otro idioma.
La norma advierte de que dos motores pueden interpretar el mismo documento de forma distinta, así que prueba con la voz que vayas a usar. Este ejemplo sigue la documentación del W3C; no lo hemos probado en un servicio en la nube.
Voces sintéticas y el reglamento europeo de IA
Desde el 2 de agosto de 2026 se aplican las obligaciones de transparencia del artículo 50 del reglamento europeo de inteligencia artificial. Esto no es asesoramiento jurídico, pero las líneas generales son claras:
- Marcado por los proveedores: un sistema de IA que genera audio, imágenes, vídeo o texto sintéticos debe marcar sus resultados en un formato legible por máquina. Para los sistemas que ya estaban en el mercado antes del 2 de agosto de 2026, una modificación del reglamento da de plazo hasta el 2 de diciembre de 2026.
- Ultrafalsificaciones: quien use una IA para generar una ultrafalsificación (deepfake) de imagen, audio o vídeo debe hacer público que el contenido es artificial. El reglamento entiende por ello un contenido que se parece a personas, lugares o hechos reales y que podría pasar por auténtico. En una obra claramente artística, satírica o de ficción basta con un aviso adecuado que no estropee la obra.
- Lo que aclaran las directrices de la Comisión: el uso puramente personal y no profesional queda fuera del reglamento. Las voces que ayudan a comunicarse a personas con discapacidad no tienen que marcarse; el habla realista con la voz de una persona concreta, sí.
- Sanciones: hasta 15 millones de euros o el 3 por ciento del volumen de negocios mundial anual, si esta cifra es mayor.
En la práctica: que una voz te lea un texto a ti no está afectado. Si publicas un vídeo con una voz de IA, avisa cuando la voz pueda pasar por la de una persona real; ante la duda, avisa siempre. En España, el organismo público encargado de velar por un uso seguro de la IA es la Agencia Española de Supervisión de Inteligencia Artificial (AESIA).
Voces clonadas: cómo detectar la estafa
La técnica que lee tus textos también puede imitar una voz. En junio de 2024, el INCIBE contó el caso de una usuaria que recibió una grabación con la voz de su marido pidiéndole escribir a otro número; lo llamó al teléfono de siempre y él no sabía nada. Según el INCIBE, con herramientas de IA bastan unos segundos de grabación para imitar una voz. Sus consejos:
- contrasta la información con la persona que supuestamente llama, por el canal de siempre;
- no des nunca datos personales ni bancarios, ni sigas instrucciones como abrir enlaces o instalar aplicaciones;
- acuerda con tu familia y tus amigos una palabra clave para comprobar quién habla.
Si tienes dudas, la Línea de Ayuda en Ciberseguridad del INCIBE responde en el 017.
