TTS steht in diesem Artikel für Text-to-Speech, auf Deutsch Sprachsynthese: Software liest einen geschriebenen Text mit einer künstlichen Stimme vor. Die Abkürzung hat noch andere Bedeutungen, vom Medikamentenpflaster bis zum Twitch-Chat; die wichtigsten stehen gleich im ersten Abschnitt. Danach erklären wir, wie aus Text Sprache wird, welche deutschen Stimmen es auf PC, Handy und in der Cloud gibt, warum Datumsangaben und Abkürzungen Stimmen ins Stolpern bringen und was die KI-Verordnung seit August 2026 für KI-Stimmen verlangt. Dazu kommen zwei eigene Tests: wohin dein Satz geht, wenn der Browser ihn vorliest, und wie verschiedene Stimmen denselben deutschen Satz zerlegen. Stand: 15. Oktober 2026.
TTS-Bedeutung: Text-to-Speech und was die Abkürzung sonst heißt
Text-to-Speech heißt wörtlich „Text zu Sprache“. Der Duden kennt den englischen Begriff nicht, beschreibt dieselbe Sache aber unter „Sprachausgabe“ als „digitale Umsetzung eines Textes in hörbare Sprache“ und unter „Sprachsynthese“ als Erzeugung von Sprache mit elektronischen Mitteln. Das Gegenstück ist Speech-to-Text (STT), die Spracherkennung, die aus gesprochener Sprache Text macht.
Wer „TTS Bedeutung“ sucht, meint oft etwas anderes. Die häufigsten anderen Bedeutungen:
- Medizin: Ein transdermales therapeutisches System ist ein Wirkstoffpflaster, etwa gegen Schmerzen. Außerdem steht TTS für das Thrombose-mit-Thrombozytopenie-Syndrom und in der Hörmedizin für eine vorübergehende Hörschwellenverschiebung (Temporary Threshold Shift).
- Schule: „Texte, Themen und Strukturen“ heißt eine Deutschbuch-Reihe von Cornelsen für die Oberstufe.
- Twitch und Streaming: eine Nachricht aus dem Chat, die eine künstliche Stimme im Stream vorliest, meist gegen ein Trinkgeld. Das ist also doch Text-to-Speech.
- Samsung: „Samsung TTS“ ist die Sprachausgabe von Samsung-Handys; die deutsche Stimme kommt als eigenes Sprachpaket.
- Sneaker-Szene: „True to Size“, also passend zur üblichen Größe.
Sprachsynthese, Sprachausgabe, Vorlesefunktion: die deutschen Begriffe
Im Deutschen gibt es mehrere Wörter, und eines davon bedeutet je nach Gerät etwas anderes:
- Sprachsynthese ist der Fachbegriff. Microsoft verwendet ihn in seiner deutschen Dokumentation gleichbedeutend mit „Text-zu-Sprache“.
- Sprachausgabe heißt in Windows der Screenreader (englisch Narrator), also ein Programm, das den ganzen Bildschirm vorliest und Blinden die Bedienung ermöglicht. Auf Android heißt dagegen die Einstellungsseite für die TTS-Engine „Sprachausgabe“; dort wählst du Engine, Sprache, Sprechtempo und Stimmlage.
- Vorlesefunktion nennen viele Programme das Vorlesen eines markierten Textes oder einer Webseite, etwa „Laut vorlesen“ in Edge oder Word.
- Sprachassistenten wie Siri oder Alexa nutzen TTS für ihre Antworten, verstehen dich aber zuerst per Spracherkennung.
Ein Screenreader ist also nicht dasselbe wie TTS: Er ist eine Anwendung, die eine TTS-Stimme nutzt, um Bildschirminhalte vorzulesen und durch sie zu navigieren. Die Windows-Sprachausgabe startest und beendest du mit Windows-Logo-Taste + Strg + Eingabe; ihre Einstellungen öffnet Windows-Logo-Taste + Strg + N.
So wird aus Text Sprache: die sechs Schritte
Der W3C-Standard für die Sprachsynthese-Auszeichnung SSML beschreibt den Weg vom Text zum Ton in sechs Schritten. Am Beispielsatz „Am 25.10.2026 kostet das Update …“ sieht das so aus:
- Markup einlesen: Ist der Text mit SSML ausgezeichnet, liest das Programm zuerst diese Anweisungen.
- Struktur erkennen: Absätze und Sätze, damit die Stimme an den richtigen Stellen Pause macht.
- Text normalisieren: Aus
25.10.2026wird „fünfundzwanzigsten Oktober zweitausendsechsundzwanzig“, ausz. B.wird „zum Beispiel“. Hier entstehen die meisten Fehler; der Standard sagt selbst, dass verschiedene Programme denselben Text wegen solcher Mehrdeutigkeiten unterschiedlich lesen können. - Text in Laute umwandeln: Jedes Wort bekommt seine Aussprache, also die Folge von Lauten.
- Prosodie festlegen: Betonung, Satzmelodie, Tempo und Pausen.
- Klang erzeugen: Am Ende entsteht die Tonspur.
Früher setzten Programme die Stimme aus aufgenommenen Lautstücken eines Sprechers zusammen oder berechneten sie aus einem Klangmodell. Die einen klangen holprig an den Nahtstellen, die anderen künstlich. 2016 stellte DeepMind mit WaveNet ein neuronales Netz vor, das die Tonspur selbst Stück für Stück erzeugt. Tacotron 2 kombinierte 2017 ein Netz, das aus Text ein Spektrogramm berechnet, mit einer WaveNet-Variante als Klangerzeuger. Heutige neuronale Stimmen klingen deshalb oft kaum noch von Aufnahmen zu unterscheiden; Microsoft schreibt, dass seine neuronalen Stimmen Betonung und Klang gemeinsam berechnen.
Von Kempelens Sprechmaschine zur KI-Stimme
Der Traum von der künstlichen Stimme ist älter als jeder Computer. Wolfgang von Kempelen beschrieb 1791 in seinem Buch „Mechanismus der menschlichen Sprache nebst der Beschreibung seiner sprechenden Maschine“ einen Apparat mit Blasebalg statt Lunge. Das Deutsche Museum in München bewahrt einen solchen Sprechapparat, der als ältester seiner Art gilt, und hat 2013/14 eine genaue Replik gebaut, um herauszufinden, was er konnte. Ein Nachbau im Heinz Nixdorf MuseumsForum in Paderborn sagt „Mama“ und „Papa“ und einige einzelne Laute. Elektronisch erzeugte Sprache gelang erst 1939 mit Homer Dudleys „Voder“.
Für Smartphones begann es 2009: Android 1.6 brachte eine TTS-Engine mit, die neben Englisch, Französisch, Italienisch und Spanisch auch Deutsch sprach. Im offenen Quellcode von Android steckt die Engine Pico der Zürcher Firma SVOX samt deutschen Sprachdateien. Seit WaveNet 2016 sind neuronale Stimmen der Standard.
Wo dir TTS im Alltag begegnet
- Barrierefreiheit: Screenreader wie die Windows-Sprachausgabe, VoiceOver bei Apple oder TalkBack bei Android lesen Blinden und Sehbehinderten den Bildschirm vor. Der Bundesverband Legasthenie empfiehlt Erwachsenen außerdem, eigene Texte vorlesen zu lassen, weil man Fehler oft leichter hört als sieht.
- Automaten und E-Book-Reader: Seit dem 28. Juni 2025 müssen neue Selbstbedienungsterminals wie Fahrkartenautomaten laut Verordnung zum Barrierefreiheitsstärkungsgesetz mit Sprachausgabe ausgestattet sein, ebenso neue E-Book-Lesegeräte. Ältere Terminals dürfen nach den Übergangsregeln noch bis zum Ende ihrer wirtschaftlichen Nutzungsdauer laufen, höchstens 15 Jahre nach Inbetriebnahme.
- Navigation und Durchsagen: Abbiegehinweise im Auto und viele automatische Ansagen.
- Videos: Sprecherstimmen in Erklärvideos und die automatische Synchronisation auf YouTube, die du in unserem Ratgeber YouTube-Synchronisation ausschalten wieder loswirst.
- Streaming: Bei Twitch-Streams liest eine künstliche Stimme Nachrichten vor, wenn Zuschauer ein Trinkgeld oder Bits schicken. Laut Streamlabs legt der Streamer dafür einen Mindestbetrag und die Stimme fest; Filter gegen Spam und Schimpfwörter gibt es auch.
- Telefon und Kundenservice: Sprachdialoge in Hotlines und KI-Telefonassistenten.
Unser Test: Welche Stimmen auf unserem Windows-PC stecken
Welche Stimmen ein Browser anbietet, hängt vom Gerät ab. Auf unserem Testrechner, Windows 11 mit türkischer Systemsprache, haben wir am 14. und 15. Oktober 2026 nachgesehen:
- Windows hat zwei getrennte Stimmenlisten. In der älteren stand eine einzige Stimme, Microsoft Zira (Englisch, USA), in der neueren eine einzige andere, Microsoft Tolga (Türkisch). Eine deutsche Stimme war nicht installiert.
- Chrome 155 bot 20 Stimmen an: 19 Online-Stimmen von Google, darunter „Google Deutsch“, und die lokale Windows-Stimme Tolga.
- Edge 155 bot 322 Stimmen an: 321 Online-Stimmen von Microsoft und ebenfalls Tolga. Für Deutsch waren es zehn Online-Stimmen, darunter je zwei für Österreich und die Schweiz.
Zira tauchte in keinem Browser auf. Der Grund steht im Quellcode von Chromium, auf dem Chrome und Edge beruhen: Unter Windows liest der Browser zuerst die neuere Stimmenliste und greift nur auf die ältere zurück, wenn das scheitert. Eine zweite Beobachtung ist für alle wichtig, die Stimmen per JavaScript abfragen: Die Online-Stimmen standen sofort bereit, die Windows-Stimme kam einen Moment später dazu. Eine unserer ersten Abfragen hat sie deshalb übersehen. Wer die Liste zu früh ausliest, bekommt nicht alle Stimmen; das Ereignis voiceschanged meldet, wenn sich die Liste ändert.
Wie du in Chrome, Edge, Word und am Handy vorlesen lässt und welche Stimmen dort jeweils zur Wahl stehen, steht in unserem Ratgeber Text vorlesen lassen.
Lokal oder online: Wohin dein Text geht
Jede Stimme im Browser ist entweder lokal, also auf deinem Gerät, oder online, also bei einem Dienst im Netz. Laut MDN zeigt die Eigenschaft localService, welche Art es ist; Online-Stimmen können zusätzliche Wartezeit, Datenverkehr oder Kosten verursachen. Was das für deinen Text bedeutet, haben wir mit dem Netzwerkprotokoll des Browsers nachgesehen:
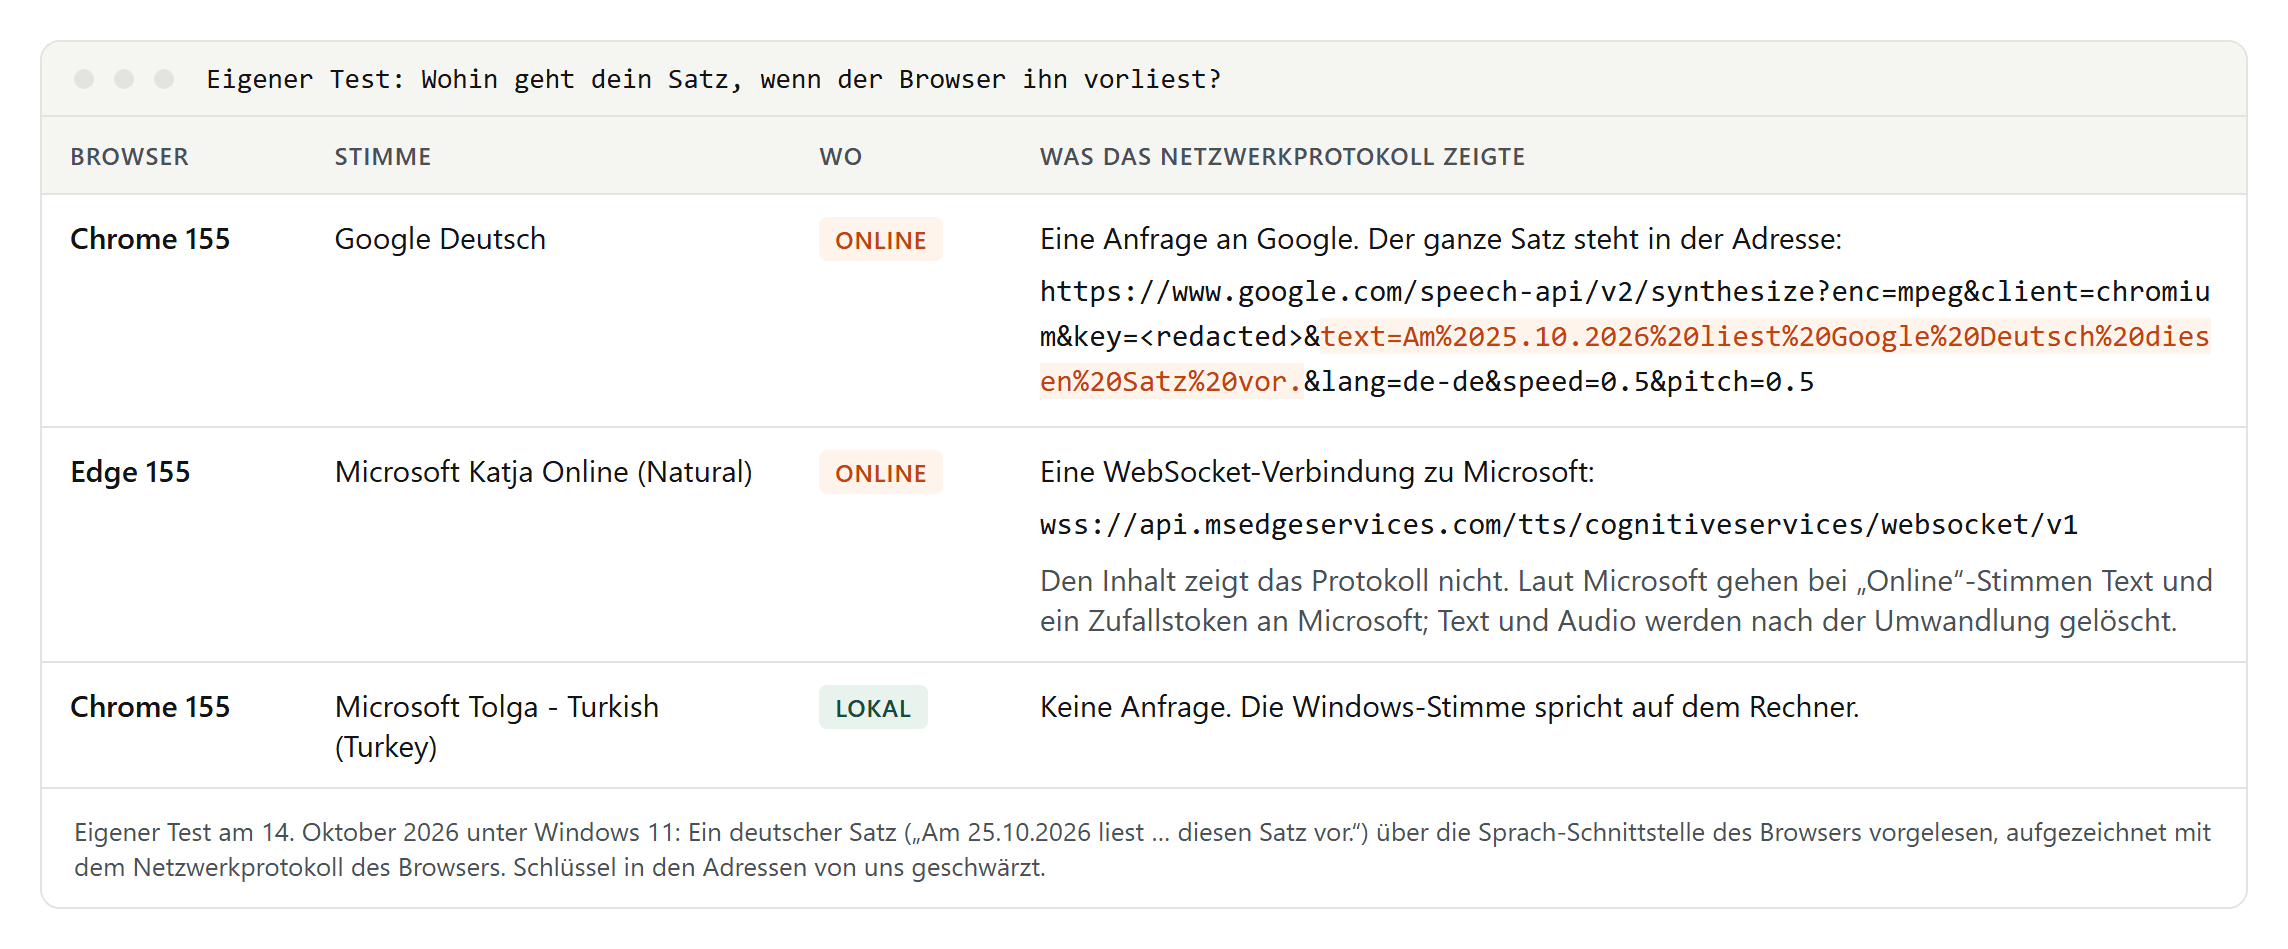
- Chrome mit „Google Deutsch“: Chrome schickte den ganzen Satz in der Adresse einer Anfrage an Google. Genau so baut auch der Quellcode von Chromium die Anfrage auf. Eine eigene Datenschutzangabe von Google zu diesem Weg haben wir nicht gefunden; die Angaben zur bezahlten Google-Cloud-Sprachausgabe gelten für einen anderen Dienst.
- Edge mit „Online (Natural)“-Stimmen: Edge öffnete eine Verbindung zu Microsoft. Laut Microsoft gehen bei Stimmen mit „Online“ im Namen der Text und ein zufälliges Token verschlüsselt an Microsoft, und Text und Audio werden direkt nach der Umwandlung gelöscht.
- Lokale Windows-Stimme: keine Anfrage. Laut Microsoft gelangen bei lokalen Stimmen keine Daten zu Microsoft.
Die natürlichen Stimmen der Windows-Sprachausgabe, darunter deutsche, arbeiten laut Microsoft ebenfalls auf dem Gerät und funktionieren nach dem Herunterladen ohne Internet.
Deutsche Stimmen auf Windows, Mac, iPhone und Android
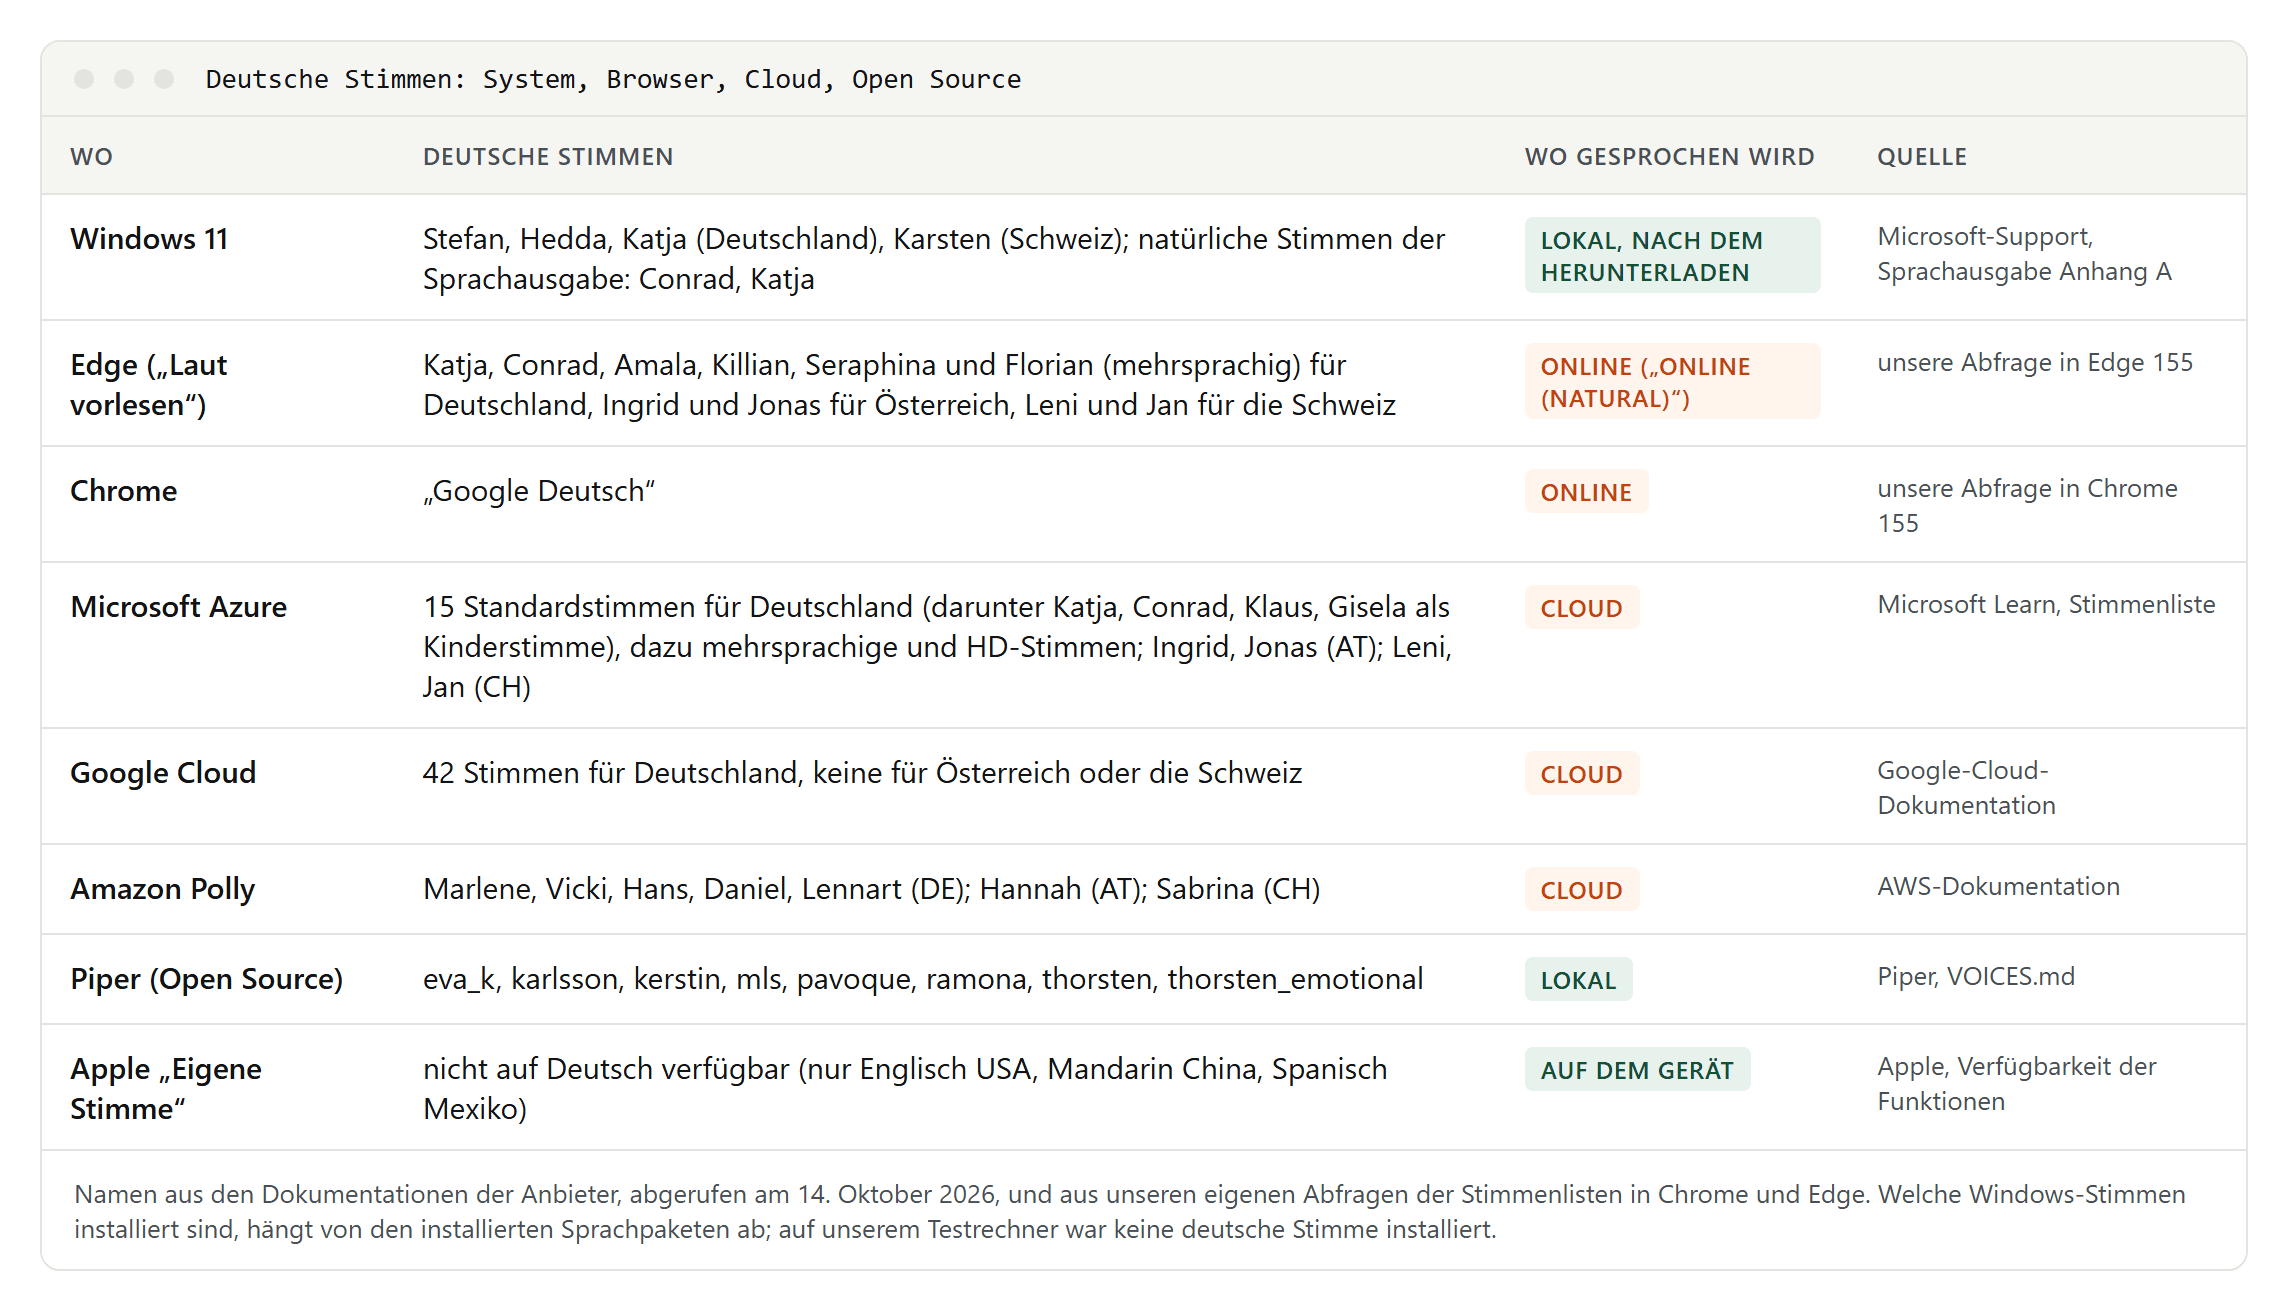
- Windows: Microsoft nennt als deutsche Stimmen Stefan, Hedda und Katja, für die Schweiz Karsten. Die natürlichen Stimmen der Sprachausgabe heißen für Deutsch Conrad und Katja; du fügst sie in den Einstellungen der Sprachausgabe unter „Natürliche Stimmen hinzufügen“ hinzu. Welche Stimmen ein Rechner hat, hängt von den installierten Sprachpaketen ab.
- Mac: „Systemeinstellungen“ → „Bedienungshilfen“ → „Lesen & Sprechen“ → „Systemstimme“. Weitere Stimmen lädt der Mac bei Apple herunter, dafür brauchst du eine Internetverbindung.
- iPhone und iPad: Für VoiceOver und die Vorlesefunktionen ist eine kompakte Stimme vorinstalliert. Bessere Stimmen sind laut Apple oft 100 MB oder größer und lassen sich nur über WLAN laden. Apples „Eigene Stimme“, mit der du eine synthetische Version deiner eigenen Stimme erstellst, gibt es nur auf Englisch (USA), Mandarin (China) und Spanisch (Mexiko), nicht auf Deutsch.
- Android: In den Einstellungen unter „Sprachausgabe“ wählst du die Engine, etwa Googles „Speech Recognition & Synthesis“ oder die des Herstellers. Weitere Sprachen installierst du über „Sprachdaten installieren“.
- Samsung: Galaxy-Geräte haben eine eigene Engine. Die deutsche Stimme heißt im Galaxy Store „Samsung TTS Deutsch Stimme 1“; sie dient laut Samsung unter anderem der Systemsprachausgabe, TalkBack und Bixby.
Deutsche Stimmen in der Cloud und als Open Source
Wer Stimmen für Videos, Websites oder Apps braucht, landet meist bei den Cloud-Diensten. Preise lassen wir hier weg; die Namen stammen aus den Dokumentationen der Anbieter:
- Microsoft Azure: 15 Standardstimmen für Deutschland, darunter Katja, Conrad, Klaus und Gisela, eine Kinderstimme, dazu die mehrsprachigen Stimmen Seraphina und Florian. Für Österreich gibt es Ingrid und Jonas, für die Schweiz Leni und Jan. Edge nutzt davon zehn.
- Google Cloud: 42 Stimmen für Deutschland, aber keine für Österreich oder die Schweiz. Viele der neuesten tragen Namen von Sternen und Monden wie Achernar oder Callirrhoe.
- Amazon Polly: Marlene, Vicki, Hans, Daniel und Lennart für Deutschland, Hannah für Österreich, Sabrina für die Schweiz.
- Open Source: Piper läuft lokal und hat acht deutsche Stimmen. Eine davon stammt von Thorsten Müller, der seine Stimme für freie deutsche Sprachsynthese gespendet hat; sein Projekt Thorsten-Voice bietet unter anderem einen Datensatz auf Hessisch. Älter ist MaryTTS, eine offene Sprachsynthese des Deutschen Forschungszentrums für Künstliche Intelligenz (DFKI).
- Anbieter aus dem deutschsprachigen Raum: etwa Aristech aus Heidelberg für Kundenservice-Anwendungen und linguatec aus München mit dem Programm „Voice Reader“.
Wie gut die großen KI-Stimmen auf Deutsch, Französisch und Spanisch wirklich klingen, testen wir gesondert.
Warum TTS bei Zahlen, Daten und Abkürzungen stolpert
Ein Mensch liest 25.10.2026 selbstverständlich als Datum. Eine Stimme muss erst erkennen, dass Punkte hier keine Satzenden sind, dass das Datum hinter „Am“ ein Dativ ist und dass 1.234,56 € ein Betrag mit Dezimalkomma ist, kein englisches 1.234. Wir haben einen Satz voller solcher Stellen von verschiedenen Stimmen sprechen lassen und mitgeschrieben, welche Einheiten jede Stimme beim Sprechen meldet:
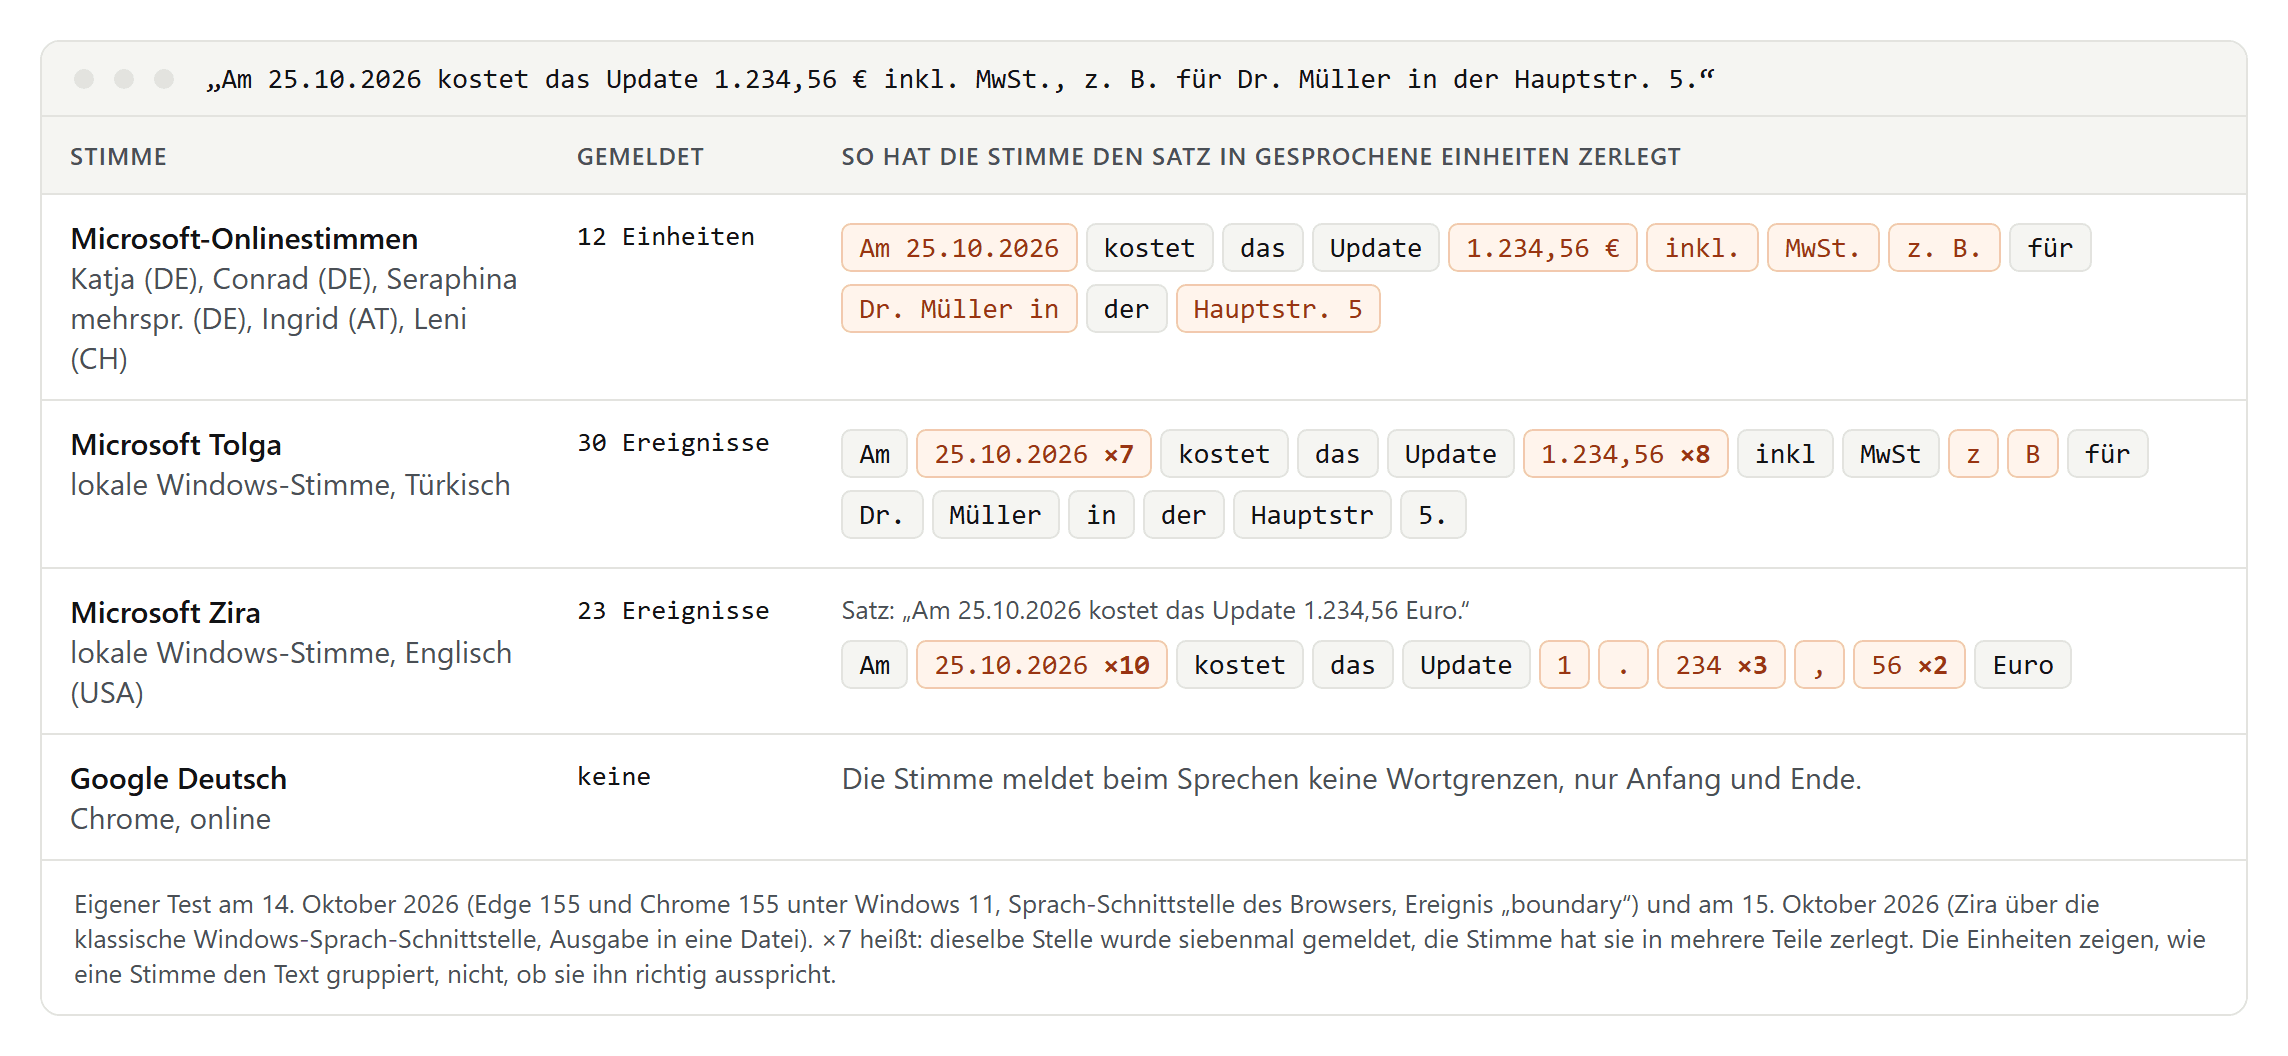
- Die deutschen Online-Stimmen von Microsoft (Katja, Conrad, Seraphina, dazu Ingrid aus Österreich und Leni aus der Schweiz) meldeten alle dieselben zwölf Einheiten. Datum, Betrag,
inkl.,MwSt.undz. B.behandelten sie jeweils als eine Einheit; sie haben den Satz also als deutschen Text erkannt. - Die türkische Windows-Stimme Tolga zerlegte das Datum in sieben und den Betrag in acht Teile und las
zundBgetrennt. - Die englische Windows-Stimme Zira trennte
1.234,56an Punkt und Komma, wie man es bei englischen Zahlen erwarten würde, und las bei „z. B.“ wieder zwei einzelne Buchstaben. - Google Deutsch in Chrome meldet solche Wortgrenzen gar nicht, nur Anfang und Ende.
Daraus folgt vor allem eine Regel: Lass deutschen Text von einer deutschen Stimme lesen. Eine Stimme für eine andere Sprache spricht zwar, liest aber Zahlen und Abkürzungen nach den Regeln ihrer eigenen Sprache. Ob die deutschen Stimmen alles richtig aussprechen, zeigt der Test nicht; dafür muss ein Mensch zuhören.
Betonung, ß und Anglizismen: die deutschen Aussprachefallen
Auch eine gute deutsche Stimme hat Schwächen, die mit der Sprache selbst zu tun haben:
- Gleich geschrieben, anders betont: „modern“ betont auf der ersten Silbe heißt verfaulen, auf der zweiten zeitgemäß; „umfahren“ betont auf „um“ heißt umstoßen, auf „fahren“ herumfahren. Der Duden gibt die Betonung jeweils an. Die Stimme muss sie aus dem Zusammenhang erraten.
- Zusammengesetzte Wörter: Ist das „Staubecken“ ein Becken zum Stauen von Wasser oder sind es staubige Ecken? Für die Aussprache macht das einen hörbaren Unterschied.
- ß in der Schweiz: Laut Duden wird in der Schweiz und in Liechtenstein grundsätzlich „ss“ statt „ß“ geschrieben. „Masse“ kann dort also auch „Maße“ meinen, und die Stimme sieht den Unterschied nicht.
- Englische Wörter: „Update“, „Download“ oder „Meeting“ stehen mitten im deutschen Satz. Das BSI nennt die falsche Aussprache englischer Wörter durch eine auf Deutsch trainierte Stimme ausdrücklich als typisches Merkmal synthetischer Sprache. Microsofts mehrsprachige Stimmen erkennen die Sprache dagegen selbst.
- Regionale Wörter: „Jänner“ für Januar ist in Österreich üblich. Unter den großen Cloud-Diensten haben Microsoft und Amazon eigene Stimmen für Österreich und die Schweiz, Google Cloud nicht.
Für Websites gilt: Passagen in einer anderen Sprache markierst du mit dem lang-Attribut, damit Screenreader die passenden Ausspracheregeln nutzen. Die Web-Richtlinien WCAG nehmen davon Eigennamen, Fachbegriffe und Wörter aus, die längst Teil der deutschen Sprache sind.
SSML: So sagst du der Stimme, wie sie lesen soll
Wer Sprachausgabe selbst programmiert oder einen Cloud-Dienst nutzt, kann der Stimme mit SSML sagen, wie sie einzelne Stellen lesen soll. Die wichtigsten Elemente aus dem W3C-Standard, die Microsoft und Google auch für Deutsch unterstützen:
- Datum:
<say-as interpret-as="date" format="dmy">25.10.2026</say-as>legt fest, dass Tag, Monat und Jahr in dieser Reihenfolge stehen. - Abkürzungen:
<sub alias="zum Beispiel">z. B.</sub>ersetzt beim Vorlesen die Abkürzung durch den ausgeschriebenen Text. - Aussprache: Das Element
phonemegibt eine Lautschrift vor, etwa um die Betonung von „modern“ festzulegen. - Sprachwechsel:
<lang xml:lang="en-US">Update</lang>lässt ein Wort mit englischer Aussprache lesen.
Der Standard sagt selbst, dass verschiedene Programme dasselbe Dokument unterschiedlich umsetzen können. Prüfe deshalb mit der Stimme, die du wirklich einsetzt. Die Beispiele oben sind nach den Dokumentationen von W3C, Microsoft und Google geschrieben; mit einem Cloud-Dienst getestet haben wir sie nicht.
KI-Stimmen und die KI-Verordnung: Was seit August 2026 gilt
Seit dem 2. August 2026 gelten die Transparenzpflichten aus Artikel 50 der europäischen KI-Verordnung. Das ist keine Rechtsberatung, aber die Grundzüge sind klar:
- Anbieter kennzeichnen maschinenlesbar: Wer ein KI-System anbietet, das synthetische Audio-, Bild-, Video- oder Textinhalte erzeugt, muss dafür sorgen, dass die Ausgaben maschinenlesbar als künstlich erzeugt erkennbar sind. Für Systeme, die schon vor dem 2. August 2026 auf dem Markt waren, gilt nach einer Änderung der Verordnung eine Frist bis zum 2. Dezember 2026.
- Deepfakes offenlegen: Wer mit KI Bild-, Ton- oder Videoinhalte erzeugt, die ein Deepfake sind, muss offenlegen, dass sie künstlich sind. Ein Deepfake ist laut Verordnung ein Inhalt, der echten Personen, Orten oder Ereignissen ähnelt und fälschlich als echt erscheinen würde. Bei offensichtlich künstlerischen, satirischen oder fiktionalen Werken genügt ein Hinweis, der das Werk nicht stört.
- Was die Leitlinien der EU-Kommission klarstellen: Rein private, nicht berufliche Nutzung fällt nicht unter die Verordnung. Stimmen, die Menschen mit Behinderung beim Kommunizieren helfen, etwa in der unterstützten Kommunikation, müssen nicht gekennzeichnet werden. Realistische Sprache in der Stimme einer bestimmten Person dagegen schon.
- Strafen: Verstöße gegen die Transparenzpflichten können mit bis zu 15 Millionen Euro oder bis zu 3 Prozent des weltweiten Jahresumsatzes geahndet werden, je nachdem, was höher ist.
- In Deutschland ist seit dem 29. Juli 2026 das KI-Marktüberwachungsgesetz (KI-MIG) in Kraft. Die Bundesnetzagentur ist damit Marktüberwachungsbehörde, Anlaufstelle und Beschwerdestelle für die KI-Verordnung.
Für die Praxis heißt das: Lässt du dir privat einen Text vorlesen, betrifft dich das nicht. Veröffentlichst du ein Video mit einer KI-Stimme, kennzeichnet der Anbieter die Datei maschinenlesbar; ob du zusätzlich offenlegen musst, hängt davon ab, ob die Stimme im Zusammenhang wie ein echter Mensch wirkt. Im Zweifel kennzeichne sie. Klonst du die Stimme eines echten Menschen, musst du das offenlegen und brauchst seine Einwilligung. Der Verband Deutscher Sprecher:innen fordert darüber hinaus, synthetische Stimmen, die Realität vorgeben, grundsätzlich hörbar zu kennzeichnen; das ist die Position eines Verbands, kein geltendes Recht.
Datenschutz: Was du einer Online-Stimme nicht vorlesen lassen solltest
Die deutschen Datenschutzbehörden haben 2024 eine Orientierungshilfe zu KI und Datenschutz veröffentlicht. Sie richtet sich vor allem an Chatbots, gilt nach eigenen Worten aber in weiten Teilen auch für andere KI-Anwendungen. Die Kernpunkte: Bei Cloud-Diensten verlassen deine Eingaben deinen geschützten Bereich, geschlossene Systeme sind vorzuziehen, ein Dienstleister braucht einen Vertrag zur Auftragsverarbeitung nach Art. 28 DSGVO, und Dienste, die Eingaben nicht zum Training nutzen, sind die bessere Wahl.
Übertragen auf Sprachausgabe heißt das: Gesundheitsdaten, Verträge oder personenbezogene Daten anderer gehören nicht in eine Online-Stimme, solange dein Arbeitgeber das nicht geregelt hat. Nimm dafür eine lokale Stimme. Unser Test oben zeigt, wie du sie erkennst: Lokale Stimmen schicken nichts ins Netz, „Google Deutsch“ und Stimmen mit „Online“ im Namen schon.
Stimmenklau und Schockanrufe: KI-Stimmen erkennen
Die Technik, die Texte vorliest, kann auch Stimmen fälschen. Das BSI nennt Text-to-Speech und Stimmumwandlung als die beiden Hauptmethoden und beschreibt typische Merkmale synthetischer Stimmen:
- ein metallischer Klang,
- falsche Aussprache, zum Beispiel englischer Wörter bei einer deutsch trainierten Stimme,
- eine monotone Sprechweise ohne natürliche Betonung,
- ein unpassender Sprechstil oder Akzent,
- seltsame Geräusche bei ungewöhnlichen Eingaben und
- Verzögerungen, bevor die Stimme antwortet.
Laut BSI braucht eine hochwertige Fälschung zwar mehrere Stunden Aufnahmen für das Training, mit Hilfe großer Datenbanken anderer Stimmen lässt sich das aber auf wenige Minuten verkürzen. Die Verbraucherzentrale Brandenburg warnte im Januar 2026, dass Betrügern schon kurze Sprachfragmente etwa aus sozialen Netzwerken reichen, um eine Stimme nachzuahmen. Ihr Rat bei einem Schockanruf: Gespräch beenden und die Person unter einer bekannten Nummer selbst zurückrufen. Die Verbraucherzentrale Bremen empfiehlt zusätzlich, mit nahestehenden Menschen ein geheimes Codewort zu vereinbaren. In Österreich gibt das Portal onlinesicherheit.gv.at Tipps, KI-Inhalte zu erkennen.
Welche TTS-Lösung passt zu dir?
- Du willst nur zuhören: Nimm die eingebauten Stimmen von Windows, Mac, iPhone, Android oder Browser. Wie das geht, steht in Text vorlesen lassen.
- Dein Text ist vertraulich: Nimm eine lokale Stimme, also eine Windows-Stimme, eine natürliche Stimme der Sprachausgabe nach dem Herunterladen oder ein Open-Source-Programm wie Piper.
- Du machst Videos: Cloud-Stimmen oder KI-Stimmen klingen am natürlichsten. Denk an die Kennzeichnung und daran, dass Untertitel oft die bessere Ergänzung sind; wie das mit Untertiteldateien geht, zeigt der Ratgeber SRT-Datei öffnen, erstellen und übersetzen.
- Du entwickelst für das Web: Die Web Speech API des Browsers reicht für einfache Fälle. Warte auf
voiceschanged, bevor du die Stimmenliste ausliest, setzelangkorrekt und nutze SSML, wenn du einen Cloud-Dienst verwendest. - Du willst eine Sprache vergleichen: Hör dir denselben Satz mit Datum, Betrag und Abkürzung in mehreren Stimmen an. So hörst du schneller als mit jeder Liste, welche Stimme Deutsch wirklich kann.
