La synthèse vocale, en anglais text-to-speech ou TTS, est la technologie qui transforme un texte écrit en parole : un logiciel lit le texte avec une voix artificielle. C'est elle qui fait parler le GPS, les lecteurs d'écran, la fonction de lecture à voix haute de votre navigateur et bien des vidéos. Votre ordinateur et votre téléphone en sont déjà équipés. Voici à quoi elle sert, comment elle fonctionne, quelles voix françaises nous avons trouvées sur notre propre PC et pourquoi les dates, les montants et les liaisons lui donnent du fil à retordre.
La synthèse vocale, c'est quoi ?
Synthèse vocale, synthèse de la parole, text-to-speech, TTS : ces termes désignent tous la conversion d'un texte écrit en voix. Microsoft parle dans sa documentation française de « conversion de texte par synthèse vocale », et Google intitule la page d'aide Android correspondante « Sortie de la synthèse vocale ». L'opération inverse, qui transforme la parole en texte, s'appelle la reconnaissance vocale (speech-to-text) ; nous la traitons dans notre guide pour transcrire un fichier audio.
Trois notions voisines sont souvent confondues avec la synthèse vocale :
- Le lecteur d'écran : une application comme le Narrateur de Windows, VoiceOver chez Apple ou TalkBack sur Android. Elle lit tout ce qui s'affiche et permet aux personnes aveugles de se déplacer dans l'interface. Elle utilise une voix de synthèse, mais elle fait bien plus que lire.
- La lecture à voix haute : la fonction qui lit un article ou un passage sélectionné, par exemple dans un navigateur ou une liseuse.
- L'assistant vocal : il comprend d'abord votre question grâce à la reconnaissance vocale, puis répond avec une voix de synthèse.
À quoi sert la synthèse vocale ?
- Accessibilité : les lecteurs d'écran lisent l'écran aux personnes aveugles ou malvoyantes, et la lecture à voix haute aide tous ceux qui préfèrent écouter plutôt que lire.
- Lecture de textes : navigateurs, liseuses et téléphones lisent des articles et des documents ; les étapes appareil par appareil sont dans notre guide pour lire un texte à voix haute.
- Guidage et annonces : indications du GPS, messages automatiques, serveurs vocaux des services clients.
- Vidéos : de nombreux tutoriels et publicités sont dits par une voix de synthèse, et le doublage par IA s'en sert pour faire parler une traduction (voir qu'est-ce que le doublage).
- Assistants vocaux : chaque réponse parlée est de la parole synthétisée.
- Streaming : sur Twitch, des outils comme Streamlabs lisent à l'antenne le message d'un spectateur qui envoie un pourboire ou des Bits. Le streamer fixe un montant minimum, choisit la voix et peut filtrer le spam et les grossièretés.
Comment fonctionne la synthèse vocale ?
La norme du W3C pour le balisage de la synthèse vocale, SSML, décrit le chemin du texte au son en six étapes. Prenons la phrase « Le 25/10/2026, M. Dupont règle 1 234,56 €. » :
- Lecture du balisage : si le texte contient des instructions SSML, le moteur les lit d'abord.
- Analyse de la structure : repérer les paragraphes et les phrases pour placer les pauses.
- Normalisation du texte :
25/10/2026devient « vingt-cinq octobre deux mille vingt-six »,M.devient « monsieur » et le montant devient « mille deux cent trente-quatre euros cinquante-six ». C'est l'étape la plus fragile : la norme reconnaît elle-même que, face à des formes ambiguës, deux moteurs peuvent lire le même texte différemment. - Conversion en phonèmes : chaque mot reçoit sa prononciation, liaisons comprises.
- Prosodie : intonation, rythme, pauses et accentuation.
- Production du son : le signal audio est généré.
Pendant longtemps, les moteurs assemblaient de petits morceaux de voix enregistrés par un locuteur, ou calculaient la voix à partir d'un modèle statistique. DeepMind décrivait la première méthode comme difficile à modifier sans enregistrer une nouvelle base complète, et la seconde comme moins naturelle. En 2016, son réseau de neurones WaveNet a montré qu'on pouvait générer directement l'onde sonore. En 2017, Tacotron 2 a combiné un réseau qui calcule un spectrogramme à partir du texte et une variante de WaveNet qui en fait du son. Microsoft écrit aujourd'hui que ses voix neuronales sont presque impossibles à distinguer d'enregistrements humains.
L'idée est bien plus ancienne que l'informatique. Wolfgang von Kempelen décrivait déjà en 1791 une machine parlante actionnée par un soufflet ; le Deutsches Museum de Munich en conserve un exemplaire considéré comme le plus ancien de son genre. Il faut attendre 1939 et le Voder de Homer Dudley pour entendre une voix produite électroniquement. Sur les téléphones, Android a intégré un moteur de synthèse vocale dès la version 1.6, en 2009, avec le français parmi les cinq premières langues ; le code source d'Android contient d'ailleurs les fichiers de langue français du moteur Pico, développé par la société zurichoise SVOX.
Notre test : les voix françaises de notre PC
Les voix disponibles dépendent de l'appareil. Sur notre PC de test, sous Windows 11 réglé en turc, nous avons relevé les voix que Chrome et Edge proposent aux pages web, et celles que Windows avait installées.
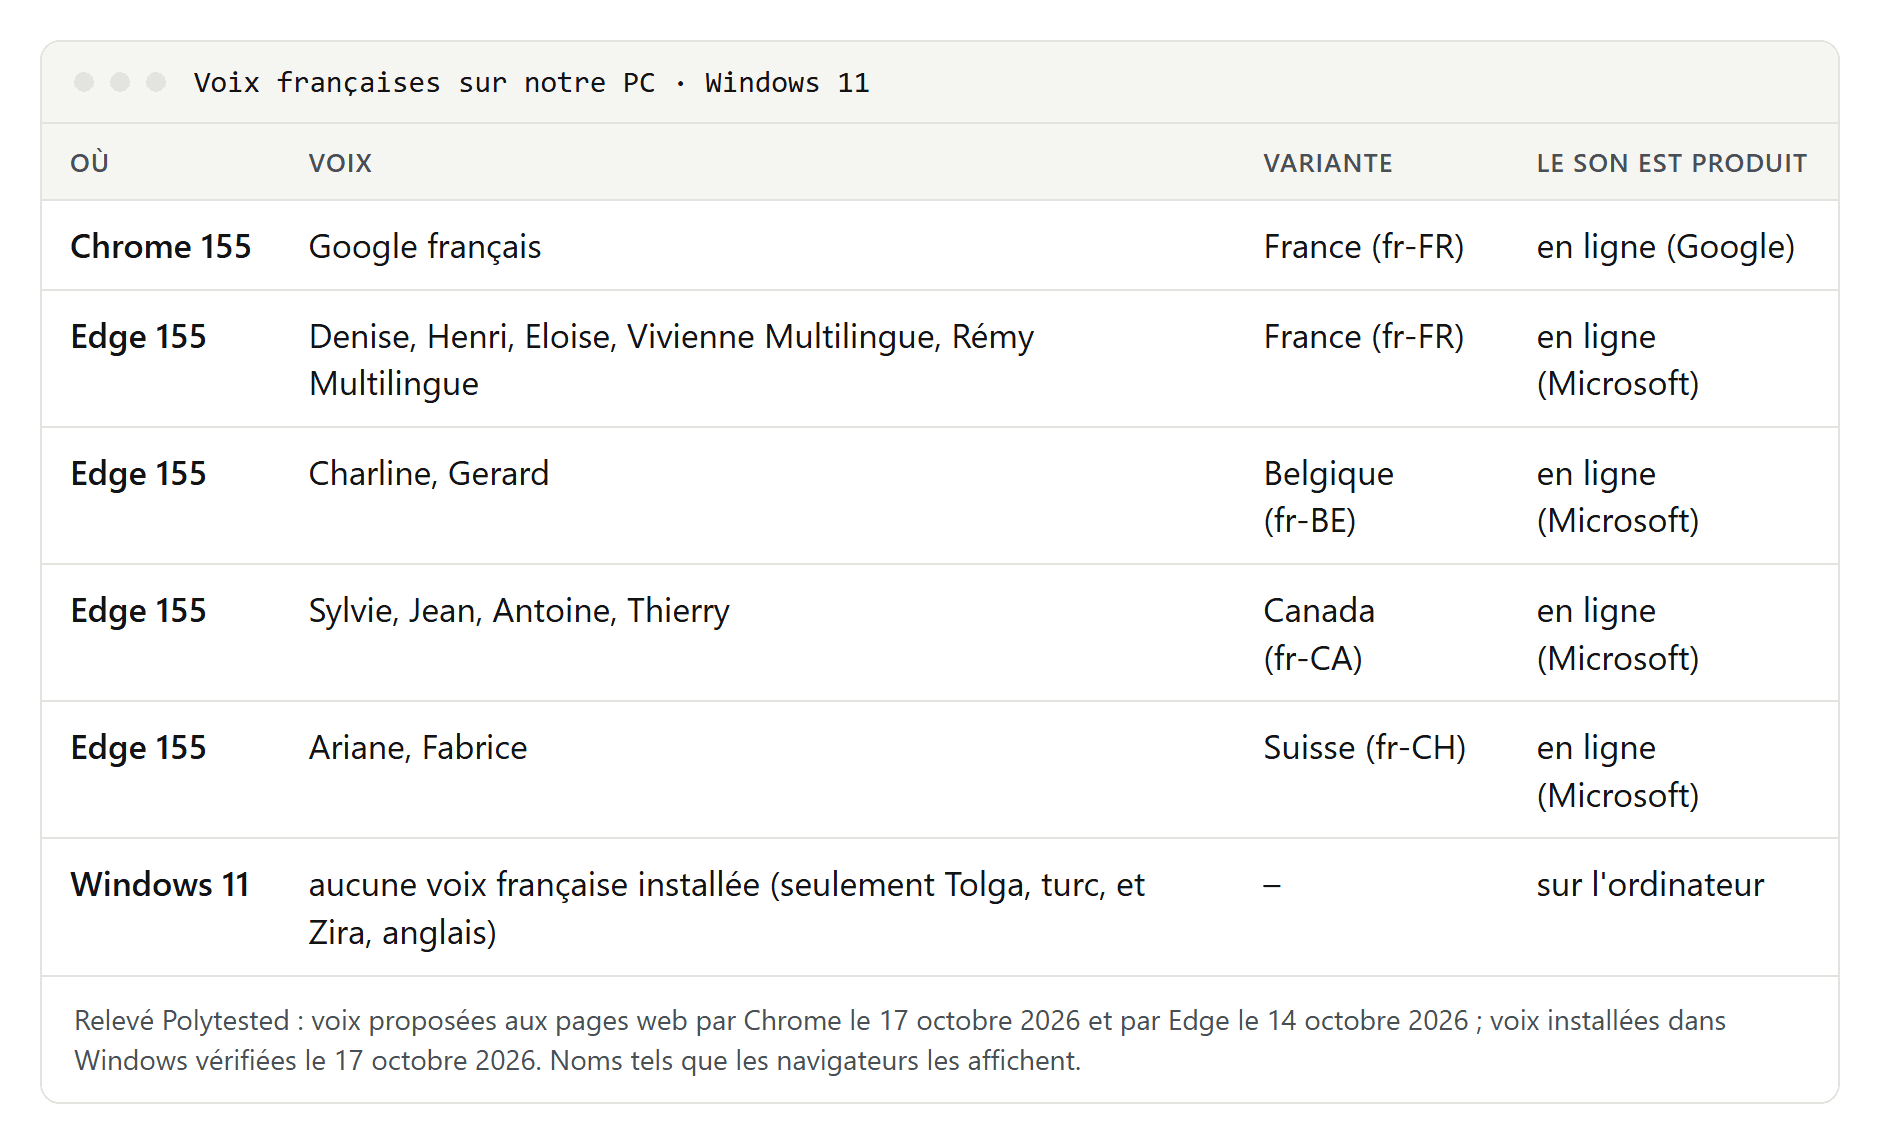
- Chrome 155 proposait 20 voix le 17 octobre 2026 : 19 voix Google en ligne, dont « Google français », et une seule voix de Windows, Microsoft Tolga (turc).
- Edge 155 en proposait 322 le 14 octobre : 321 voix en ligne de Microsoft, plus Tolga. Treize sont françaises : cinq pour la France, dont deux « Multilingue », deux pour la Belgique, quatre pour le Canada et deux pour la Suisse.
- Windows n'avait aucune voix française. Il tient deux listes de voix : l'ancienne contenait seulement Microsoft Zira (anglais américain), la nouvelle seulement Tolga.
Zira n'apparaît dans aucun navigateur. L'explication se trouve dans le code source de Chromium, la base de Chrome et d'Edge : sous Windows, le navigateur lit d'abord la nouvelle liste de voix et ne se rabat sur l'ancienne qu'en cas d'échec. Autre détail utile si vous programmez : les voix en ligne arrivent tout de suite, la voix de Windows un instant plus tard. Dans notre relevé du 17 octobre, la première notification comptait 19 voix, la seconde 20. Attendez donc l'événement voiceschanged avant de lire la liste.
Voix locale ou voix en ligne : où part votre texte ?
Chaque voix d'un navigateur est soit locale, calculée sur votre appareil, soit en ligne, produite par un service sur Internet. Selon MDN, la propriété localService indique de quel type elle est, et une voix en ligne peut entraîner un délai, du trafic ou des coûts supplémentaires. Nous avons regardé, dans le journal réseau du navigateur, ce que cela signifie pour votre texte (essai du 14 octobre 2026, avec une phrase allemande) :
- Chrome avec une voix Google : Chrome a envoyé la phrase entière dans l'adresse d'une requête vers google.com. Nous avons fait l'essai avec « Google Deutsch » ; d'après le code source de Chromium, « Google français » fait partie de la même extension et emprunte le même chemin.
- Edge avec une voix « Online (Natural) » : Edge a ouvert une connexion vers un serveur de Microsoft. Microsoft indique que, pour les voix dont le nom contient « Online », le texte part chiffré avec un jeton aléatoire, puis que le texte et l'audio sont supprimés juste après la conversion.
- Voix locale de Windows : aucune requête. Selon Microsoft, rien n'est envoyé avec une voix locale.
Les voix naturelles du Narrateur, dont des voix françaises, fonctionnent elles aussi sur l'appareil : selon Microsoft, une fois téléchargées, elles marchent sans connexion Internet. Notre conseil : pour un contrat, des données de santé ou les données personnelles d'autres personnes, choisissez une voix locale.
Les voix françaises de Windows, du Mac, de l'iPhone et d'Android
- Windows : Microsoft liste pour le français les voix Paul, Hortense et Julie (France), Claude et Caroline (Canada) et Guillaume (Suisse), plus deux voix naturelles pour le Narrateur, Henri et Denise. Ouvrez les paramètres du Narrateur avec la touche Windows + Ctrl + N, choisissez « Ajouter des voix héritées », puis « Ajouter des voix » sous « Gérer les voix ». Les voix naturelles s'installent avec le bouton « Ajouter » de la section « Ajouter des voix naturelles ».
- Mac : menu Pomme > Réglages Système > Accessibilité > « Lire et énoncer », menu « Voix système ». Une nouvelle voix se télécharge depuis Apple, avec une connexion Internet ; Apple précise que les voix n'existent pas dans toutes les langues.
- iPhone et iPad : Réglages > Accessibilité > « Lire et énoncer » > Voix, où vous choisissez une voix et un dialecte. Selon Apple, les voix de qualité premium peuvent peser 100 Mo ou plus et se téléchargent en Wi-Fi. La même page propose « Détecter les langues » et « Prononciations », qui permet de dicter ou d'épeler la prononciation de certains mots. La « voix personnelle », qui crée une copie synthétique de votre propre voix, n'existe pas en français : Apple la limite à l'anglais (États-Unis), au mandarin (Chine continentale) et à l'espagnol (Mexique).
- Android : Paramètres > Accessibilité > « Sortie de la synthèse vocale ». Vous y choisissez le moteur (celui de Google, celui du fabricant ou un moteur installé depuis le Play Store), la langue, la cadence et le ton. « Installer les données vocales » ajoute d'autres langues.
Les voix françaises dans le cloud et en open source
Pour des vidéos, un site ou une application, on passe souvent par un service cloud. Nous laissons les prix de côté ; les noms viennent de la documentation des éditeurs :
- Microsoft : les voix « Online » d'Edge viennent de son service cloud, qui couvre selon Microsoft plus de 100 langues et variantes régionales. Les voix françaises que nous avons trouvées figurent dans le tableau ci-dessus.
- Amazon Polly : Ambre, Céline, Florian, Léa, Mathieu et Rémi pour la France, Isabelle pour la Belgique, Chantal, Gabrielle et Liam pour le Canada. La liste ne contient pas de voix suisse.
- Piper : un moteur open source qui fonctionne entièrement sur votre ordinateur. Sa liste compte six voix françaises (gilles, mls, mls_1840, siwis, tom et upmc), toutes pour la France.
La qualité des grandes voix IA, comme celles d'ElevenLabs, en français, en allemand et en espagnol fera l'objet de nos propres tests.
Dates, montants, abréviations : là où la voix trébuche
Un lecteur humain comprend tout de suite 25/10/2026 ou 1 234,56 €. Une voix doit d'abord deviner de quoi il s'agit, et les conventions changent d'un pays à l'autre. Les formats par défaut de la base Unicode CLDR, que de nombreux logiciels utilisent, le montrent bien (notre requête du 17 octobre 2026, CLDR 46) :
| Variante | 25 octobre 2026 | Le nombre 1234,56 |
|---|---|---|
| France (fr-FR) | 25/10/2026 | 1 234,56 |
| Belgique (fr-BE) | 25/10/2026 | 1 234,56 |
| Suisse (fr-CH) | 25.10.2026 | 1 234,56 |
| Canada (fr-CA) | 2026-10-25 | 1 234,56 |
| États-Unis (en-US) | 10/25/2026 | 1,234.56 |
S'y ajoutent les abréviations (M., Mme, p. ex., n°), les ordinaux (1er, 2e), les siècles en chiffres romains (XXIe siècle) et les nombres régionaux : en Belgique et en Suisse, 70 se dit « septante », d'après le Larousse. Pour ces publics, préférez une voix fr-BE ou fr-CH et vérifiez à l'écoute.
Notre test avec une phrase allemande truffée de ces pièges (14 et 15 octobre 2026) montre ce qui se passe avec une voix d'une autre langue. Les voix allemandes en ligne de Microsoft ont traité la date, le montant 1.234,56 € et les abréviations comme autant de blocs uniques. La voix anglaise Zira a coupé le montant au point et à la virgule, comme un nombre anglais ; la voix turque Tolga a découpé la date en sept morceaux et le montant en huit. Ces découpages montrent comment la voix a lu le texte, pas si la prononciation est juste ; pour cela, il faut une oreille humaine. La règle reste simple : un texte français se fait lire par une voix française.
Liaisons, homographes et anglicismes : les pièges du français
Même une bonne voix française bute sur des difficultés propres à la langue :
- Les liaisons : on lie « les amis », mais pas « les héros », à cause du h aspiré. La voix doit connaître ces exceptions mot par mot.
- Les homographes : dans « Les poules du couvent couvent », le même mot se prononce de deux façons. « Fils », « est » ou « président » posent le même problème : la voix doit deviner le sens d'après le contexte.
- Les anglicismes et les noms propres : « meeting », « streaming » ou un nom de marque au milieu d'une phrase française. Microsoft indique que ses voix multilingues reconnaissent elles-mêmes la langue du texte, et l'iPhone propose « Détecter les langues ».
Sur un site web, marquez les passages dans une autre langue avec l'attribut lang, pour que les lecteurs d'écran appliquent les bonnes règles de prononciation. Les règles d'accessibilité WCAG en dispensent les noms propres, les termes techniques et les mots entrés dans l'usage courant.
SSML : dire à la voix comment lire
Si vous programmez une synthèse vocale ou utilisez un service cloud, le langage SSML permet de préciser la lecture de certains passages. Les services de Google, d'Amazon et de Microsoft le prennent en charge, chacun avec ses propres limites. Les éléments principaux de la norme du W3C :
<speak version="1.1" xmlns="http://www.w3.org/2001/10/synthesis" xml:lang="fr-FR">
  Rendez-vous le <say-as interpret-as="date" format="dmy">25/10/2026</say-as>
  avec <sub alias="Monsieur">M.</sub> Dupont.
  Les poules <phoneme alphabet="ipa" ph="kuv">couvent</phoneme>.
  Le <lang xml:lang="en-US">meeting</lang> commence à l'heure.
</speak>say-asavecformat="dmy"indique que la date se lit jour, mois, année.subremplace une abréviation par le texte à prononcer.phonemeimpose une prononciation en alphabet phonétique, ici celle du verbe.langsignale un passage dans une autre langue.
La norme rappelle que deux moteurs peuvent interpréter le même document différemment : testez avec la voix que vous utiliserez vraiment. Cet exemple suit la documentation du W3C ; nous ne l'avons pas testé sur un service cloud.
Voix de synthèse : ce que dit le règlement européen sur l'IA
Depuis le 2 août 2026, les obligations de transparence de l'article 50 du règlement européen sur l'IA s'appliquent. Ceci n'est pas un conseil juridique, mais les grandes lignes sont claires :
- Marquage par les fournisseurs : un système d'IA qui génère du son, des images, des vidéos ou du texte de synthèse doit marquer ses sorties dans un format lisible par machine. Pour les systèmes déjà sur le marché avant le 2 août 2026, une modification du règlement accorde un délai jusqu'au 2 décembre 2026.
- Hypertrucages : celui qui utilise une IA pour produire un hypertrucage (deepfake), en image, en son ou en vidéo, doit indiquer que le contenu a été généré ou manipulé par une IA. Le règlement entend par là un contenu qui ressemble à des personnes, des lieux ou des événements réels et pourrait passer à tort pour authentique. Pour une œuvre manifestement artistique, satirique ou de fiction, une mention adaptée qui ne gâche pas l'œuvre suffit.
- Ce que précisent les lignes directrices de la Commission : un usage purement personnel et non professionnel sort du champ du règlement. Les voix qui aident des personnes handicapées à communiquer n'ont pas à être marquées ; une parole réaliste avec la voix d'une personne précise, si.
- Sanctions : jusqu'à 15 millions d'euros ou 3 pour cent du chiffre d'affaires annuel mondial, le montant le plus élevé étant retenu.
En pratique : vous faire lire un texte pour vous-même n'est pas concerné. Si vous publiez une vidéo avec une voix IA, le marquage du fichier revient au fournisseur ; à vous de signaler la voix si, dans son contexte, elle peut passer pour celle d'une vraie personne. Dans le doute, signalez-la.
Voix clonées : comment repérer l'arnaque
La technique qui lit vos textes peut aussi imiter une voix. Le ministère de l'Intérieur explique, dans sa fiche « Ma Sécurité » mise à jour le 11 février 2026, que des escrocs récupèrent des enregistrements sur les réseaux sociaux pour fabriquer des messages qui semblent venir de vos proches. Ses conseils :
- en cas de demande sensible, vérifiez par un autre moyen et rappelez la personne sur un numéro que vous connaissez ;
- écoutez les nuances : une voix imitée manque parfois d'hésitations ou de variations naturelles du ton ;
- limitez ce que vous publiez sur votre vie privée et vos projets.
Une voix familière au téléphone ne prouve donc plus rien à elle seule. Raccrocher et rappeler reste le réflexe le plus sûr.
