Steht in der Search Console bei einer Seite „Duplikat“, hat Google sie einer anderen URL zugeordnet und nur eine davon indexiert. Das ist oft gewollt und manchmal ein echtes Canonical-Problem. Ob du handeln musst, zeigt dir das URL-Prüftool: Es nennt die kanonische URL, die deine Seite angibt, und die, die Google ausgewählt hat. Fast jedes echte Problem löst du gleich: Weiterleitung, Canonical-Tag, interne Links, Sitemap und hreflang nennen dieselbe URL, dann wartest du, bis Google neu crawlt. Unten: jeder Status, die häufigsten Ursachen, die Prüfungen und was unsere Website elf Tage nach einer URL-Änderung zeigte.
Die Status im Bericht zur Seitenindexierung
Im Bericht zur Seitenindexierung stehen die Canonical-Fälle in der Tabelle „Warum Seiten nicht indexiert werden“. Das klingt nach Fehler, ist aber meist keiner: Laut Google-Hilfe ist es im Allgemeinen ein gutes Zeichen, wenn eine Seite als doppelt oder alternativ gekennzeichnet ist, denn Google hat dann die kanonische Seite gefunden und indexiert. Google rät auch ausdrücklich davon ab, zu erwarten, dass alle URLs einer Website im Index landen; gemeint sind nur die kanonischen.
| Status | Bedeutung | Was tun? |
|---|---|---|
| Alternative Seite mit richtigem kanonischen Tag | Die Seite nennt eine andere URL als kanonisch, und Google hat diese indexiert | Nichts |
| Duplikat – vom Nutzer nicht als kanonisch festgelegt | Google hat Duplikate ohne Canonical gefunden und selbst eine URL gewählt | Nur wenn Googles Wahl falsch ist: Canonical setzen oder weiterleiten |
| Duplikat – Google hat eine andere Seite als der Nutzer als kanonische Seite bestimmt | Deine Seite nennt eine kanonische URL, Google hat aber eine andere indexiert | Beide URLs im URL-Prüftool vergleichen |
| Seite mit Weiterleitung | Die URL leitet weiter, indexiert werden kann nur das Ziel | Bei alten URLs nichts; prüfen, wenn die URL in Sitemap oder Links steht |
| Gecrawlt – zurzeit nicht indexiert | Google hat die Seite abgerufen und vorerst nicht indexiert | Kein Canonical-Problem: Seite verbessern oder lassen |
In manchen Anleitungen steht der dritte Status mit leicht anderem Wortlaut („… eine andere kanonische Seite als der Nutzer ausgewählt“). Gemeint ist dieselbe Meldung; wir verwenden die Namen aus der deutschen Hilfe.
Zwei Punkte übersieht man leicht. Sprachversionen erkennt die Search Console nicht als Alternativen: Eine Übersetzung erscheint nie unter „Alternative Seite mit richtigem kanonischen Tag“. Und „Gecrawlt – zurzeit nicht indexiert“ ist kein Canonical-Status, auch wenn er in derselben Tabelle steht. Wie du den Bericht überhaupt öffnest und liest, zeigt unser Leitfaden zur Google Search Console. Was der Tag selbst tut, steht in unserem Artikel zum Canonical-Tag.
So liest du das Ergebnis der URL-Prüfung
Gib die vollständige URL oben in die Suchleiste der Search Console ein und schau dir das indexierte Ergebnis an, nicht den Live-Test. Im Abschnitt „Seitenindexierung“ zählen drei Zeilen: „Letztes Crawling“, „Vom Nutzer angegebene kanonische URL“ (was deine Seite sagt) und „Von Google ausgewählte kanonische URL“ (was Google indexiert hat). Fast jeder Fall passt in eines von vier Mustern:
- Beide Angaben sind gleich. Kein Canonical-Problem. Ist die Seite trotzdem nicht indexiert, liegt der Grund woanders.
- Google wählt eine andere Schreibweise derselben Adresse, etwa mit http, www oder Schrägstrich am Ende. Deine Website antwortet unter mehreren Adressen; irgendwo passen Weiterleitung und Tag nicht zusammen.
- Google wählt eine URL, die inzwischen weiterleitet, typisch nach einem Relaunch. Vergleiche das Datum des letzten Crawlings mit dem Datum deiner Änderung: War Google seitdem nicht mehr da, kennt es die Weiterleitung noch nicht.
- Google wählt eine andere Seite mit ähnlichem Inhalt. Entweder sind die Seiten zu ähnlich, oder dein Canonical zeigt auf eine Seite, die gar kein Duplikat ist. Die Google-Hilfe ist hier deutlich: Ähnelt die angegebene kanonische URL der Seite nicht, wählt Google sie nie aus.
Drei Grenzen des Tools: „Live-URL testen“ prüft die Canonical-Auswahl gar nicht; die von Google ausgewählte kanonische URL kann ein paar Stunden hinter dem Index liegen; und Prüfungen wie auch „Indexierung beantragen“ sind pro Property und Tag begrenzt.
Dazu kommt ein Effekt im Leistungsbericht: Klicks, Impressionen und Positionen werden der kanonischen URL zugeordnet. Solange Google eine alte URL als kanonisch führt, erscheinen ihre Zahlen unter der alten Adresse, obwohl jeder Besucher auf der neuen landet.
Häufige Ursachen und was hilft
| Ursache | Woran du es erkennst | Lösung |
|---|---|---|
| http und https antworten beide | Googles kanonische URL beginnt mit http | Dauerhafte Weiterleitung auf https; Canonical, Sitemap und hreflang mit https |
| Mit und ohne www | Dieselbe Seite unter zwei Hosts | Einen Host wählen, den anderen weiterleiten |
| Schrägstrich am Ende, Großbuchstaben | /seite, /seite/ und /Seite zählen als drei URLs | Auf eine Schreibweise weiterleiten und nur diese verlinken |
| Umlaute im Slug | /über-uns und /ueber-uns sind zwei verschiedene URLs | Eine Variante festlegen, die andere weiterleiten; Umlaute in Links prozentcodiert schreiben |
| Tracking-, Sortier- und Filterparameter | Viele Einträge „Alternative Seite …“ oder „Duplikat – vom Nutzer nicht als kanonisch festgelegt“ | Canonical auf die saubere URL; noindex für Filterseiten, die nie in die Suche sollen |
| Temporäre Weiterleitung (302, 307) oder Kette | Die alte URL bleibt länger kanonisch | Ein dauerhafter Sprung (301 oder 308) direkt zum Ziel |
| Canonical zeigt auf Weiterleitung, 404 oder noindex | Google ignoriert dein Canonical womöglich | Auf die endgültige URL zeigen, die 200 liefert und indexiert werden darf |
| Signale widersprechen sich | Sitemap nennt URL A, der Tag URL B, die Links URL C | Überall dieselbe URL |
| Übersetzung zeigt per Canonical auf Englisch | Deutsche Seiten fehlen im Index | Jede Sprache nennt sich selbst, hreflang verbindet |
| Slug- oder Domainwechsel | Die alte URL ist weiter Googles kanonische URL | Weiterleitung lassen, alle Signale umstellen, Crawling abwarten |
| Fast gleiche Seiten | Google fasst Seiten zusammen, die für dich verschieden sind | Inhalt klar unterscheiden oder Seiten zusammenlegen |
| Fehler im CMS oder Plug-in, gehackte Website | Canonical oder Weiterleitung auf eine unerwartete, auch fremde URL | HTML und Serverantwort prüfen, CMS-Fehler beim Anbieter melden |
Google empfiehlt laut seiner Dokumentation außerdem: Weiterleitungen und Canonical-Tags sind starke Signale, die Sitemap ein schwaches, und gemeinsam wirken sie stärker. Nenne nie in der Sitemap eine andere URL als im Tag. Nimm weder robots.txt noch noindex, um eine kanonische Seite festzulegen: Eine per robots.txt gesperrte URL kann trotzdem ohne Inhalt im Index landen, und noindex blockiert die Seite ganz. Bei Groß- und Kleinschreibung ist Google streng: /APPLE und /apple sind für Google zwei URLs. Und https wird als kanonisch bevorzugt, außer das Zertifikat ist ungültig, die https-Seite leitet auf http weiter oder ihr Canonical nennt die http-Version.
Eine URL mit curl prüfen
Das URL-Prüftool zeigt, was Google entschieden hat. curl zeigt, was dein Server tatsächlich sendet, ohne Browser-Cache. Prüfe Statuscode, Canonical-Tag, ein mögliches noindex und die hreflang-Links. Hier die ersten beiden Prüfungen an einer unserer alten Adressen, mit den Antworten unseres Servers vom 25. Oktober 2026:
# 1. Wohin führt die alte Adresse, mit welchem Status?
curl -sI https://polytested.com/blog/meeting-minutes
HTTP/1.1 308 Permanent Redirect
Location: /blog/how-to-write-meeting-minutes-template-example

# 2. Welche kanonische URL nennt die neue Seite?
curl -s https://polytested.com/blog/how-to-write-meeting-minutes-template-example | grep -o '<link rel="canonical"[^>]*>'
<link rel="canonical" href="https://polytested.com/blog/how-to-write-meeting-minutes-template-example"/>

# 3. Steht irgendwo noindex, im HTML oder im Header?
curl -s https://example.com/seite | grep -io '<meta name="robots"[^>]*>'
curl -sI https://example.com/seite | grep -i x-robots-tag
Die Befehle laufen im Terminal von macOS und Linux; unter Windows fehlt grep, dort nimmst du am einfachsten WSL oder Git Bash. Wiederhole dann die erste Prüfung mit http, www, Schrägstrich am Ende, Großbuchstaben und einem Tracking-Parameter. Bei uns brauchte die alte Adresse mit http, www oder Schrägstrich zwei dauerhafte Sprünge bis zur neuen URL, mit Großbuchstaben einen; die neue URL mit ?utm_source=newsletter antwortete mit 200 und nannte die saubere URL als kanonisch. Googles Crawler folgen bis zu 10 Weiterleitungen, zwei Sprünge funktionieren also, einer ist sauberer. Wie du ganze Ketten und URL-Listen testest, steht in unserer Checkliste zum Website-Relaunch.
Die ganze Website mit einem Crawler prüfen
curl prüft eine URL, ein Crawler folgt allen internen Links und zeigt Muster. Achte auf:
- indexierbare Seiten, deren Canonical eine andere URL nennt;
- Canonical-Ziele, die weiterleiten, einen Fehler liefern oder noindex tragen;
- interne Links auf Weiterleitungen statt auf die endgültige URL;
- Sitemap-Einträge, die weiterleiten oder nicht kanonisch sind;
- hreflang-Links, die auf eine andere URL zeigen als das Canonical der Zielseite.
Die Website-Prüfung (Site Audit) von Semrush meldet laut ihrer englischsprachigen Wissensdatenbank unter anderem defekte Canonical-Links, Seiten mit mehreren Canonical-URLs, Weiterleitungsketten und -schleifen, temporäre Weiterleitungen, Konflikte zwischen hreflang und Canonical sowie Sitemaps mit weitergeleiteten oder nicht kanonischen URLs (Stand 25. Oktober 2026). Als Duplikate zählt sie Seiten, deren Inhalt zu 85 Prozent identisch ist.
Als wir unsere eigene Website am 25. Oktober 2026 gecrawlt haben, antworteten alle 277 erreichten URLs mit 200, kein interner Link führte auf eine Weiterleitung, und jede der 227 indexierbaren Seiten nannte sich selbst als kanonisch. Trotzdem hatten drei unserer URLs an diesem Tag ein Canonical-Problem in der Search Console. Ein Crawler prüft, was du sendest, nicht, was Google entschieden hat.
Unser Fall: Google hielt an den alten URLs fest
Am 14. Oktober 2026, einen Tag nachdem die Website für Suchmaschinen geöffnet wurde, bekamen unsere neun deutschen Anleitungen längere, sprechende Slugs, und am selben Tag folgten die 25 englischen. Jede alte Adresse leitet mit 308 weiter. Am 25. Oktober haben wir jede URL unserer Sitemaps im URL-Prüftool abgefragt und mit dem Leistungsbericht vom 12. bis 25. Oktober verglichen.
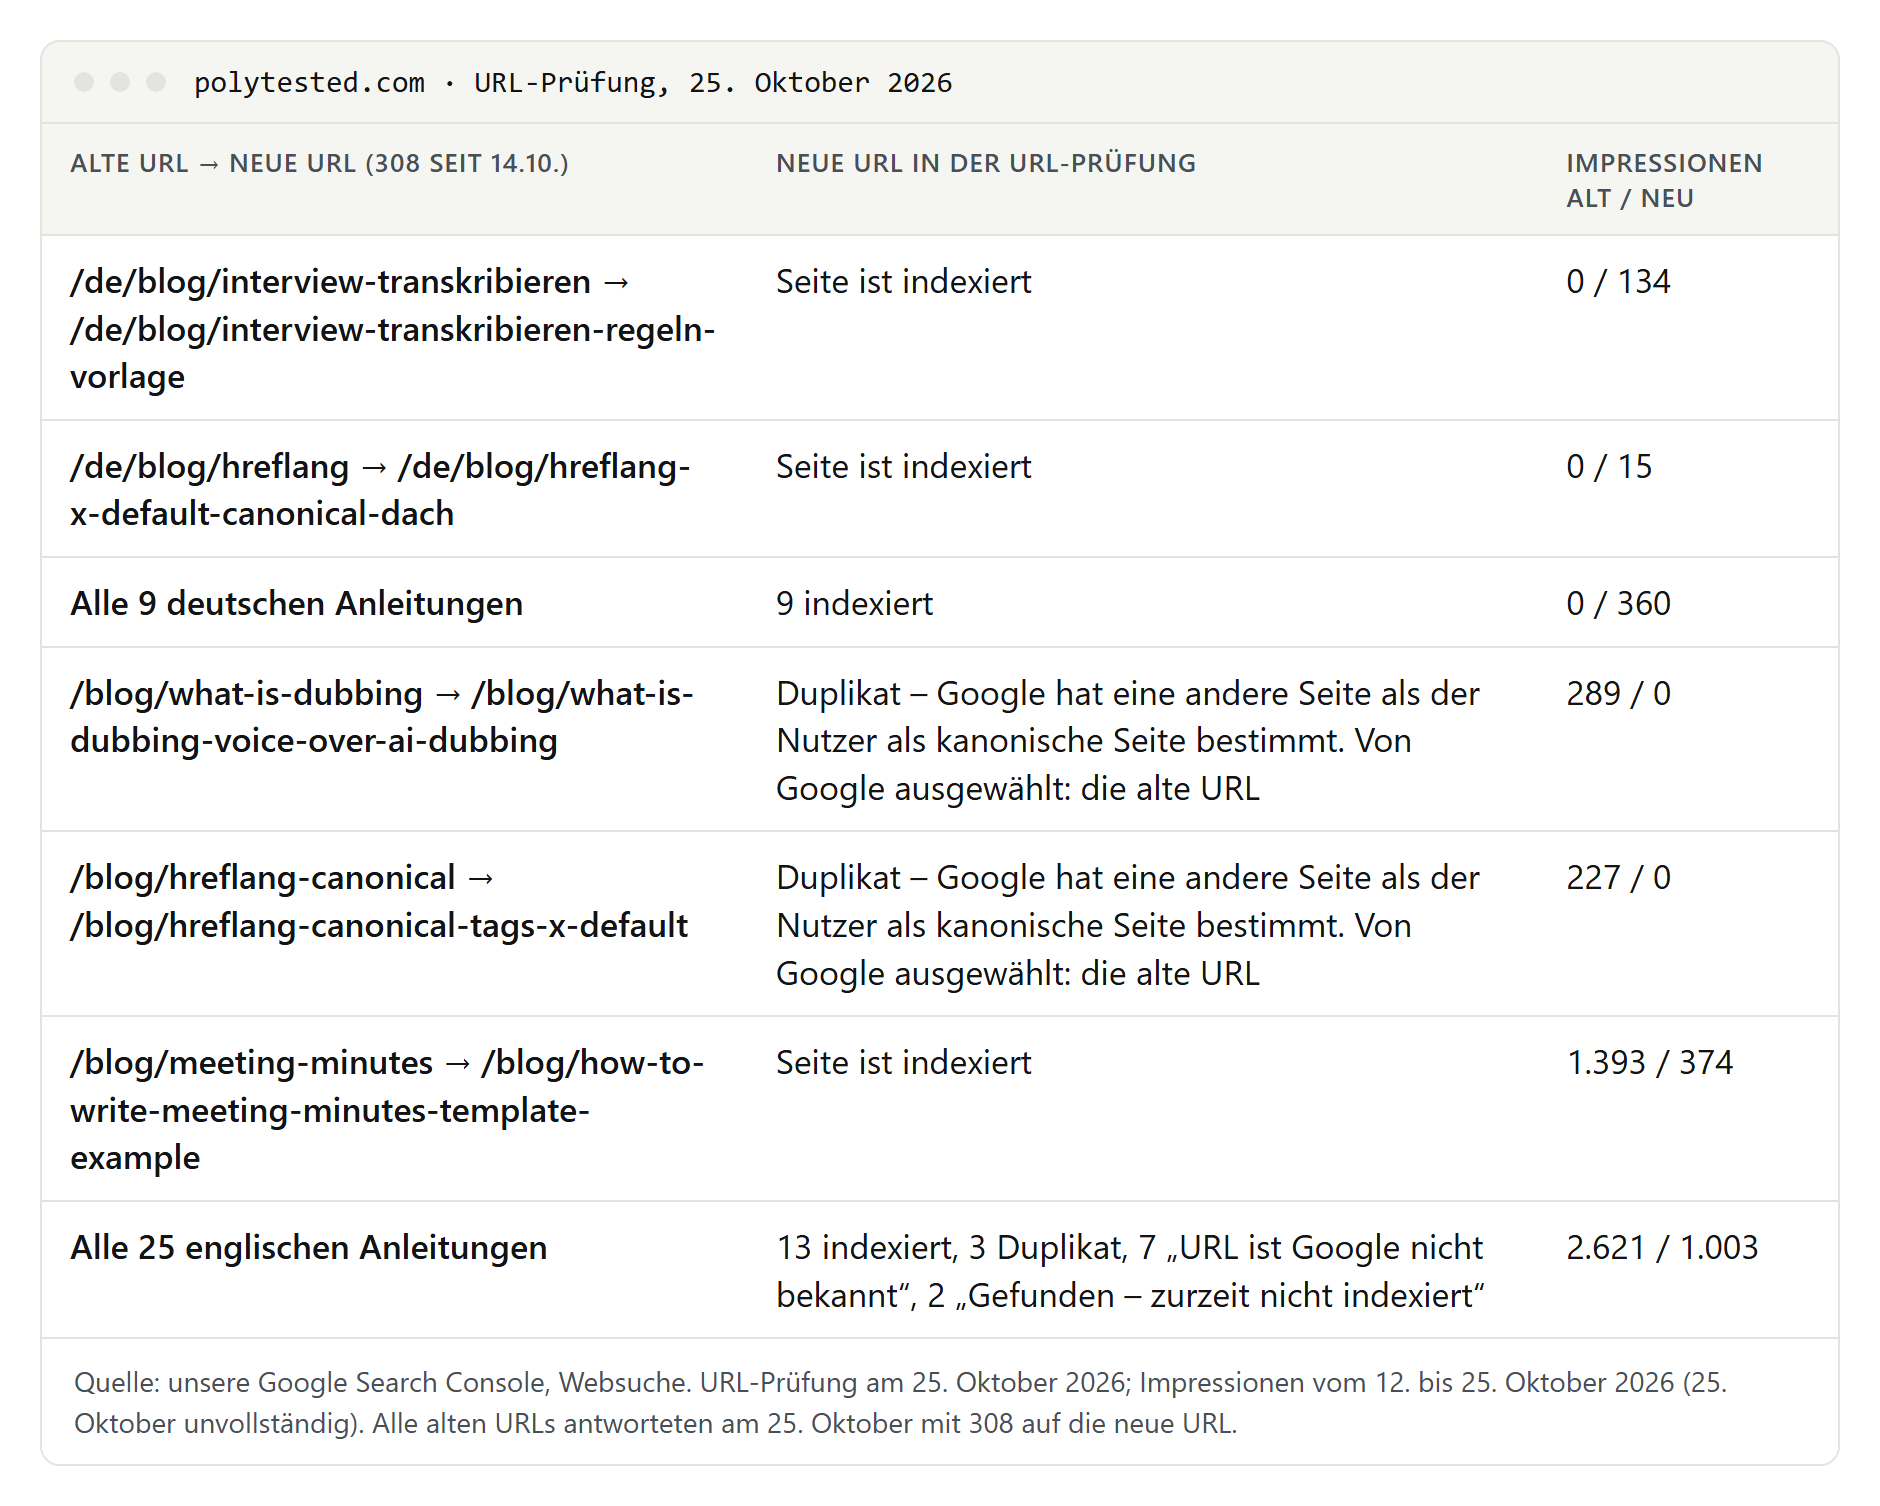
- Die deutschen Anleitungen sind sauber umgezogen. Alle neun neuen URLs waren indexiert, die alten hatten keine einzige Impression.
- Drei englische URLs standen auf „Duplikat – Google hat eine andere Seite als der Nutzer als kanonische Seite bestimmt“. Bei allen drei war die von Google ausgewählte kanonische URL die alte Adresse, die seit elf Tagen weiterleitete. Google hatte die neuen URLs zuletzt am 15. und 16. Oktober gecrawlt, die meisten alten am 13. bis 15. Oktober, also vor oder kurz nach der Änderung.
- Von den 25 neuen englischen URLs waren 13 indexiert, 7 Google noch nicht bekannt, 2 gefunden, aber nicht gecrawlt, und 3 die genannten Duplikate.
- Die Impressionen blieben bei den alten URLs. Von 4.075 Impressionen auf englischen Seiten zählte Google 2.621 (64 Prozent) auf den alten, kurzen Adressen. Das passt zur Regel, dass die Daten der kanonischen URL zugeordnet werden.
- Alles, was wir senden, zeigt auf die neuen URLs. Am 25. Oktober antworteten alle 35 alten Adressen mit 308 auf die richtige Seite, jede neue Seite nannte sich selbst als kanonisch, und alle hreflang-Links in den vier Sprachen führten auf Seiten mit Status 200.
Der Duplikat-Status ist hier also kein Konfigurationsfehler, sondern die Verzögerung, die Google für umgezogene Seiten beschreibt: Jede alte URL wird verarbeitet, wenn sie erneut gecrawlt wird. Dazu passt der Unterschied zwischen den Sprachen: Die alten deutschen Adressen kannte Google kaum, viele alte englische hatte es schon indexiert. Eine weitere Seite in unseren Sitemaps, /fr/cookies, stand auf „Gecrawlt – zurzeit nicht indexiert“, mit sich selbst als von Google ausgewählter kanonischer URL, während die Cookie-Seiten der drei anderen Sprachen indexiert waren. Kein Canonical-Problem, und eine Cookie-Richtlinie muss nicht ranken.
Die Grenzen dieser Daten: Die Website ist neu, der Zeitraum kurz, Positionen sind Durchschnittswerte. Viele Impressionen kamen von weit hinten; die alte englische Protokoll-Anleitung etwa lag im Schnitt auf Position 81, wohin kaum jemand scrollt.
Was du nach einer URL-Änderung tun solltest
- Lass die dauerhaften Weiterleitungen stehen. Wer sie entfernt oder das Canonical zurück auf die alte URL setzt, sendet widersprüchliche Signale.
- Stell alle Signale gleichzeitig um: Canonical-Tags, interne Links, Sitemap und die hreflang-Links in allen anderen Sprachen.
- Hilf Google, die alten URLs erneut zu besuchen. Googles Anleitung zum Website-Umzug schlägt vor, eine Sitemap mit den alten URLs neben der neuen einzureichen; dann siehst du, wie ihre Zahl indexierter Seiten sinkt. Warnungen wegen Weiterleitungen in dieser Sitemap sind normal. Wir haben am 25. Oktober 2026 eine vorübergehende Sitemap mit unseren 35 weitergeleiteten Adressen in unseren Sitemap-Index aufgenommen. Ob sie etwas beschleunigt, können wir noch nicht sagen. Mehr zum Format in unserem Artikel zur XML-Sitemap.
- Beantrage die Indexierung nur für wenige wichtige neue URLs; die Funktion ist pro Tag begrenzt.
- „Fehlerbehebung überprüfen“ ist optional. Google aktualisiert die Zahlen ohnehin, sobald es die Seiten crawlt. Eine Überprüfung dauert laut Hilfe in der Regel etwa zwei Wochen.
- Rechne in Wochen. Laut Google brauchen die meisten Seiten einer kleinen oder mittelgroßen Website einige Wochen für den Umzug, und nach einer inhaltlichen Korrektur können Seiten bis zu zwei Wochen in einer Duplikatgruppe bleiben.
Canonical und hreflang auf mehrsprachigen Websites
Eine Übersetzung ist kein Duplikat. Jede Sprachversion nennt sich selbst als kanonisch, hreflang verbindet die Versionen, und Google verlangt eine kanonische Seite in derselben Sprache. Sind aber nur Menü und Fußzeile übersetzt und der Haupttext bleibt englisch, behandelt Google die Seiten als Duplikate.
Für Websites in Deutschland, Österreich und der Schweiz kommt oft eine Länderfrage dazu: Gleiche deutsche Texte unter /de-de/, /de-at/ und /de-ch/ sind für Google Duplikate. Google rät in diesem Fall, Canonical und hreflang zusammen einzusetzen, damit die passende Länderversion erscheint. Zwei häufige Fehler: Übersetzungen, deren Canonical auf die englische Seite zeigt, sodass Google womöglich nur die englische Version indexiert, und hreflang-Links, die nach einem Slug-Wechsel in einer Sprache noch auf alte URLs zeigen. Als sich unsere englischen Slugs änderten, mussten auch die deutschen, französischen und spanischen Seiten auf die neuen englischen URLs verlinken. Mehr dazu in unseren Leitfäden zu hreflang, x-default und Canonical und zu internationalem SEO.
Reihenfolge für die Fehlerbehebung
- URLs finden: im Bericht zur Seitenindexierung die Zeile jedes Canonical-Status öffnen.
- Einige Beispiele im URL-Prüftool ansehen und den vier Mustern oben zuordnen.
- Mit curl prüfen, was der Server sendet: Status, Canonical, noindex, hreflang.
- Die Website crawlen: Canonicals, interne Links und Sitemap-Einträge, die auf Weiterleitungen oder Fehler zeigen.
- Alle Signale auf dieselbe endgültige URL setzen, überflüssige URLs weiterleiten.
- Für die wichtigsten URLs die Indexierung beantragen, dann einige Wochen warten, bevor du urteilst.
- „Alternative Seite mit richtigem kanonischen Tag“ und erwartete „Seite mit Weiterleitung“ in Ruhe lassen.
