L'automatisation intelligente, c'est un processus automatisé qui suit des règles fixes et confie à l'IA les seules étapes qui demandent de comprendre : lire un e-mail, extraire les données d'une facture, classer une demande. IBM parle aussi d'automatisation cognitive. Dans une petite entreprise, cela se résume le plus souvent à une étape d'IA dans n8n, Make ou Zapier. Nous expliquons les termes, montrons où partent les données et ce que demandent le RGPD et l'AI Act. Nous avons aussi testé le filtre de données personnelles de n8n : sur 34 valeurs inventées, il n'en a remplacé que 9 entièrement.
L'automatisation intelligente en une phrase
Sur sa page en français, IBM définit l'automatisation intelligente, « parfois appelée automatisation cognitive », comme l'utilisation de l'intelligence artificielle, de la gestion des processus métier (BPM) et de l'automatisation robotisée des processus (RPA) pour rationaliser la prise de décision en entreprise.
Pour une petite équipe, le partage des rôles est simple : les règles font ce qui est prévisible, l'IA fait ce que les règles ne savent pas faire. Une règle sait enregistrer une pièce jointe ; elle ne comprend pas si une cliente demande un remboursement ou signale un colis abîmé. C'est là que se place l'étape d'IA, et elle doit répondre en champs nommés (« catégorie », « numéro de commande », « urgent : oui ou non ») plutôt qu'en paragraphe : une règle peut vérifier un champ, pas un texte libre.
Selon l'Insee, en 2025, 18 pour cent des entreprises françaises de 10 salariés ou plus utilisaient au moins une technologie d'IA (20 pour cent dans l'Union européenne), mais 15 pour cent seulement entre 10 et 49 salariés. Parmi celles qui ne s'en servent pas, 71 pour cent disent ne pas en voir l'utilité.
RPA, IPA, agents, hyperautomatisation : les termes
| Terme | Ce qu'il désigne | Qui fixe les étapes |
|---|---|---|
| Automatisation des workflows | Des étapes fixes entre applications, via leurs API, lancées par un déclencheur | Vous, à l'avance |
| RPA | Des robots logiciels qui répètent des tâches de bureau, parfois en cliquant dans l'interface | Vous, à l'avance |
| Automatisation intelligente (IPA quand il s'agit de RPA) | L'une des deux, plus une IA pour les textes libres et les décisions simples | Vous ; l'IA traite une ou deux étapes |
| Agent d'IA | Un modèle de langage qui choisit lui-même ses outils et l'ordre des étapes | Le modèle |
| Hyperautomatisation | Une stratégie : automatiser tout ce qui peut l'être, avec plusieurs outils | Ce n'est pas un outil |
Ce tableau est notre résumé ; aucune source ne trace exactement ces frontières. La différence qui compte est celle entre processus et agent. Selon Anthropic, dans un workflow, modèles et outils suivent des chemins définis à l'avance ; dans un agent, le modèle dirige lui-même le déroulement. Anthropic conseille la solution la plus simple : un agent coûte plus cher et ses erreurs peuvent s'enchaîner. Dans n8n, le nœud « AI Agent » relie un modèle à au moins un outil, et l'agent décide lequel appeler. Make conseille de ne confier à un agent que ce que l'on confierait à un stagiaire. Et Gartner prévoyait en juin 2025 l'abandon de plus de 40 pour cent des projets d'IA agentique d'ici fin 2027. Pour commencer, un processus fixe avec une étape d'IA suffit.
Un exemple : la boîte de réception d'une petite boutique en ligne
- Déclencheur (règle) : un e-mail arrive au service client.
- Classement (IA) : livraison, retour, facture ou autre.
- Extraction (IA) : le numéro de commande, dans un champ à part.
- Contrôle (règle) : format du numéro vérifié, état de la commande récupéré dans la boutique ; en cas de doute, l'e-mail part chez un humain.
- Brouillon (IA) : une réponse rédigée à partir de l'état de la commande et de vos pages d'aide.
- Validation (humain) : quelqu'un relit, par exemple dans Slack.
- Envoi (règle) : seulement après validation.
Seules les étapes 2, 3 et 5 sont « intelligentes » ; la validation évite qu'une réponse fausse parte chez une cliente. Envoyez à l'IA le texte de l'e-mail, pas tout le dossier client. Ce texte contient pourtant souvent des données personnelles : notre test montre ce qu'un filtre peut y faire. Le même schéma transforme une transcription en compte rendu de réunion ou résume une retranscription d'entretien.
Ce que montrent 13 300 modèles de n8n
Le 13 octobre 2026, nous avons relevé les fiches des 13 300 modèles de la bibliothèque publique de n8n et compté les nœuds d'IA.
| Ce que nous avons compté | Modèles |
|---|---|
| Au moins une étape d'IA | 7 113 |
| Avec le nœud AI Agent | 4 232 |
| Avec de l'IA, sans agent | 2 881 |
| Avec le nœud Structured Output Parser | 2 140 |
| Avec le nœud Guardrails | 24 |
| Parmi les 100 plus consultés : avec IA | 80 |
| Parmi les 100 plus consultés : avec agent | 50 |
Les agents dominent, mais 2 881 modèles placent l'IA dans un processus sans agent. Après « AI Agent » et le modèle de chat d'OpenAI, le nœud d'IA le plus fréquent est le « Structured Output Parser », qui fait répondre le modèle en champs définis par un schéma JSON. Le nœud « Guardrails », que nous avons testé, n'apparaît que dans 24 modèles, tous ajoutés depuis novembre 2025. Un modèle reste un exemple, pas un workflow en production. Plus de chiffres dans notre guide n8n, c'est quoi ?.
Les étapes d'IA dans n8n, Make et Zapier
n8n n'existe qu'en anglais. Ses nœuds « Text Classifier » et « Information Extractor » classent un texte ou en tirent des champs. Le modèle se choisit avec un nœud de modèle de chat : le paquet que nous avons testé en contient 20, dont deux pour des modèles installés sur votre propre machine, comme « Ollama Chat Model ». Avant qu'un agent exécute un outil, le workflow peut s'arrêter et demander une validation, par exemple dans Slack : « Approve » ou « Deny ». Le nœud « Guardrails » en mode « Sanitize Text » remplace adresses web, clés secrètes ou données personnelles par des balises.
Make regroupe ses modules dans le « Make AI Toolkit » : « Extract information from text », « Categorize text », « Translate text », « Summarize text »… Le modèle passe par le fournisseur intégré de Make, ouvert à tous les plans, ou par votre propre connexion, réservée aux plans payants. « Make AI Agent (New) » est en bêta ouverte depuis le 2 février 2026, sans validation intégrée : Make conseille de donner à l'agent un outil qui vous envoie le résultat pour relecture. Si vous avez connu Make sous le nom d'Integromat, voyez ce qu'est devenu Integromat.
Zapier appelle son étape d'IA « AI by Zapier ». Selon son aide du 1er octobre 2026, il y fait migrer ses agents autonomes, avec pour chaque outil un interrupteur « Require approval before running » ; une exécution qui dépasse sa limite de tâches, 75 par défaut, se met en pause. Zapier n'existe qu'en anglais.
Où vont les données d'une étape d'IA
Il y a deux lieux : celui où la plateforme stocke vos données, et celui où le modèle les traite.
- n8n : n8n Cloud tourne sur Microsoft Azure, actuellement dans l'Union européenne ; auto-hébergé, il garde les données chez vous. C'est le nœud de modèle choisi qui décide où part le texte.
- Make : vous choisissez un centre de données aux États-Unis ou dans l'Union à la création de l'organisation, sans retour possible. Mais selon Make, une zone européenne ne garantit pas un traitement européen de l'IA : Maia, « Make AI Web Search » et tous les modèles d'OpenAI via le fournisseur de Make passent par les États-Unis. Dans son tableau de 29 modèles, nous en avons compté 10 traités dans des régions européennes pour un compte en zone européenne, dont Londres et Zurich, hors Union, et 19 aux États-Unis. Avec votre propre connexion, le traitement dans l'Union n'est garanti que pour 3 types de fournisseurs sur 10.
- Zapier : hébergement chez Amazon Web Services aux États-Unis, sans option européenne ; Zapier est certifié au Data Privacy Framework UE–États-Unis. Sur ses 23 sous-traitants d'infrastructure (liste en vigueur au 23 octobre 2026), 22 sont uniquement aux États-Unis.
Retenez ceci : c'est le modèle et son fournisseur qui décident où vos données sont traitées, pas l'hébergement de la plateforme.
Notre test : le filtre de données personnelles de n8n
Comment nous avons testé : le 16 octobre 2026, nous avons exécuté localement le code du nœud Guardrails du paquet npm officiel de n8n, version 2.43.7, en mode « Sanitize Text », garde-fou « PII », type « All » (les 36 types prévus), avec les réglages d'un workflow. Ce contrôle n'utilise pas de modèle d'IA. Le test a été conçu pour la version allemande de ce guide : les 34 valeurs personnelles sont inventées aux formats allemand, autrichien et suisse. S'y ajoutaient 6 lignes commerciales sans donnée personnelle et 4 valeurs américaines de contrôle.
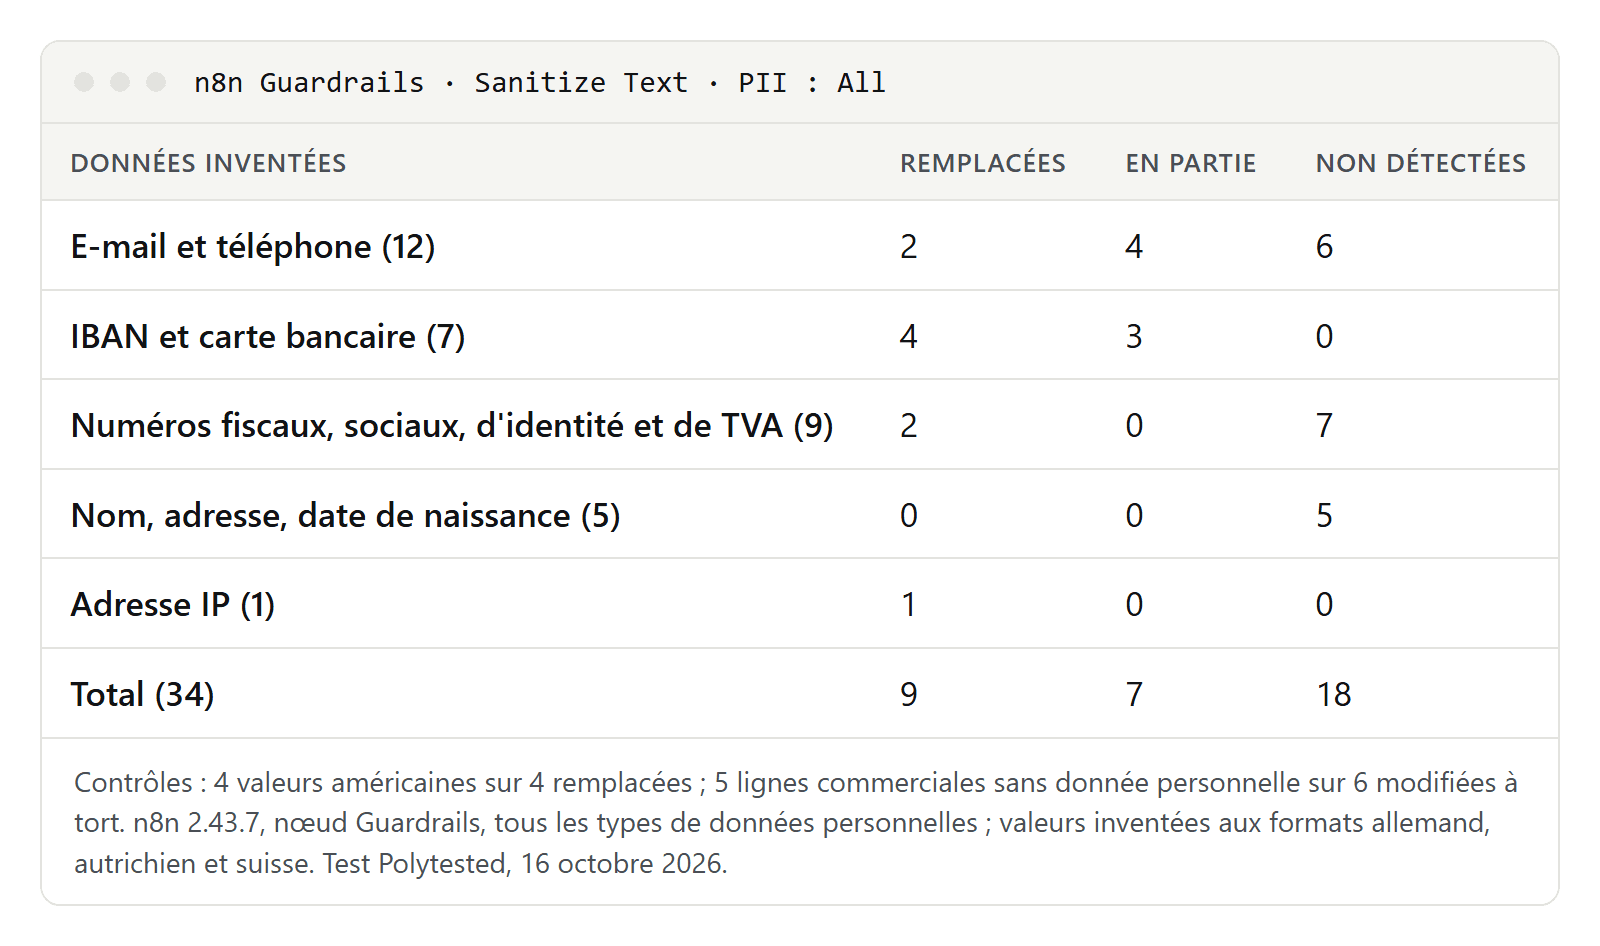
Résultat : 9 valeurs remplacées entièrement, 7 en partie, 18 pas du tout.
- E-mail et téléphone : seuls une adresse simple et un mobile sans espaces ont été remplacés ; tous les numéros écrits avec des espaces sont passés, sauf trois avec indicatif international, remplacés en partie.
- IBAN et carte : IBAN en un seul bloc et carte de test remplacés ; écrits par groupes de quatre, les IBAN ne l'ont été qu'en partie, le motif de carte bancaire attrapant les chiffres du milieu.
- Numéros fiscaux, sociaux, d'identité et de TVA : deux sur neuf, sous des étiquettes erronées (un code d'identité finlandais, un numéro d'étranger espagnol).
- Noms, adresses, dates de naissance : aucun. L'adresse IP a été remplacée.
Les 4 valeurs américaines ont toutes été remplacées, mais le filtre a modifié 5 des 6 lignes commerciales : un numéro client de 9 chiffres est devenu un numéro fiscal australien.
Pourquoi : le code compare seulement le texte à des motifs (expressions régulières). Sur les 36 types, 9 sont généraux, comme l'e-mail ou l'IBAN ; les 27 autres visent les États-Unis, l'Italie, l'Inde, l'Australie, le Royaume-Uni, l'Espagne, Singapour, la Pologne et la Finlande. Le téléphone suit le découpage américain, la date met le mois avant le jour, l'IBAN doit être d'un seul bloc. Avec quatre motifs ajoutés par nos soins via « Custom Regex », le filtre a remplacé 22 valeurs sur 34, mais a alors modifié les 6 lignes commerciales.
Et avec des données françaises ? Ce que dit le code
Nous n'avons pas refait le test avec des valeurs françaises, mais les motifs sont lisibles dans le code du nœud. Un mobile français compte 10 chiffres (Arcep), le NIR 13 chiffres et une clé de 2 (Insee).
| Donnée | Ce que prévoit le code | Résultat d'après le code |
|---|---|---|
Mobile écrit par paires, 06 XX XX XX XX | Blocs de 3, 3 et 4 chiffres | Aucun motif ne correspond |
Même numéro avec +33 | Idem | Aucun motif ne correspond |
| Mobile sans espaces | Même motif, espaces facultatifs | Reconnu |
| Date jj/mm/aaaa | Mois, jour, année | Reconnue si le jour va de 01 à 12 ; 25/10/2026 passe |
| NIR avec espaces | Aucun type français | Aucun motif ne correspond |
| NIR sans espaces | Suite de 8 à 17 chiffres | Reconnu, comme numéro bancaire américain |
| IBAN par groupes de quatre | Un seul bloc | En partie, comme dans notre test |
| Nom, adresse « rue » | Pas de type pour les noms ; lieux en mots anglais | Aucun motif ne correspond |
Les formats internationaux, eux, fonctionnent : e-mail simple, IBAN sans espaces, carte, adresse IP. Ce que nous en retenons : un tel filtre est un filet de sécurité, pas une garantie ; testez-le avec vos propres données inventées ; des motifs maison aident pour les numéros, pas pour un nom ou une adresse ; et le meilleur filtre reste de n'envoyer à l'IA que les champs nécessaires. Chez Zapier, la détection de données personnelles d'« AI Guardrails by Zapier » ne prend en charge que l'anglais et l'espagnol, selon son aide ; le Make AI Toolkit n'a pas de module de ce type.
RGPD : ce qu'il faut vérifier avant la première étape d'IA
Ceci n'est pas un conseil juridique. Pour déployer une IA générative, la CNIL recommande (juillet 2024) de partir d'un besoin précis, de lister les usages interdits, par exemple fournir des données personnelles au système ou lui confier une décision, de préférer des systèmes locaux et sécurisés ou de vérifier si le prestataire réutilise les données, et de former les utilisateurs. Le règlement ajoute :
- Sous-traitant (article 28) : le prestataire doit présenter des garanties suffisantes, et un contrat fixe notamment l'objet, la durée, la finalité et le type de données.
- Minimisation (article 5) : des données adéquates, pertinentes et limitées au nécessaire.
- Transferts (articles 44 et suivants) : pour les États-Unis, une décision d'adéquation du 10 juillet 2023 couvre les organisations certifiées au Data Privacy Framework ; le 3 septembre 2025, le Tribunal de l'Union européenne a rejeté le recours en annulation d'un citoyen français, Philippe Latombe.
- Analyse d'impact (article 35) : seulement si un risque élevé est probable.
- Décision automatisée (article 22) : chacun a le droit de ne pas faire l'objet d'une décision fondée exclusivement sur un traitement automatisé produisant des effets juridiques le concernant ou l'affectant de manière significative de façon similaire.
Côté sécurité, l'ANSSI, avec des experts de la CNIL et d'autres organismes publics, décrit l'injection indirecte de prompt (février 2025) : des instructions malveillantes glissées dans des sources externes contrôlées par un attaquant. Un e-mail entrant en est une. L'ANSSI recommande d'adapter l'autonomie du système au risque, d'intégrer une validation humaine dès que nécessaire et de limiter ses connexions aux autres systèmes. Une étape d'IA qui lit vos e-mails ne devrait donc pas pouvoir envoyer, payer ou supprimer sans règle ni validation.
En Suisse s'applique la loi fédérale sur la protection des données (LPD). Selon le Préposé fédéral (PFPDT), elle vaut directement pour l'IA : finalité, fonctionnement et sources de données doivent être transparents, une décision individuelle automatisée peut être soumise au contrôle d'un humain, et l'utilisateur d'un modèle de langage a le droit de savoir s'il écrit à une machine.
AI Act : ce qui s'applique à une petite équipe
Le règlement distingue le fournisseur, qui développe un système d'IA et le met sur le marché ou en service sous son propre nom, et le déployeur, qui utilise un système d'IA sous sa propre autorité, hors usage personnel. Une équipe qui utilise une étape d'IA dans n8n, Make ou Zapier est en général déployeur ; avec son propre chatbot sous son nom, elle peut aussi être fournisseur.
L'Omnibus numérique sur l'IA, règlement (UE) 2026/1744, est entré en vigueur le 27 juillet 2026 et a déplacé plusieurs échéances ; beaucoup de présentations affichent encore les anciennes dates.
| Date | Ce qui s'applique |
|---|---|
| 2 février 2025 | Pratiques interdites, maîtrise de l'IA (article 4) |
| 2 août 2026 | La plupart des règles, dont la transparence (article 50) ; début des contrôles |
| 2 décembre 2026 | Nouvelles interdictions ajoutées par l'Omnibus |
| 2 décembre 2027 | Haut risque de l'annexe III, dont le tri des candidatures |
| 2 août 2028 | Haut risque de l'annexe I |
- Maîtrise de l'IA (article 4) : fournisseurs et déployeurs prennent des mesures pour favoriser la maîtrise de l'IA de leur personnel, sans devoir garantir un niveau donné pour chaque personne, précise le texte modifié. Notez qui a été formé, et comment.
- Transparence (article 50) : le fournisseur veille à ce qu'une personne sache qu'elle échange avec une IA, sauf si c'est évident. Le déployeur signale les hypertrucages et les textes générés par IA publiés pour informer le public sur des questions d'intérêt public, sauf contrôle éditorial humain sous la responsabilité d'une personne.
- Émotions : la définition vise la reconnaissance fondée sur des données biométriques ; analyser le ton d'un e-mail n'en relève pas, selon notre lecture.
- Recrutement : analyser et filtrer des candidatures ou évaluer des candidats relève du haut risque à partir du 2 décembre 2027, et l'article 22 du RGPD limite déjà les décisions entièrement automatisées. Make cite pourtant un agent de présélection parmi ses exemples, tout en conseillant de tenir les agents à l'écart des décisions lourdes. Ne laissez pas une IA évaluer des personnes avant d'avoir clarifié vos obligations.
En France, la CNIL indiquait dans son programme de travail du 7 avril 2026 se préparer à être désignée autorité de surveillance du marché pour ce règlement. Une entreprise suisse peut aussi être concernée : l'AI Act vise les fournisseurs et déployeurs établis hors de l'Union quand les sorties du système sont utilisées dans l'Union. Ceci n'est pas un conseil juridique.
Par où commencer
- Choisissez un seul processus aux entrées désordonnées, traité à la main chaque semaine.
- Construisez-le d'abord sans IA, puis ajoutez une étape d'IA avec des champs nommés en sortie.
- N'envoyez que les données nécessaires, et testez votre filtre avec des données inventées dans vos formats : téléphones par paires, dates, NIR.
- Mettez un verrou avant la sortie : règle ou validation humaine avant tout envoi, paiement ou suppression.
- Vérifiez le prestataire : modèle, région, contrat de sous-traitance, réutilisation des données.
- Notez la formation de l'équipe et les règles d'usage de l'IA.
Faites ensuite tourner le processus quelques semaines en comptant les corrections. Un agent ne devient une option sérieuse qu'après.
