Intelligente Automatisierung heißt: Ein Ablauf folgt festen Regeln, und eine KI übernimmt nur die Schritte, für die man Verständnis braucht, etwa eine E-Mail lesen, Angaben aus einer Rechnung ziehen oder eine Anfrage einer Kategorie zuordnen. IBM nennt das auch kognitive Automatisierung. In kleinen Teams ist das meist ein einzelner KI-Schritt in n8n, Make oder Zapier. Wir erklären die Begriffe von RPA bis KI-Agent, zeigen, wohin die Daten eines KI-Schritts gehen und was DSGVO und AI Act verlangen. Dazu haben wir den eingebauten Filter von n8n mit 34 erfundenen Personendaten aus Deutschland, Österreich und der Schweiz geprüft: Nur neun ersetzte er vollständig.
Intelligente Automatisierung in einem Satz
IBM definiert intelligente Automatisierung (IA) auf seiner deutschen Seite als Einsatz von künstlicher Intelligenz, Business Process Management (BPM) und Robotic Process Automation (RPA), um Entscheidungen in Unternehmen schneller und in größerem Umfang zu treffen.
Für ein kleines Team heißt das: Regeln erledigen, was vorhersehbar ist, die KI erledigt, was Regeln nicht können. Eine Regel kann einen Anhang speichern, versteht aber nicht, ob eine Kundin in einer frei formulierten E-Mail etwas zurückschicken will oder eine Rechnung reklamiert. Genau dort sitzt der KI-Schritt.
Ein Beispiel: Eine E-Mail kommt an, die KI gibt Kategorie und Bestellnummer als einzelne Felder zurück, und feste Regeln entscheiden, was damit passiert. Wichtig ist die Form der Antwort: Feste Felder wie „Kategorie“ oder „dringend: ja oder nein“ kannst du mit Regeln prüfen und weiterreichen, freien Text kaum.
Workflow-Automatisierung, RPA, IPA und Hyperautomatisierung
So grenzen wir die Begriffe ab:
- Workflow-Automatisierung: feste Schritte zwischen Apps, meist über deren Schnittstellen (APIs), gestartet durch einen Auslöser wie eine neue E-Mail. Hier haben n8n, Make und Zapier angefangen.
- RPA (Robotic Process Automation): IBM nennt sie auch „Softwarerobotertechnik“. Softwareroboter wiederholen Büroaufgaben, teils über die Oberfläche, so wie ein Mensch klickt und tippt. Deshalb funktionieren sie laut IBM auch bei Programmen ohne Schnittstelle.
- Intelligente Prozessautomatisierung (IPA): RPA, erweitert um maschinelles Lernen, Sprachverarbeitung und Bilderkennung. IBM fasst den Unterschied so: RPA erledigt Aufgaben, KI übernimmt das Denken und Lernen.
- KI-Agent oder agentische KI: Das Sprachmodell wählt selbst, welche Schritte und Werkzeuge es nutzt.
- Hyperautomatisierung: eine Strategie, keine Technik. IBM beschreibt sie als das Konzept, in einem Unternehmen alles zu automatisieren, was sich automatisieren lässt, mit KI, RPA und weiteren Werkzeugen zusammen.
Diese Einteilung ist unsere Zusammenfassung; keine einzelne Quelle zieht die Grenzen genau so. In deutschen Ratgebern gehen die Begriffe durcheinander: Eine Beratungsseite setzt intelligente Automatisierung mit Hyperautomatisierung gleich, ein RPA-Hersteller versteht darunter, das Automatisieren selbst zu automatisieren. Für die Praxis reicht eine Frage: Sind die Schritte fest, oder entscheidet die KI selbst, was als Nächstes passiert?
KI-Agenten und agentische KI: wenn die KI die Schritte wählt
Laut BSI beantworten KI-Agenten nicht nur Fragen, sondern erledigen Aufgaben weitgehend selbstständig in mehreren Schritten, ohne dass jemand jeden Schritt bestätigt. Dafür brauchen sie Zugriff auf Dateien, Apps und Dienste. Die Gesellschaft für Informatik (GI) greift im Februar 2026 eine Arbeitsdefinition des Entwicklers Simon Willison auf: Ein Agent ist ein Sprachmodell, das in einer Schleife Werkzeuge aufruft, um ein Ziel zu erreichen. n8n nennt die GI dabei einen wichtigen Zwischenschritt, der zur Laufzeitumgebung für agentische KI wurde.
Der KI-Anbieter Anthropic zieht die Grenze so: In Workflows laufen Sprachmodelle und Werkzeuge über festgelegte Wege, in Agenten steuern die Modelle Ablauf und Werkzeuge selbst. Anthropic rät zur einfachsten Lösung und warnt, dass Agenten mehr kosten und sich ihre Fehler aufschaukeln können.
Make gibt eine Faustregel in drei Stufen: ein Agent für Aufgaben mit flexiblem Urteil, etwa Support-Tickets einordnen; einzelne KI-Module für feste Logik mit KI-Inhalt, etwa übersetzen; normale Szenarien für feste Logik wie Bestellungen verarbeiten. Einem Agenten solle man nur Aufgaben geben, die man einem Praktikanten anvertrauen würde.
Gartner sagte im Juni 2025 voraus, dass bis Ende 2027 mehr als 40 Prozent der Projekte mit agentischer KI eingestellt werden, wegen Kosten, unklarem Nutzen oder fehlender Risikokontrollen. Das ist eine Prognose. Für die meisten kleinen Teams ist ein fester Ablauf mit einem KI-Schritt der bessere Anfang.
Wo Firmen in Deutschland, Österreich und der Schweiz stehen
- Deutschland: 2025 nutzten laut Statistischem Bundesamt 26 Prozent der Unternehmen mit mindestens zehn Beschäftigten KI, bei kleinen Firmen mit 10 bis 49 Beschäftigten 23 Prozent. Von den Firmen mit KI nutzten sie 27 Prozent zur „Automatisierung von Arbeitsabläufen / Entscheidungsfindung“, häufiger waren etwa Text Mining (52 Prozent) und Spracherkennung (42 Prozent). Weil seit 2025 der EU-Unternehmensbegriff gilt, sind Vergleiche mit früheren Jahren eingeschränkt.
- Österreich: Laut Statistik Austria nutzten im selben Jahr 30 Prozent der Unternehmen ab zehn Beschäftigten KI, im EU-Schnitt 20 Prozent. 77 Prozent der Unternehmen ohne KI hatten sie gar nicht in Erwägung gezogen. Wer sie erwogen und nicht weiterverfolgt hatte, nannte am häufigsten fehlendes Fachwissen (15 Prozent aller Unternehmen ohne KI), dann Datenschutzbedenken und rechtliche Unklarheiten (je 11 Prozent).
- Schweiz: Eine amtliche Statistik haben wir nicht gefunden. Das KMU-Portal des SECO fasst eine Umfrage von EY unter 604 Beschäftigten zusammen: 89 Prozent nutzen KI im Arbeitsalltag, 29 Prozent dürfen dafür ihr privates Konto verwenden, etwa bei ChatGPT.
Der letzte Punkt ist ein Datenschutzthema: Die deutsche Datenschutzkonferenz (DSK) rät in ihrer Orientierungshilfe, dass Arbeitgeber für die berufliche Nutzung eigene Geräte und Konten bereitstellen. Eine geplante Automatisierung ist eine gute Gelegenheit dafür.
Ein Beispiel: das Support-Postfach eines kleinen Onlineshops
So könnte ein Onlineshop seine Support-E-Mails mit KI vorbereiten:
- Auslöser (Regel): Eine neue E-Mail kommt im Support-Postfach an.
- Einordnen (KI): Ein KI-Schritt ordnet sie einer Kategorie zu: Lieferstatus, Rücksendung, Rechnung oder Sonstiges.
- Auslesen (KI): Ein zweiter KI-Schritt gibt die Bestellnummer als eigenes Feld zurück.
- Prüfen (Regel): Eine Regel prüft das Format der Nummer und holt den Bestellstatus aus dem Shopsystem. Passt etwas nicht, geht die E-Mail an einen Menschen.
- Entwurf (KI): Ein KI-Schritt schreibt aus Bestellstatus und Hilfeseiten einen Antwortentwurf.
- Freigabe (Mensch): Jemand aus dem Team prüft den Entwurf, etwa in Slack.
- Senden (Regel): Erst dann geht die Antwort hinaus.
Intelligent sind nur die Schritte 2, 3 und 5; die Freigabe verhindert, dass eine falsche KI-Antwort bei einer Kundin landet. Schick der KI nur den E-Mail-Text, nicht das ganze Kundenkonto. Persönliche Angaben stecken trotzdem oft im Text; was ein Filter dagegen ausrichtet, zeigt unser Test.
Nach demselben Muster entsteht aus dem Transkript einer Besprechung ein Entwurf mit Beschlüssen und Aufgaben im Format eines Besprechungsprotokolls, ein transkribiertes Interview wird zusammengefasst, oder die KI übersetzt Produkttexte und eine Muttersprachlerin prüft sie, wie in unserem Ratgeber zur SEO-Übersetzung beschrieben.
KI-Schritte in n8n
n8n bringt eigene KI-Nodes mit, alle mit englischen Namen, denn die Oberfläche gibt es nur auf Englisch:
- „Text Classifier“ ordnet Texte Kategorien zu, die du mit Namen und Beschreibung anlegst; mit „Allow Multiple Classes To Be True“ auch mehreren zugleich.
- „Information Extractor“ zieht strukturierte Angaben aus Text, nach Beschreibungen der Felder oder einem JSON-Beispiel.
- „Structured Output Parser“ sorgt dafür, dass ein Modell Felder nach einem JSON-Schema zurückgibt.
- „AI Agent“ verbindet ein Chat-Modell mit mindestens einem Werkzeug; der Agent entscheidet selbst, welches er aufruft.
Das Modell wählst du über einen Chat-Modell-Node. In der KI-Erweiterung des Pakets, das wir getestet haben, stecken 20 davon, zwei für Modelle auf dem eigenen Rechner, darunter „Ollama Chat Model“. Mit selbst gehostetem n8n und lokalem Modell können die Daten im eigenen Netz bleiben. In n8n Cloud gibt es außerdem Gateway Credits, ein Guthaben für KI-Modelle ohne eigenes Konto beim Anbieter; die Anfragen laufen dann über n8ns Konto.
Für heikle Aktionen gibt es eine menschliche Freigabe: Bevor der AI Agent ein bestimmtes Werkzeug ausführt, pausiert der Workflow und fragt etwa über Slack oder Telegram nach. „Approve“ führt das Werkzeug aus, „Deny“ bricht ab. n8n empfiehlt das für Aktionen, die sich nicht rückgängig machen lassen, etwa Daten löschen oder Nachrichten nach außen schicken.
Der Node „Guardrails“ prüft Texte. Im Modus „Check Text for Violations“ sucht er etwa nach Jailbreak-Versuchen; dafür braucht er ein Chat-Modell. Im Modus „Sanitize Text“ ersetzt er Webadressen, geheime Schlüssel, personenbezogene Daten oder eigene Muster durch Platzhalter. Wie gut das bei deutschen Daten klappt, zeigt unser Test. Lizenz, Selbsthosten und Sicherheitsmeldungen erklärt unser Ratgeber Was ist n8n?.
KI-Schritte in Make
Make bündelt seine KI-Funktionen im „Make AI Toolkit“, mit Modulen wie „Extract information from text“, „Categorize text“, „Translate text“, „Summarize text“, „Analyze sentiment“ und „Simple Text Prompt“. Für Dokumente, Rechnungen, Belege und Audiodateien gibt es den „AI Content Extractor“.
Das Modell kommt über Makes eingebauten KI-Anbieter („Make's AI Provider“), den alle Pläne nutzen können, oder über eine eigene Verbindung zu OpenAI, Anthropic und anderen, die nur in bezahlten Plänen geht. Für das Toolkit schreibt Make, es speichere deine Daten nicht und nutze sie nicht zum Training; die Interaktionen stehen laut derselben Seite 30 Tage in den Szenario-Protokollen. Abgerechnet wird in Credits, die die früheren Operations ersetzt haben; wer Make noch als Integromat kennt, findet die alten und neuen Begriffe in unserem Ratgeber was aus Integromat wurde.
Für Agenten gibt es „Make AI Agent (New)“, erschienen am 2. Februar 2026 als offene Beta. Ein Agent bekommt Anweisungen, Wissen in Form von Dateien und Werkzeuge: Module, ganze Szenarien, Werkzeuge von MCP-Servern oder andere Agenten.
Eine eingebaute Freigabe beschreibt Make nicht. Stattdessen rät Make, dem Agenten ein Werkzeug zu geben, das dir das Ergebnis zur Prüfung schickt, etwa einen Gmail-Entwurf in Slack, und ihn in den Anweisungen warten zu lassen. Außerdem solle er nur die Daten bekommen, die er braucht. Eine Spracheinstellung für die Oberfläche dokumentiert Makes Hilfe nicht.
KI-Schritte in Zapier
Bei Zapier heißt der KI-Schritt „AI by Zapier“; das Ergebnis kommt als Ausgabefelder zurück. Du wählst eine Modellstufe, „Standard“, „Advanced“ oder „Premium“, oder hinterlegst mit „Bring Your Own Key“ einen eigenen Schlüssel, etwa für OpenAI, Anthropic oder Google Gemini. Mit Werkzeugen und Wissen arbeitet der Schritt wie ein Agent.
Die bisherigen eigenständigen Agents überführt Zapier laut Hilfe vom 1. Oktober 2026 in AI by Zapier. Für jedes Werkzeug gibt es den Schalter „Require approval before running“; Zapier rät, ihn für schreibende Aktionen einzuschalten. Überschreitet ein Lauf sein Task-Limit, standardmäßig 75 und einstellbar bis 500, pausiert er zur Prüfung.
„AI Guardrails by Zapier“ prüft KI-Ausgaben unter anderem auf personenbezogene Daten und Angriffe über Prompts. Die Prüfung auf personenbezogene Daten unterstützt laut Zapier nur Englisch und Spanisch, und zwei Hilfeseiten vom selben Tag widersprechen sich darin, ob Zapier die geprüften Daten speichert.
Zapier gibt es nur auf Englisch. Welche Pläne den KI-Schritt in welchem Umfang enthalten, prüfst du vor dem Start am besten auf Zapiers aktueller Preisseite.
Wo die Daten liegen und wohin KI-Anfragen gehen
Bei KI-Schritten gibt es zwei Orte: wo die Plattform deine Daten speichert, und wo das KI-Modell sie verarbeitet. Das ist oft nicht derselbe.
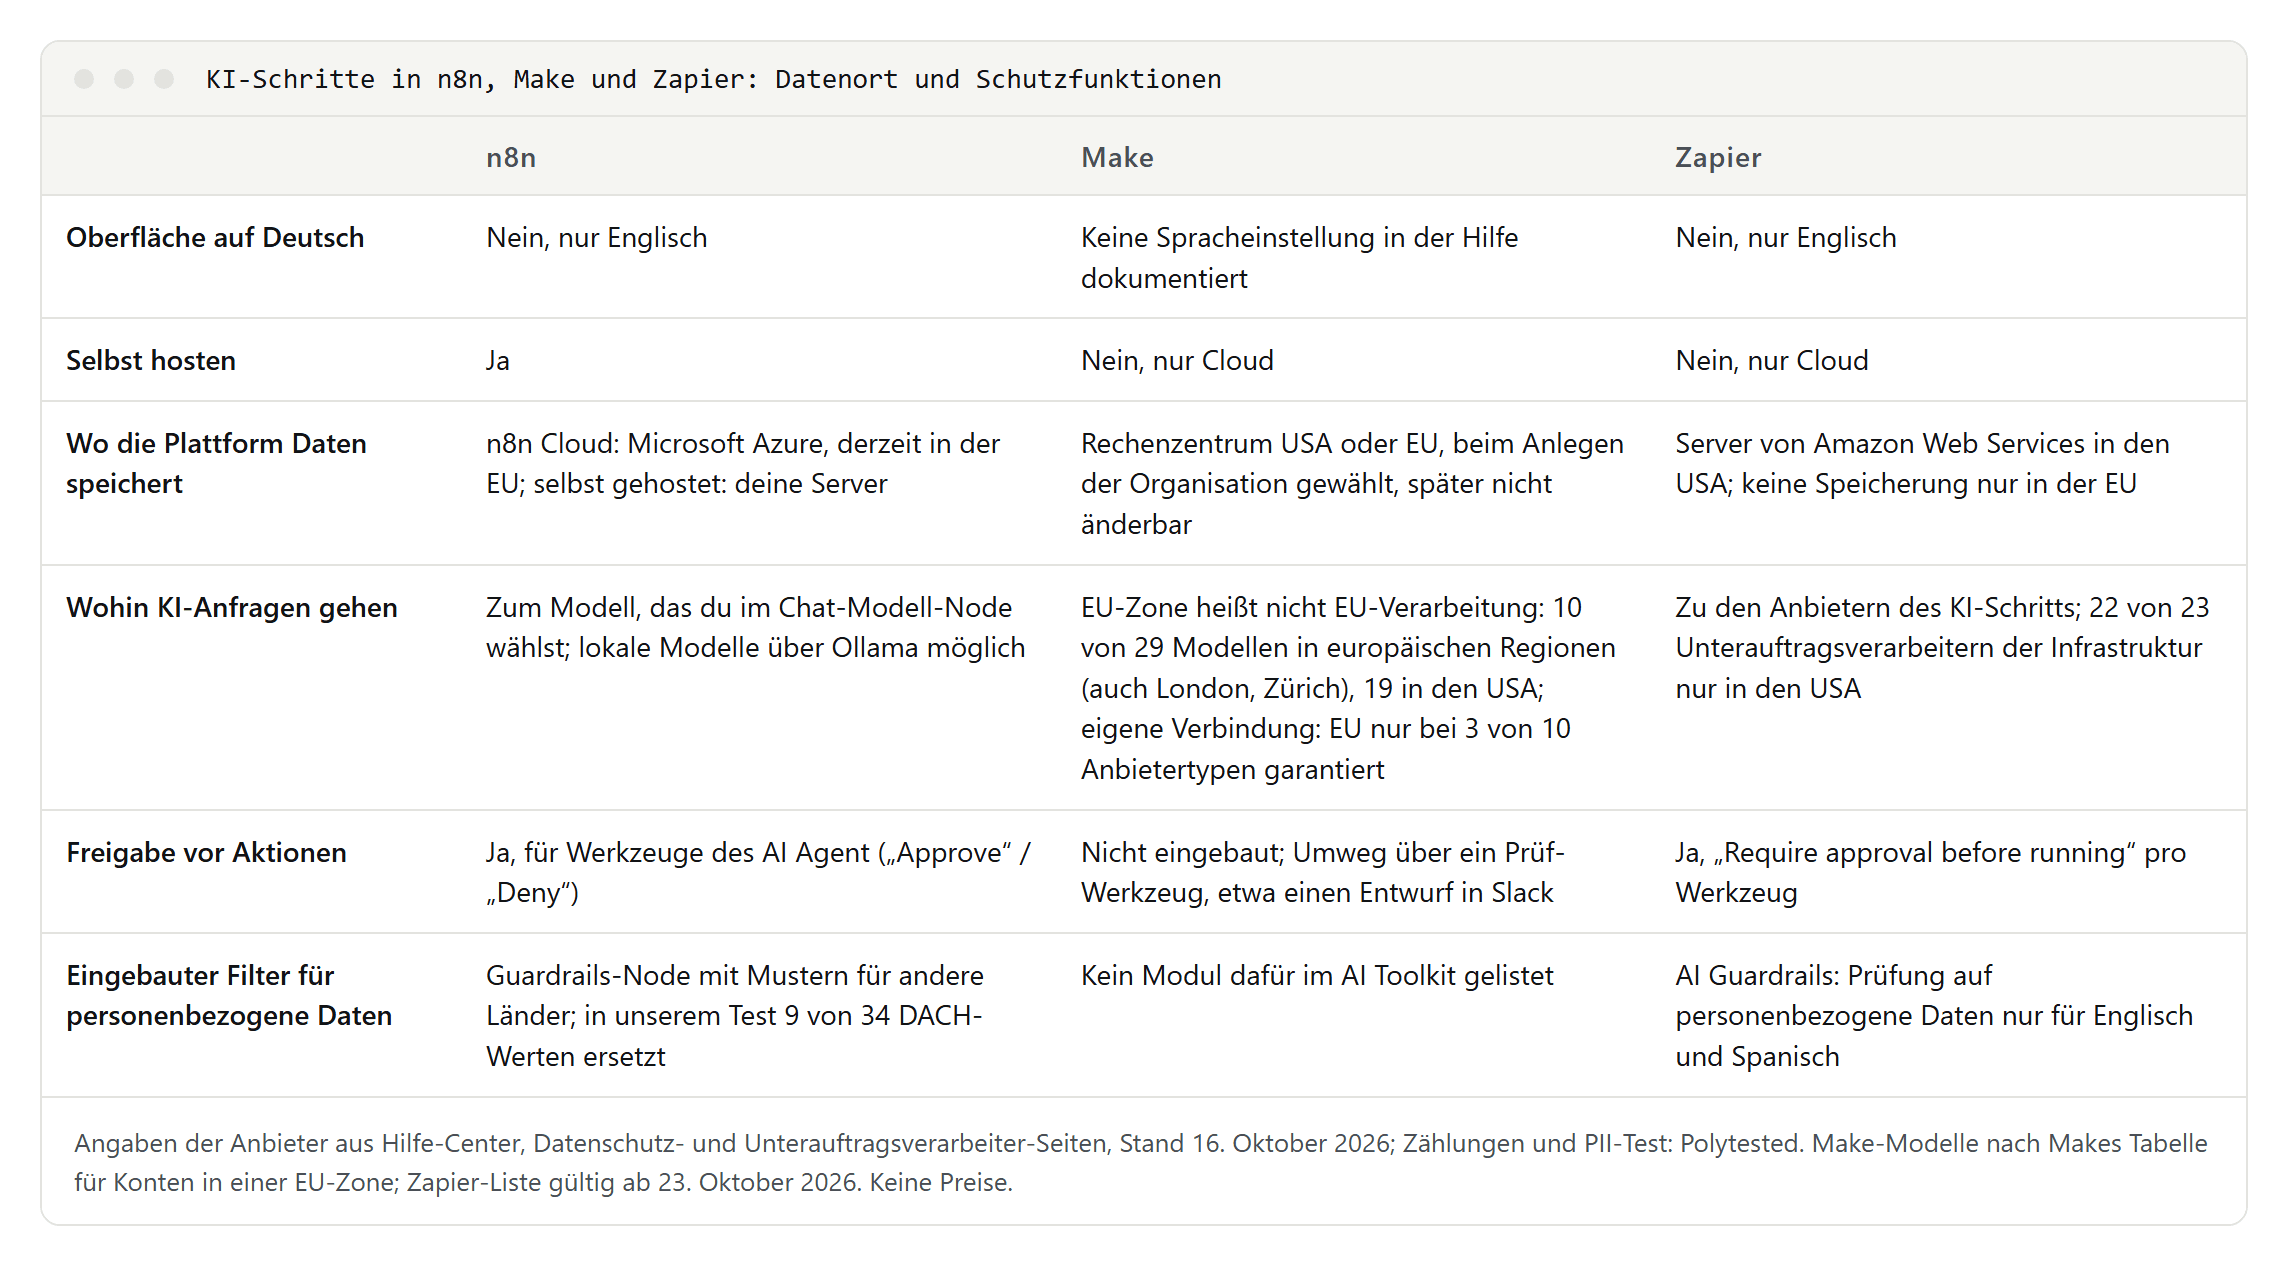
- n8n: n8n Cloud läuft laut n8n auf Microsoft Azure, derzeit in der EU. Selbst gehostet bleiben die Daten auf deiner Infrastruktur. Wohin ein KI-Schritt sie schickt, bestimmt der Chat-Modell-Node, den du wählst.
- Make: Beim Anlegen einer Organisation wählst du ein Rechenzentrum in den USA oder in der EU; ändern lässt es sich danach nicht. Make schreibt aber selbst, dass eine EU-Datenzone nicht automatisch EU-Verarbeitung für KI bedeutet. Maia, die Websuche „Make AI Web Search“ und alle OpenAI-Modelle über Makes eigenen KI-Anbieter laufen immer in den USA. In Makes Modelltabelle haben wir gezählt: Von 29 Modellen werden für Konten in einer EU-Zone 10 in europäischen Regionen verarbeitet, darunter auch London und Zürich außerhalb der EU, und 19 in den USA. Bei eigenen Verbindungen garantiert Make eine Verarbeitung in der EU nur für drei von zehn Anbietertypen. Mehr zu Rechenzentren und Vertrag im Ratgeber zu Integromat und Make.
- Zapier: Daten liegen laut Zapier auf Servern von Amazon Web Services in den USA; eine Speicherung nur in der EU gibt es nicht. Zapier ist nach dem EU-US Data Privacy Framework zertifiziert, auch für Großbritannien und die Schweiz. Von 23 Unterauftragsverarbeitern für die Infrastruktur, Liste gültig ab dem 23. Oktober 2026, sitzen 22 nur in den USA.
Die Kernaussage: Wo ein KI-Schritt deine Daten verarbeitet, entscheiden das Modell und dessen Anbieter, nicht der Standort der Plattform. Was beim Selbsthosten von n8n zu beachten ist, beschreibt unser Ratgeber zu n8n.
Unser Test: Erkennt n8n Personendaten aus Deutschland, Österreich und der Schweiz?
Ein Filter, der persönliche Angaben vor dem KI-Schritt unkenntlich macht, liegt nahe. Wir wollten wissen, wie gut n8ns Guardrails-Node Daten aus dem deutschsprachigen Raum erkennt.
So haben wir getestet: Wir haben den Code des Guardrails-Node aus dem offiziellen npm-Paket von n8n, Version 2.43.7, am 16. Oktober 2026 lokal ausgeführt, im Modus „Sanitize Text“ mit dem Guardrail „PII“ und dem Typ „All“, also allen 36 Datentypen, mit denselben Einstellungen wie in einem Workflow. Ein Modell braucht diese Prüfung nicht. Getestet haben wir 45 Sätze: 34 mit personenbezogenen Daten aus Deutschland, Österreich und der Schweiz, sechs Geschäftszeilen ohne Personenbezug, vier US-Beispiele zur Kontrolle und eine Kunden-E-Mail. Alle Werte sind erfunden, teils nach offiziellen Mustern wie der Musterperson Erika Mustermann und veröffentlichten Beispiel-IBANs.
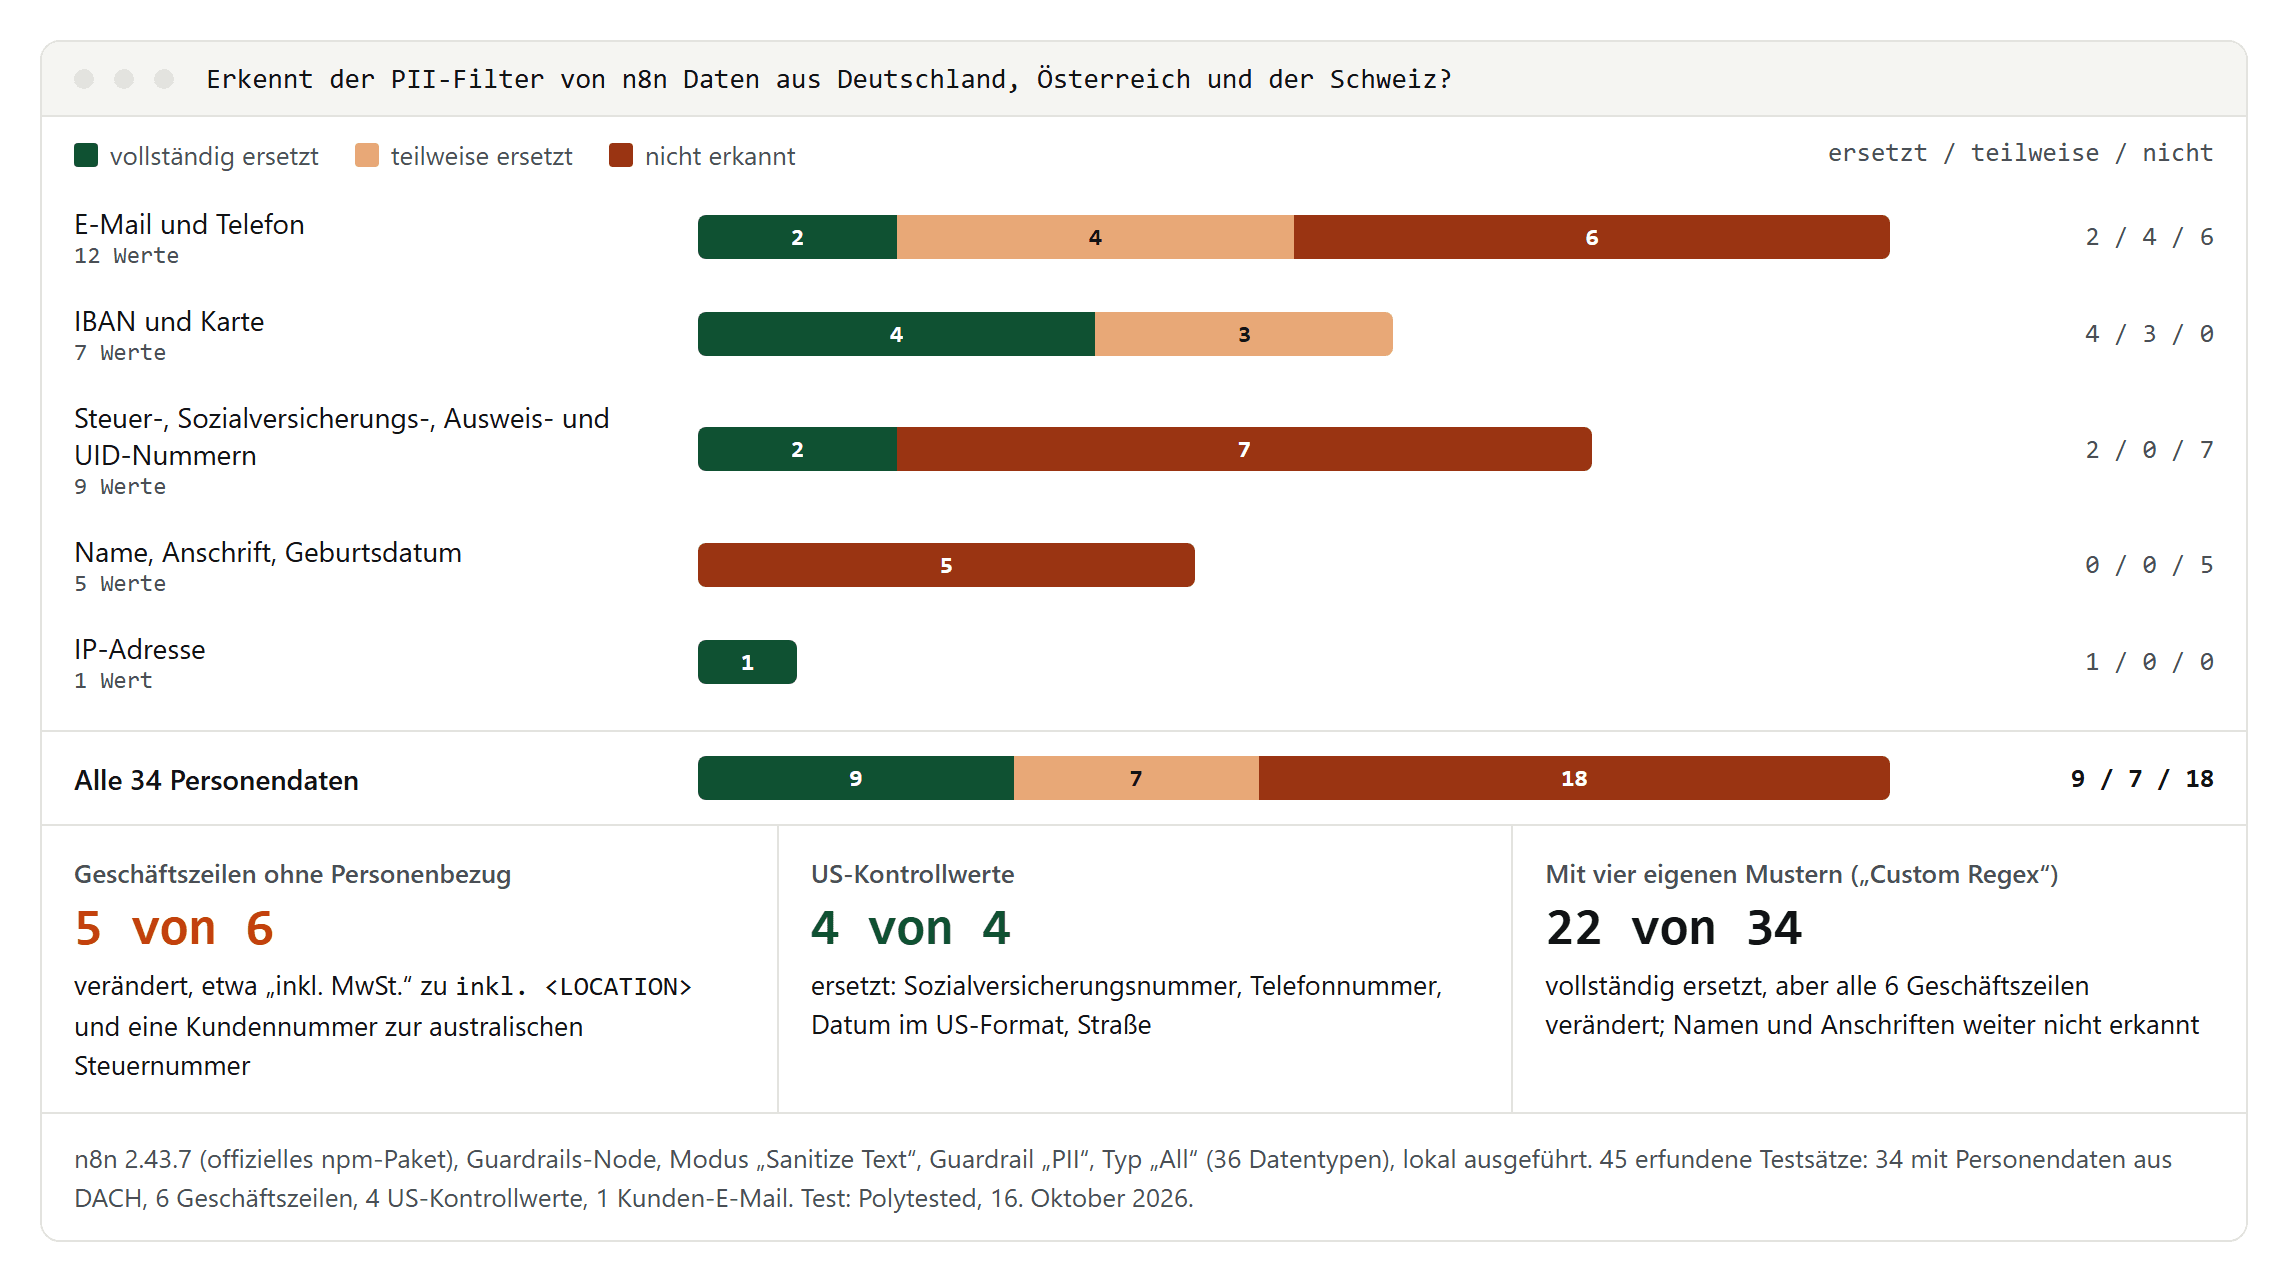
Von 34 Personendaten ersetzte der Filter 9 vollständig, 7 teilweise und 18 gar nicht:
- E-Mail und Telefon: Ersetzt wurden nur eine einfache E-Mail-Adresse und eine Handynummer ohne Leerzeichen. Bei einem Umlaut im Namen blieb der Anfang der Adresse lesbar, eine Domain mit Umlaut erkannte er nicht. Deutsche Festnetz- und Handynummern in der üblichen Schreibweise, eine österreichische Handynummer und beide Schweizer Nummern blieben stehen; bei Nummern mit +49 oder +43 blieben die Vorwahlen teilweise übrig.
- IBAN und Karte: IBANs ohne Leerzeichen und die Testkreditkarte ersetzte er, IBANs mit Leerzeichen nur teilweise: Aus „DE89 3704 0044 0532 0130 00“ wurde
DE89 <CREDIT_CARD> 00. - Steuer-, Sozialversicherungs-, Ausweis- und UID-Nummern: Ersetzt wurden nur Steuer-ID und Ausweisnummer, und zwar durch Platzhalter für eine finnische Personenkennzahl und eine spanische Ausländernummer. Rentenversicherungs- und Krankenversichertennummer, USt-IdNr., die österreichische Sozialversicherungsnummer, die Schweizer AHV-Nummer und die UID-Nummern erkannte er nicht.
- Name, Anschrift, Geburtsdatum: keinen erkannt. IP-Adresse: ersetzt.
Die vier US-Kontrollwerte ersetzte er dagegen alle. Und er veränderte fünf von sechs harmlosen Geschäftszeilen: Eine neunstellige Kundennummer wurde zu <AU_TFN>, einer australischen Steuernummer, eine achtstellige Auftragsnummer zu <US_BANK_NUMBER>. Aus „inkl. MwSt.“ wurde inkl. <LOCATION>, aus „zzgl. USt.“ wurde zzgl. <LOCATION>, aus „Wir liefern nach St. Gallen.“ wurde <LOCATION>. Gallen. Nur die Zeile mit Rechnungsnummer und Fälligkeitsdatum blieb unverändert.
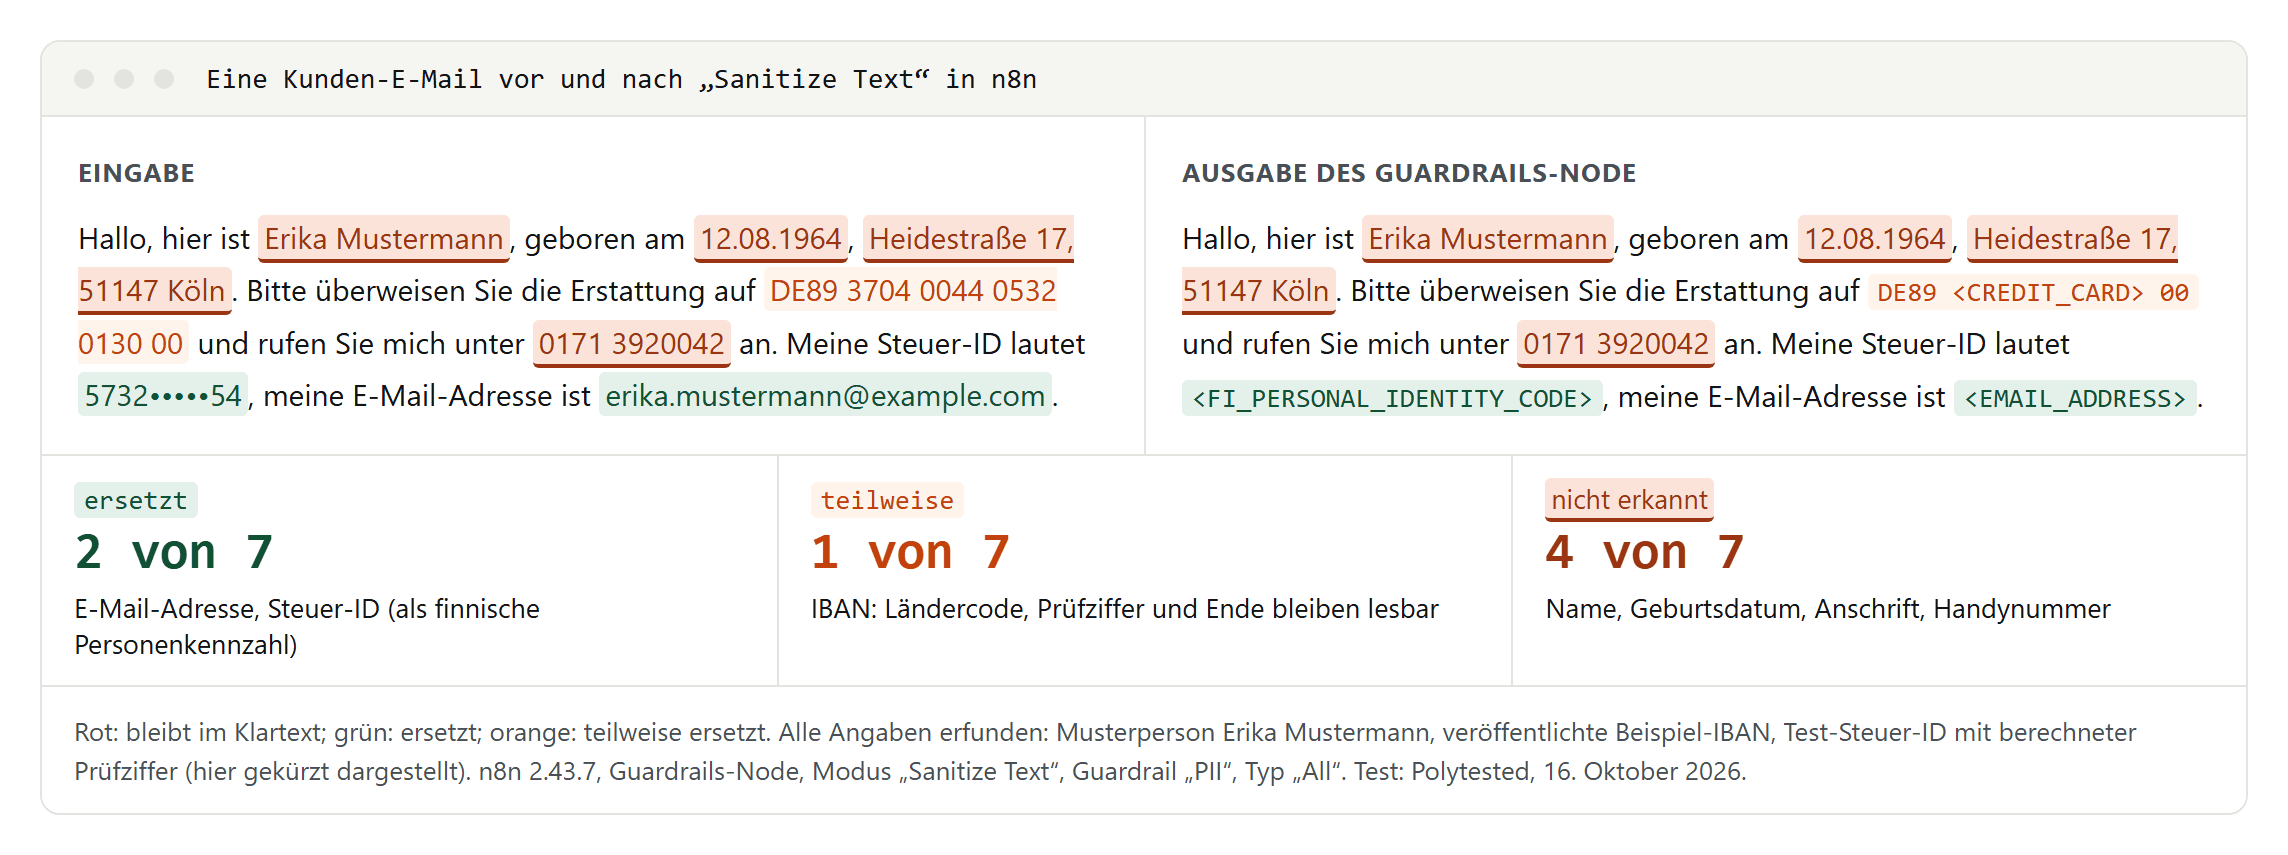
In der Kunden-E-Mail mit sieben persönlichen Angaben ersetzte der Filter zwei vollständig, eine teilweise und vier gar nicht: Name, Geburtsdatum, Anschrift und Handynummer gingen im Klartext weiter.
Warum: Laut Quellcode arbeitet die Prüfung nur mit Mustern, also mit regulären Ausdrücken. Von den 36 Datentypen sind neun allgemein, etwa E-Mail, IBAN und Telefon, 27 gelten für die USA, Italien, Indien, Australien, Großbritannien, Spanien, Singapur, Polen und Finnland, keiner für Deutschland, Österreich oder die Schweiz. Das Telefonmuster erwartet die US-Gliederung, das Datumsmuster den Monat vor dem Tag, das IBAN-Muster die Form ohne Leerzeichen. Das Muster für Orte sucht englische Straßenwörter und Abkürzungen wie „St“ für „Street“, deshalb hielt es „MwSt“, „USt“ und „St. Gallen“ für Adressen.
Mit eigenen Mustern: In einem zweiten Lauf haben wir über „Custom Regex“ vier eigene Muster ergänzt, für IBANs mit Leerzeichen, deutsche Datumsangaben, Telefonnummern aus DACH und die AHV-Nummer. Dann ersetzte der Filter 22 von 34 Werten vollständig, einen teilweise und elf nicht. Namen und Anschriften blieben stehen, ebenso die Sozialversicherungs-, Umsatzsteuer- und UID-Nummern außer der AHV-Nummer. Dafür veränderte er nun alle sechs Geschäftszeilen.
Was du daraus mitnehmen kannst: Ein solcher Filter ist ein Sicherheitsnetz, keine Garantie. Für einfache E-Mail-Adressen, IBANs ohne Leerzeichen, Kartennummern und IP-Adressen funktionierte er zuverlässig, für deutsche Formate ist er nicht gebaut. Teste ihn mit eigenen Beispieldaten, und schick dem KI-Schritt vor allem nur die Felder, die er braucht. Unser Test gilt für diese eine Version und unsere erfundenen Daten; die Prüfungen mit KI-Modell haben wir nicht getestet.
Prompt Injection und falsche Antworten: die Risiken eines KI-Schritts
Das BSI warnte schon 2023 vor indirekten Prompt Injections: Angreifer verstecken Anweisungen in Websites, Dokumenten oder E-Mails, und ein Sprachmodell, das diese Inhalte verarbeitet, führt sie womöglich aus. Das BSI nennt ein Beispiel: Ein Agent soll E-Mails zusammenfassen, eine manipulierte E-Mail enthält den versteckten Befehl, alle künftigen E-Mails an eine fremde Adresse weiterzuleiten, und der Agent tut es.
Wie gefährlich das wird, hängt von den Rechten des Modells ab. Die GI beschreibt die gefährliche Kombination als „Lethal Trifecta“: Werkzeuge, mit denen ein Agent handeln kann, nicht vertrauenswürdige Daten wie E-Mails und Zugriff auf sensible Daten. Dazu kommen falsche Antworten; die DSK verlangt, Ergebnisse mit Personenbezug auf Richtigkeit zu prüfen. Daraus folgen einfache Regeln, angelehnt an die Schutzmaßnahmen des BSI:
- Nur nötige Rechte: Ein KI-Schritt, der eingehende E-Mails liest, sollte nicht zugleich senden, zahlen oder löschen können, jedenfalls nicht ohne feste Regel oder Freigabe dazwischen.
- Wichtige Aktionen bestätigen und Protokolle ansehen, um ungewöhnliche Ausführungen früh zu bemerken.
- Ausgaben prüfen: Eine Regel nach dem KI-Schritt kontrolliert, ob die Felder gefüllt und plausibel sind.
DSGVO: was du vor dem ersten KI-Schritt klären musst
In 16 deutschsprachigen Ratgeber-, Medien- und Anbieterseiten zur intelligenten Automatisierung, die wir gelesen haben, kam Artikel 22 der DSGVO kein einziges Mal vor. Keine Rechtsberatung, aber diese Punkte stehen in der Verordnung und in Leitlinien der Behörden:
- Rechtsgrundlage und Information: Für die Verarbeitung personenbezogener Daten in einer KI-Anwendung und die Übermittlung an deren Anbieter brauchst du laut DSK eine Rechtsgrundlage, und die Betroffenen müssen transparent informiert werden.
- Auftragsverarbeitung (Art. 28): Ein Anbieter, der Daten für dich verarbeitet, muss hinreichende Garantien bieten und braucht einen Vertrag, der unter anderem Gegenstand, Dauer, Zweck und Art der Daten festlegt.
- Datenminimierung (Art. 5 Abs. 1 Buchst. c): nur so viele Daten wie für den Zweck nötig. Laut DSK reicht es oft nicht, Namen und Adressen zu entfernen, weil der Zusammenhang eine Person erkennbar machen kann.
- Drittländer (Art. 44 ff.): Für die USA gibt es seit dem 10. Juli 2023 einen Angemessenheitsbeschluss für Unternehmen, die nach dem Data Privacy Framework zertifiziert sind. Das Gericht der EU hat am 3. September 2025 eine Klage dagegen abgewiesen.
- Training: Prüf laut DSK, ob Ein- und Ausgaben zum Training verwendet werden, und bevorzuge Dienste, die das nicht tun. Bei Zapier sind laut eigener Seite nur Enterprise-Kunden automatisch davon ausgenommen, dass Zapier ihre Inhalte für das Training von Modellen nutzt; alle anderen können widersprechen.
- Folgenabschätzung (Art. 35): nur, wenn voraussichtlich ein hohes Risiko besteht, nicht für jeden KI-Schritt.
Der wichtigste Punkt ist Art. 22: Niemand muss sich einer Entscheidung unterwerfen, die ausschließlich auf automatisierter Verarbeitung beruht und rechtliche Wirkung hat oder ihn ähnlich erheblich beeinträchtigt. Die DSK verlangt, dass der entscheidende Mensch einen echten Spielraum hat; eine nur formale Beteiligung reicht nicht, und Zeitdruck oder Personalmangel dürfen nicht dazu führen, dass KI-Ergebnisse ungeprüft übernommen werden.
Die österreichische Datenschutzbehörde betont, dass die DSGVO neben dem AI Act weiter gilt und der Verantwortliche ihre Einhaltung nachweisen muss. Art. 22 legt sie unter Verweis auf den EuGH weit aus, mit Beispielen wie einem automatisch entschiedenen Online-Kredit.
Schweiz: DSG statt DSGVO
In der Schweiz gilt das Datenschutzgesetz (DSG). Laut dem Eidgenössischen Datenschutz- und Öffentlichkeitsbeauftragten (EDÖB) ist das seit dem 1. September 2023 geltende Gesetz technologieneutral und direkt auf KI anwendbar: Zweck, Funktionsweise und Datenquellen müssen transparent sein, und wer mit einem Sprachmodell kommuniziert, hat ein Recht zu erfahren, ob er mit einer Maschine spricht.
Bei einer automatisierten Einzelentscheidung musst du die betroffene Person nach Art. 21 DSG informieren; auf Verlangen kann sie ihren Standpunkt darlegen und eine Überprüfung durch einen Menschen verlangen, mit Ausnahmen etwa bei ausdrücklicher Einwilligung. Für Übermittlungen in die USA stellt der EDÖB seit dem 15. September 2024 einen angemessenen Schutz fest, wenn das Unternehmen nach dem Swiss-US Data Privacy Framework zertifiziert ist.
Ein eigenes KI-Gesetz hat die Schweiz noch nicht. Der Bundesrat will die KI-Konvention des Europarats übernehmen und Gesetze möglichst nur in einzelnen Sektoren anpassen; einen Entwurf für die Vernehmlassung soll es bis Ende 2026 geben. Der AI Act kann Schweizer Firmen trotzdem treffen: Nach Art. 2 Abs. 1 Buchst. c gilt er für Anbieter und Betreiber aus Drittländern, wenn die Ausgabe ihres KI-Systems in der EU verwendet wird. Keine Rechtsberatung.
EU AI Act: was für kleine Teams gilt
Der AI Act unterscheidet vor allem zwei Rollen. Anbieter entwickeln ein KI-System oder lassen es entwickeln und bringen es unter eigenem Namen auf den Markt oder in Betrieb. Betreiber verwenden ein KI-System in eigener Verantwortung, außer rein privat. Ein Team, das einen KI-Schritt in n8n, Make oder Zapier beruflich nutzt, ist damit in aller Regel Betreiber; wer einen eigenen Chatbot unter eigenem Namen einsetzt, kann auch Anbieter sein.
Am 27. Juli 2026 trat der Digital-Omnibus zur KI in Kraft, die Verordnung (EU) 2026/1744, und verschob mehrere Termine. Viele Übersichten zeigen noch die alten Daten, selbst maschinell übersetzte Fassungen offizieller Seiten mischen alte und neue. Die Fristen nach der englischen Zeitleiste des AI Act Service Desk der EU-Kommission:
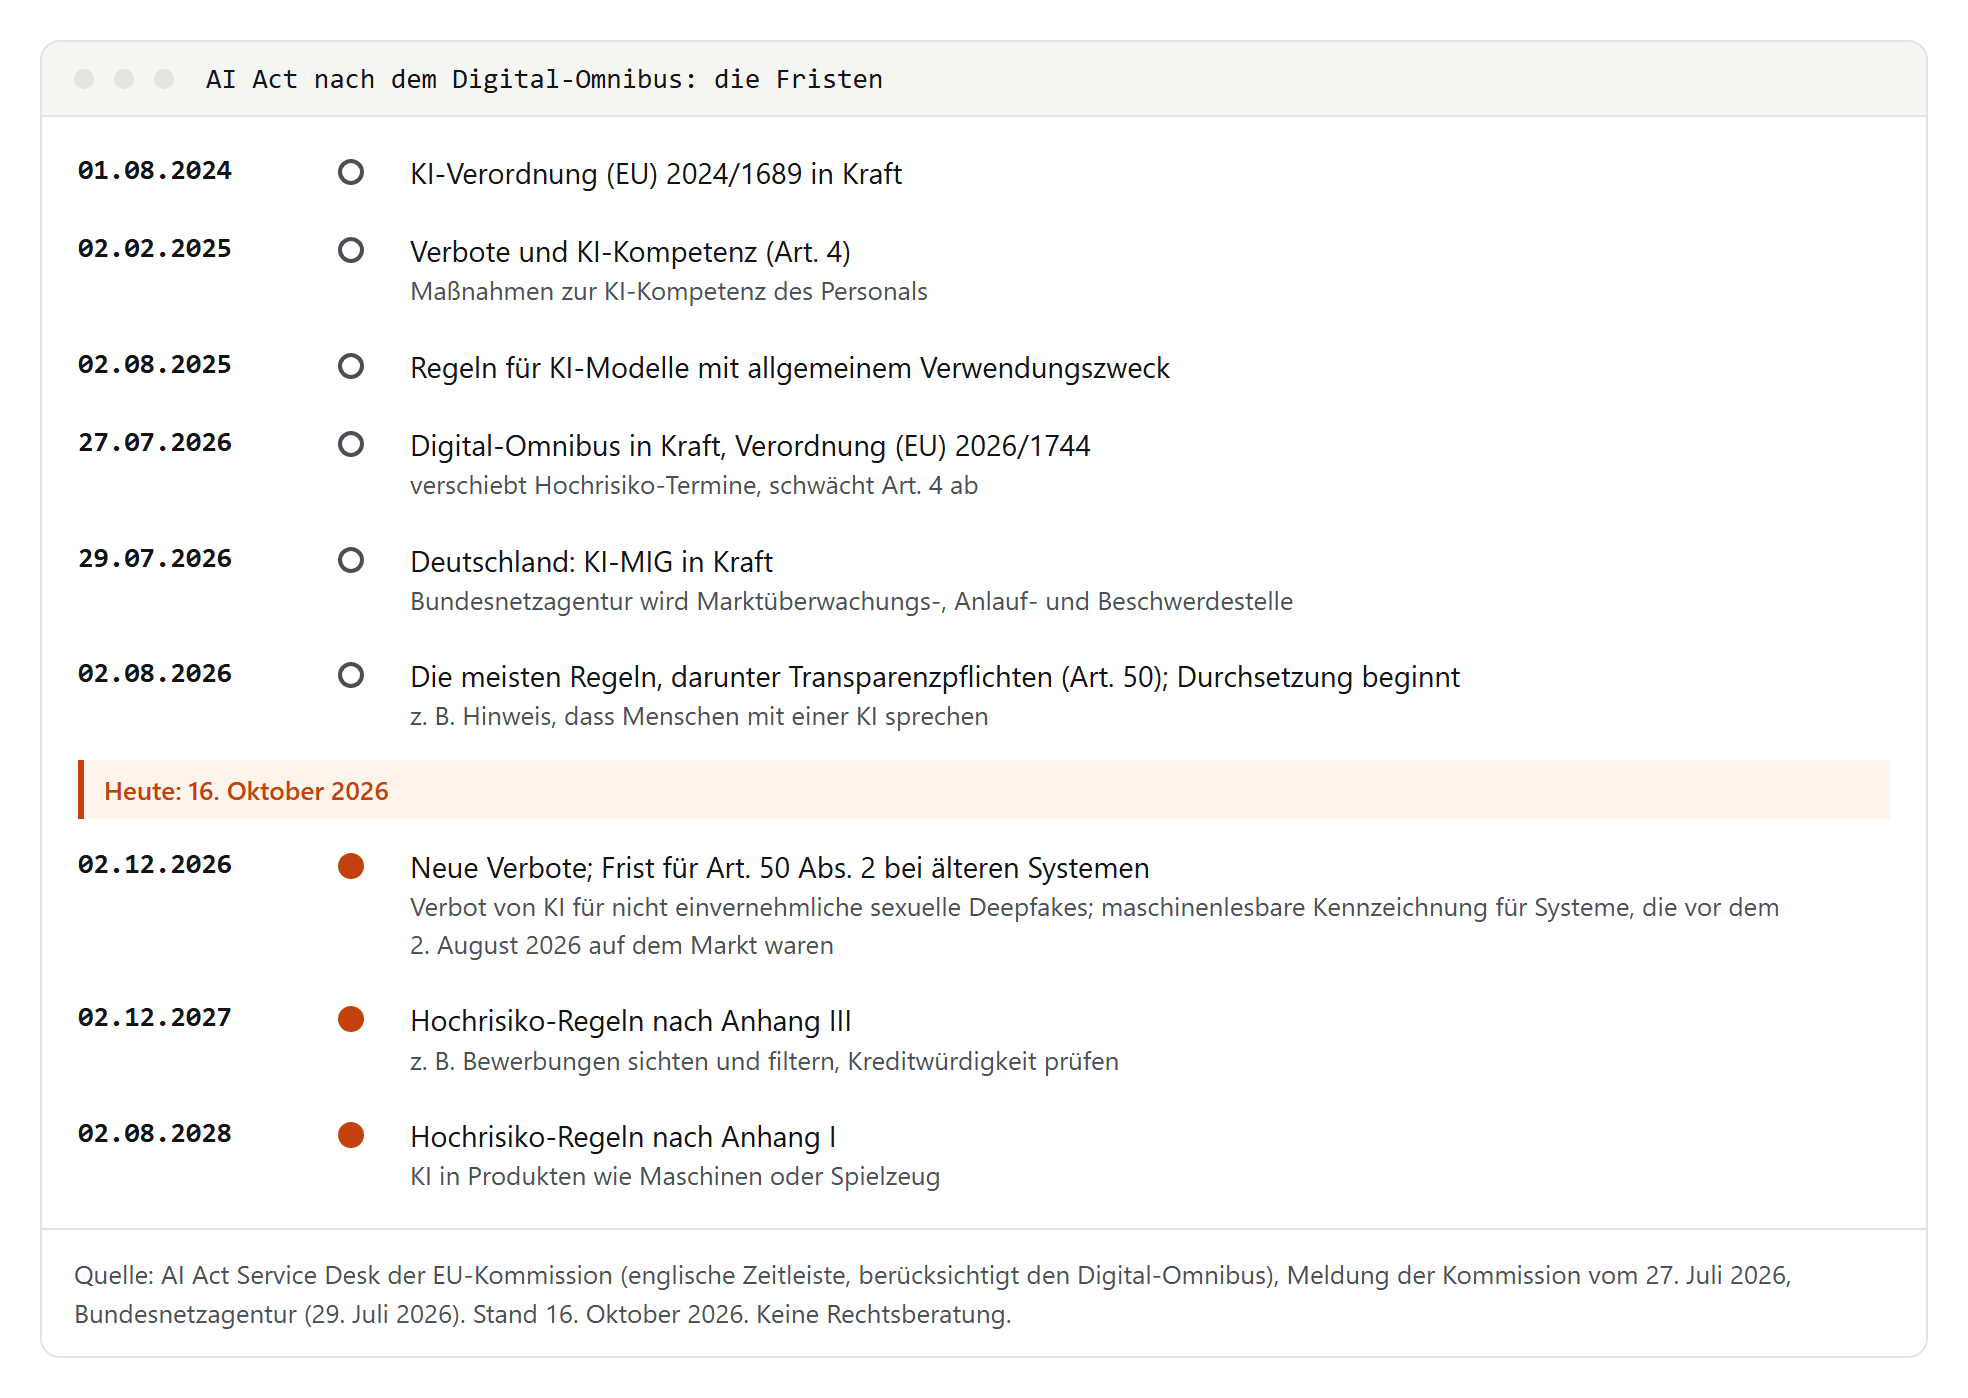
- KI-Kompetenz (Art. 4): gilt seit dem 2. Februar 2025 und ist seit dem Omnibus abgeschwächt. Anbieter und Betreiber ergreifen Maßnahmen, um die KI-Kompetenz ihres Personals zu fördern; ein bestimmtes Niveau für jede Person müssen sie ausdrücklich nicht garantieren. Laut der österreichischen KI-Servicestelle der RTR verlangt Art. 4 keinen „KI-Beauftragten“, und der AI Act sieht dafür keine Verwaltungsstrafe vor; fehlende Schulungen können aber bei der Haftung zählen. Die RTR empfiehlt, die Umsetzung zu dokumentieren, etwa mit einer internen KI-Richtlinie und einem Schulungskonzept.
- Transparenz (Art. 50): gilt seit dem 2. August 2026. Anbieter müssen KI-Systeme, die direkt mit Menschen sprechen, so gestalten, dass die Menschen spätestens bei der ersten Interaktion erfahren, dass sie mit einer KI zu tun haben, sofern das nicht offensichtlich ist. Betreiber müssen Deepfakes offenlegen und KI-erzeugte Texte, die die Öffentlichkeit über Fragen von öffentlichem Interesse informieren sollen, außer jemand hat sie redaktionell geprüft und trägt die Verantwortung.
- Emotionserkennung: Gemeint sind laut Definition Systeme, die Emotionen aus biometrischen Daten ableiten. Eine Stimmungsanalyse, die nur den Text einer E-Mail bewertet, beruht nach unserer Lesart nicht auf solchen Daten.
In Deutschland trat am 29. Juli 2026 das KI-Marktüberwachungsgesetz (KI-MIG) in Kraft. Die Bundesnetzagentur ist damit Marktüberwachungsbehörde, etwa für bestimmte KI im Personalbereich, außerdem zentrale Anlaufstelle und Beschwerdestelle. Ihr KI-Service-Desk unter bundesnetzagentur.de/ki bietet gerade kleinen Firmen ein Online-Werkzeug zur ersten Einschätzung der Risikoklasse und Hinweise zum Aufbau von KI-Kompetenz. Keine Rechtsberatung.
Sonderfall Bewerbungen und Personal
Der AI Act zählt in Anhang III KI-Systeme zur Einstellung und Auswahl als hochriskant, ausdrücklich auch das Sichten und Filtern von Bewerbungen und das Bewerten von Bewerbern, ebenso Entscheidungen über Beförderung, Kündigung und Aufgabenverteilung. Diese Regeln gelten seit dem Omnibus ab dem 2. Dezember 2027. Betreiber müssen dann nach Art. 26 unter anderem die menschliche Aufsicht kompetenten Personen übertragen, automatisch erzeugte Protokolle mindestens sechs Monate aufbewahren und als Arbeitgeber die Beschäftigten und ihre Vertretung vorab informieren.
Die DSGVO setzt schon heute eine Grenze: Die DSK nennt als Beispiel für einen Verstoß gegen Art. 22 eine KI-Anwendung, die alle Bewerbungen auswertet und selbst die Einladungen zum Vorstellungsgespräch verschickt.
Make führt unter seinen Beispiel-Agenten einen für die Vorauswahl von Bewerbern: Er gleicht Lebensläufe mit den Anforderungen ab und gibt eine Einschätzung an die Personalverantwortlichen weiter, die Entscheidung bleibt beim Menschen. Zugleich rät Make, Agenten von sensiblen Daten, folgenreichen Entscheidungen und Aufgaben mit strengen rechtlichen Vorgaben fernzuhalten. Lass die KI im Bewerbungsprozess deshalb keine Person bewerten, solange du nicht geklärt hast, welche Pflichten dann für dich gelten. Keine Rechtsberatung.
So startest du: acht Schritte zur ersten intelligenten Automatisierung
- Einen Ablauf auswählen: eine Aufgabe mit unordentlicher Eingabe, die jemand jede Woche von Hand erledigt.
- Erst ohne KI bauen: Auslöser, feste Schritte und Ausgabe zum Laufen bringen.
- Einen KI-Schritt ergänzen: dort, wo Lesen oder Urteilen nötig ist, mit festen Feldern als Ausgabe.
- Nur nötige Daten schicken: der KI nur die Felder geben, die sie für die Aufgabe braucht.
- Den Filter testen: einen Filter für personenbezogene Daten mit erfundenen Beispieldaten prüfen, bevor du dich auf ihn verlässt.
- Eine Sperre vor dem Ausgang: eine Regel oder menschliche Freigabe vor allem, was nach außen geht oder sich nicht rückgängig machen lässt.
- Anbieter klären: Welches Modell, welche Region, welcher Auftragsverarbeitungsvertrag, wird mit den Daten trainiert?
- Schulung festhalten: aufschreiben, wer im Team wie geschult wurde und welche Regeln für KI gelten.
Lass den Ablauf danach einige Wochen laufen und zähl, wie oft jemand korrigieren muss. Erst wenn das gut funktioniert, lohnt der Gedanke an einen Agenten.
